Klasifikasikan risiko kredit dengan Rimay Quantum Feature Extraction milik Kipu Quantum
Qiskit Functions adalah fitur eksperimental yang hanya tersedia untuk pengguna IBM Quantum® Premium Plan, Flex Plan, dan On-Prem (melalui IBM Quantum Platform API) Plan. Fitur ini berstatus rilis pratinjau dan dapat berubah.
Perkiraan penggunaan: 2 menit pada prosesor Nighthawk r2. (CATATAN: Ini hanya perkiraan. Waktu eksekusimu mungkin berbeda.)
Hasil pembelajaran
-
Menyiapkan data tabular dengan kolom kategorikal dan numerik untuk Qiskit Function Rimay.
-
Melakukan fit pemetaan fitur kuantum pada data latih dan memetakan data uji dalam run yang sama.
-
Melatih model klasik pada fitur hasil transformasi kuantum, sendiri maupun digabung dengan fitur asli.
-
Membandingkan hasilnya dengan baseline yang murni klasik.
Prasyarat
Sebelum memulai tutorial ini, kamu sebaiknya sudah familier dengan topik-topik berikut:
-
Klasifikasi terawasi dengan scikit-learn
Latar belakang
Banyak masalah machine learning di industri melibatkan dataset tabular berukuran kecil sampai menengah, di mana menambah data bukan pilihan dan akurasi model mentok. Penilaian risiko kredit adalah contoh khasnya. Pemberi pinjaman memakai beberapa lusin atribut untuk memutuskan apakah pemohon kemungkinan akan melunasi kreditnya.
Rimay, sebuah Qiskit Function dari Kipu Quantum, menambahkan langkah prapemrosesan kuantum ke pipeline seperti itu. Ia mengimplementasikan algoritma ekstraksi fitur kuantum counterdiabatic yang didigitalisasi [1]. Setiap fitur input dipetakan ke satu qubit. Nilai fitur dan informasi mutual antar fitur menentukan medan lokal dan kopling dari Hamiltonian spin-glass. Dinamika counterdiabatic lalu mengevolusikan sistem kuantum menuju keadaan berenergi rendahnya, dan nilai ekspektasi satu- dan dua-benda yang diukur di akhir menjadi fitur baru hasil transformasi kuantum. Fitur-fitur ini menangkap korelasi nonlinear antar input, dan kamu bisa memasukkannya ke model klasik apa pun.
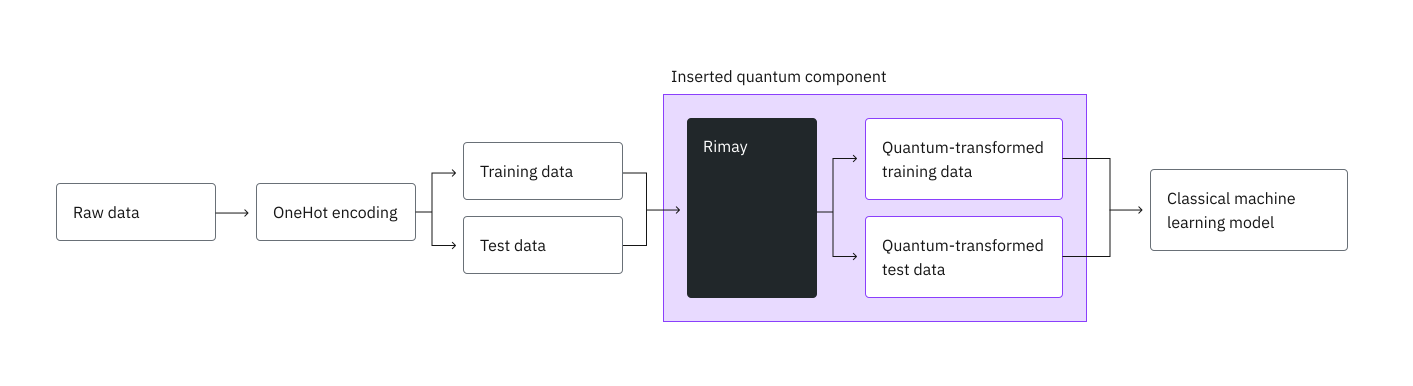
Tutorial ini memakai dataset kredit Jerman dari OpenML [2], dengan 1000 pemohon dan 20 atribut, untuk melatih pengklasifikasi random forest. Pertama kamu membuat baseline klasik, lalu mengirim data ke Rimay, dan akhirnya melatih jenis model yang sama pada fitur hasil transformasi kuantum, sendiri maupun digabung dengan fitur asli.
Persyaratan
Sebelum memulai tutorial ini, pastikan kamu sudah menginstal paket-paket berikut:
-
Klien IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Kamu juga butuh akses ke fungsi Rimay dari Qiskit Functions Catalog.
Penyiapan
Impor paket-paketnya dan definisikan dua fungsi bantu: satu untuk melatih random forest, dan satu lagi untuk menghitung metrik yang dipakai di sepanjang tutorial ini.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Konfigurasi kredensial IBM Quantum
Lakukan autentikasi dengan IBM Quantum Platform API key kamu, muat fungsi Rimay, lalu pilih prosesor kuantum paling sepi antrean yang tersedia untuk instance kamu.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Langkah 1: Petakan input klasik ke masalah kuantum
Rimay memetakan setiap fitur input numerik ke satu qubit, jadi langkah pertama adalah mengubah tabel mentah menjadi fitur numerik.
Muat dataset
Muat dataset German credit langsung dari OpenML. Kolom class berisi label: good untuk pemohon yang melunasi kreditnya dan bad untuk yang tidak.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Encode fitur
Ubah label menjadi nilai biner, dan lakukan one-hot encoding pada 13 kolom kategorikal. Kodenya membuang kategori pertama dari tiap kolom untuk menghindari fitur yang redundan, sehingga menghasilkan 48 fitur numerik.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Pisahkan menjadi set pelatihan dan set uji
Sisihkan 20% pemohon sebagai set uji. Pemisahan bertingkat (stratified) menjaga proporsi kredit baik dan buruk tetap sama di kedua set.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Buat baseline klasik
Latih random forest pada fitur klasik. Di Langkah 4, kamu akan membandingkan fitur hasil transformasi kuantum dengan metriknya.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Unggah data ke Rimay
Rimay membaca inputnya dari file CSV yang kamu unggah ke fungsi tersebut. Fitur dan label disimpan di file terpisah. Kamu juga mengunggah set uji, supaya Rimay memetakannya dengan pemetaan yang sama dengan yang di-fit pada set pelatihan.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Langkah 2: Optimalkan masalah untuk eksekusi di hardware kuantum
Rimay membangun dan men-transpile circuit untuk prosesor yang kamu pilih, jadi tidak ada circuit yang perlu dioptimalkan secara manual. Tentukan jumlah shot per circuit, dengan batasan berikut:
-
Setiap fitur butuh satu qubit, jadi prosesor harus punya qubit paling tidak sebanyak jumlah fitur dalam dataset.
-
Rimay menjalankan satu circuit per baris, baris pelatihan dan uji digabung. Satu job dapat meminta paling banyak 10 juta eksekusi, jadi jumlah baris dikali
shotsharus tetap dalam batas tersebut.
Periksa kedua batas ini sebelum kamu mengirim job.
Sebuah job juga harus selesai dalam 24 jam, termasuk waktu circuit-nya menunggu di antrean, atau job itu dihentikan tanpa hasil.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Hitung ukuran fungsi
Setiap job berjalan pada ukuran fungsi tertentu, S, M, atau L, yang menentukan sumber daya komputasi yang dipakai. Untuk Rimay, ukurannya bergantung pada jumlah baris yang dipetakan sebuah job, baris pelatihan dan uji digabung. Jika kamu meminta ukuran yang terlalu kecil, job akan gagal dengan error 4600. Untuk ukuran beserta batasnya, lihat Function sizes di panduan Rimay.
Sel berikut mendefinisikan kalkulator ukuran. Kalkulator ini berjalan di mesinmu, hanya membaca data yang kamu berikan, dan tidak mengirim apa pun.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Berikan set data dengan urutan yang sama seperti file di input_file, beserta mode jalannya:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Langkah 3: Eksekusi menggunakan Qiskit primitives
Jalankan Rimay dalam mode fit-transform. Rimay mem-fit pemetaan fitur kuantum pada x_train.csv dan y_train.csv, lalu memetakan set pelatihan maupun set uji dengannya. Urutan file di input_file itu penting. Urutkan fitur pelatihan, label pelatihan, lalu fitur uji (opsional). Berikan ukuran yang tadi kamu hitung sebagai function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Pantau job
Periksa status job selagi berjalan. job.result() akan menunggu sampai job selesai.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Hasilnya berisi mapping_id, yang mengidentifikasi pemetaan yang di-fit oleh run ini. Kamu tidak membutuhkannya di tutorial ini, karena set uji sudah dipetakan dalam run yang sama. Simpan ID ini kalau kamu ingin memetakan baris baru nanti dengan mode="transform". Ini satu-satunya cara untuk mengakses pemetaan yang sudah di-fit, dan tanpanya, kamu harus melakukan fit lagi dan membayar untuk pemetaan baru. Pemetaan ini dibangun untuk tata letak qubit prosesor ini, jadi run transform berikutnya harus memakai backend_name yang sama.
mapping_id = result["mapping_id"]
Langkah 4: Pasca-proses dan kembalikan hasil dalam format klasik yang diinginkan
Unduh fitur hasil transformasi kuantum
Unduh file yang ditulis oleh job, dengan memakai nama di output_files. Setiap nama diawali dengan ID job, sehingga file dari run ini tetap tersedia setelah run berikutnya. Berikan target_name supaya tiap file disimpan dengan namanya sendiri.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Latih pada fitur hasil transformasi kuantum
Latih random forest hanya pada fitur hasil transformasi kuantum.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Latih pada gabungan fitur klasik dan kuantum
Gabungkan fitur asli dan fitur hasil transformasi kuantum, lalu latih model yang sama pada gabungan tersebut.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Bandingkan hasilnya
Bandingkan ketiga model pada set uji.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

AUC mengukur seberapa baik model meranking kredit baik di atas kredit buruk, terlepas dari ambang keputusan, sehingga menjadi metrik paling informatif pada dataset yang tidak seimbang ini (70% kredit baik). Dalam benchmark Kipu Quantum, fitur hasil transformasi kuantum saja mencapai AUC yang mirip dengan baseline klasik, dan model hibrida, yang menggabungkan keduanya, mencapai AUC dan skor F1 tertinggi. Jadi, fitur hasil transformasi kuantum menambahkan informasi yang tidak disediakan oleh fitur klasik saja.
Bersih-bersih (opsional)
Pemetaan yang sudah di-fit tetap tersedia sampai kamu menghapusnya. Kalau kamu tidak ingin memetakan data lain dengannya, hapus saja. Penghapusan tidak melakukan kerja kuantum, tidak memakai waktu QPU, dan tidak bisa dibatalkan.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Kesimpulan
Yang sudah kamu capai
Di tutorial ini, kamu telah melakukan hal-hal berikut:
-
Menyiapkan dataset risiko kredit dunia nyata dengan atribut kategorikal dan numerik untuk ekstraksi fitur kuantum.
-
Membuat baseline random forest klasik.
-
Memakai Rimay untuk mem-fit pemetaan fitur kuantum pada hardware kuantum dan memetakan set pelatihan dan uji dalam satu run.
-
Melatih model yang sama pada fitur hasil transformasi kuantum dan pada fitur gabungan, lalu membandingkannya dengan baseline.
Poin penting
-
Rimay masuk ke pipeline machine learning yang sudah ada sebagai satu langkah prapemrosesan tambahan. Persiapan datamu dan model klasikmu tetap dipakai.
-
Jumlah qubit membatasi jumlah fitur input, dan jumlah baris dikali
shotsmembatasi ukuran satu job. -
Pakai fitur hasil transformasi kuantum yang digabung dengan fitur asli sebagai default, karena model bisa memanfaatkan keduanya.
Langkah selanjutnya
- Baca panduan Rimay untuk mempelajari semua input, memetakan data baru dengan
mode="transform", dan melihat benchmark lainnya. - Baca bagaimana ekstraksi fitur kuantum diterapkan pada klasifikasi citra satelit [3].
Referensi
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.