Rimay Quantum Feature Extraction - Qiskit Function dari Kipu Quantum
Lihat referensi API.
Qiskit Functions adalah fitur eksperimental yang hanya tersedia untuk pengguna IBM Quantum® Premium Plan, Flex Plan, dan On-Prem (melalui IBM Quantum Platform API) Plan. Fitur ini berstatus rilis preview dan dapat berubah.
Ringkasan
Rimay memperkaya pipeline machine learning klasik dengan fitur yang dihasilkan di hardware kuantum. Function ini menerima data tabular klasik dan mengembalikan sekumpulan fitur hasil transformasi kuantum. Saat sistem kuantum memproses data, ia menghasilkan fitur kaya yang menangkap hubungan nonlinear antar input. Kamu bisa memakai fitur yang dihasilkan itu sendiri, atau digabung dengan fitur aslimu, untuk melatih model klasik apa pun. Pada dataset berukuran kecil dan menengah, fitur hasil transformasi kuantum bisa meningkatkan kualitas prediksi dibandingkan baseline yang murni klasik.
Function ini dibuat untuk pengguna berikut:
-
Tim data science yang sudah punya pipeline machine learning pada dataset tabular berukuran kecil dan menengah, di mana kualitas prediksi sudah mentok. Kamu menambahkan Rimay sebagai satu langkah preprocessing tambahan, tanpa perlu membangun circuit kuantum sendiri.
-
Peneliti yang mengeksplorasi metode kuantum untuk tugas machine learning.
Deskripsi
Algoritma quantum feature extraction [1] menggabungkan dua prinsip quantum machine learning. Yang pertama adalah quantum feature map, yang menanamkan data ke ruang Hilbert berdimensi tinggi sehingga menghasilkan representasi yang lebih ekspresif. Yang kedua adalah quantum reservoir computing, yang memakai dinamika sistem many-body kuantum sebagai transformasi nonlinear dari input.
Rimay menyandikan nilai fitur dan mutual information antar fitur ke dalam medan lokal dan koefisien kopling dari Hamiltonian spin-glass. Dinamika kuantum counterdiabatic mengevolusikan sistem menuju keadaan berenergi rendahnya, yang memuat campuran nonlinear dari korelasi pada data input. Rimay mengekstrak korelasi ini dengan mengukur nilai ekspektasi satu-benda dan dua-benda. Nilai ekspektasi itulah fitur hasil transformasi kuantum yang kamu masukkan ke model machine learning-mu.
Alur kerja
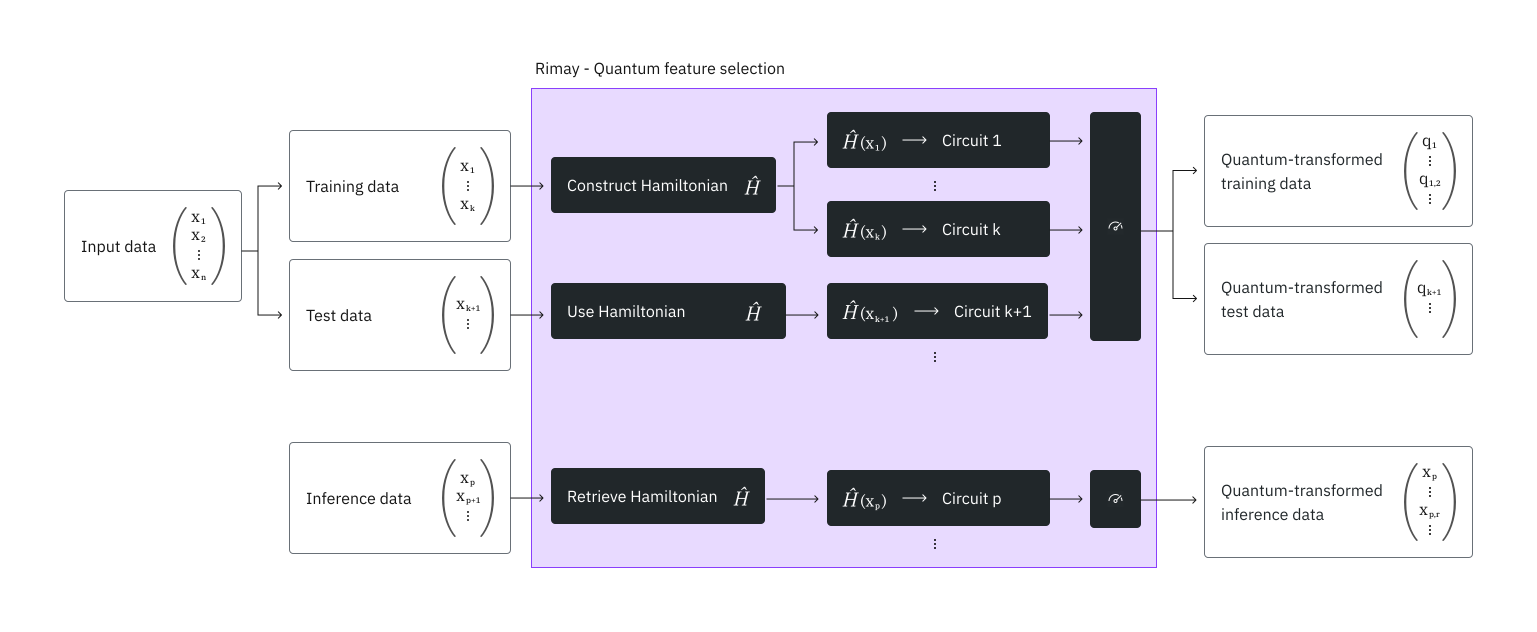
-
Lakukan preprocessing data tabularmu seperti untuk machine learning klasik. Rimay membutuhkan fitur numerik, jadi ubah fitur kategorikal menjadi numerik, misalnya dengan
OneHotEncoderdari scikit-learn. -
Pisahkan data menjadi training set dan test set, lalu unggah keduanya ke function, seperti yang ditunjukkan di bagian Contoh.
-
Rimay memakai data training untuk membangun Hamiltonian yang merepresentasikan data. Setiap fitur sesuai dengan satu qubit, dan seluruh training set menentukan fitur mana, dan karena itu qubit mana, yang berinteraksi. Rimay menyimpan struktur ini supaya bisa memetakan data test dan data inferensi berikutnya dengan Hamiltonian yang sama.
-
Untuk setiap sampel, nilai fitur menentukan medan lokal Hamiltonian, dan mutual information antar fitur menentukan koefisien kopling dari struktur pada langkah 3. Rimay mendigitalkan evolusi counterdiabatic Hamiltonian ini menjadi circuit, lalu menjalankan circuit tersebut di QPU.
-
Rimay mengukur bitstring yang dihasilkan, lalu menghitung nilai ekspektasi satu-benda dan nilai ekspektasi dua-benda dari qubit yang terkopel secara fisik.
-
Kamu mengunduh nilai ekspektasi dalam bentuk yang bisa langsung dimasukkan ke modelmu, atau digabung dengan fitur aslimu.
Karena struktur ini, jumlah qubit yang dibutuhkan sebuah run sama dengan jumlah fitur, dan jumlah circuit yang dikirimkannya sama dengan jumlah sampel.
Setelah kamu melakukan fit pada sebuah mapping, kamu bisa memetakan data baru lewat mapping itu, misalnya untuk inferensi. Rimay lalu mengambil Hamiltonian yang dibuatnya selama fit dan membangun circuit untuk sampel baru dari Hamiltonian tersebut.
Integrasikan Rimay ke pipeline machine learning kamu
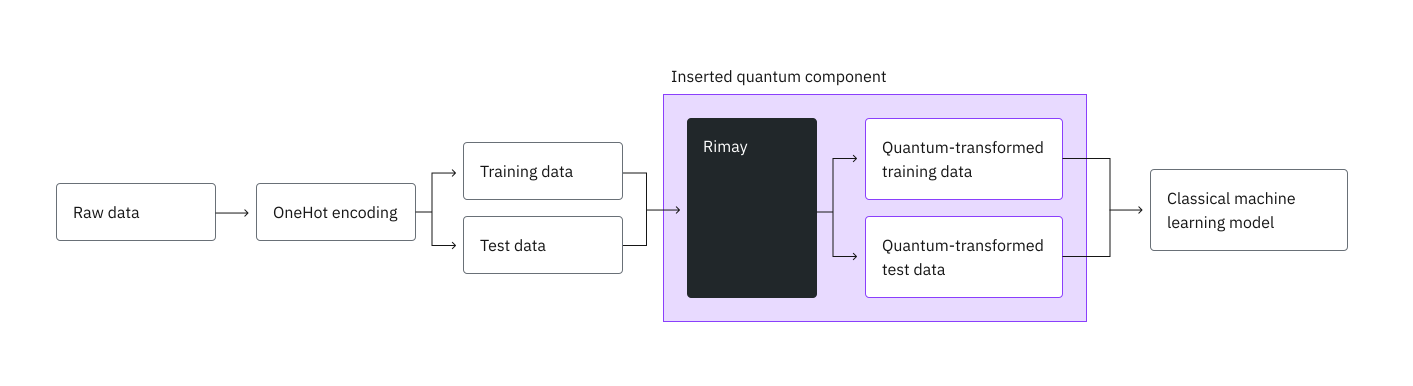
Seperti di pipeline klasik, kamu mulai dengan melakukan praproses pada data mentah, misalnya dengan one-hot encoding pada fitur kategorikal, lalu membaginya menjadi set pelatihan dan set pengujian. Alih-alih langsung memasukkan kedua set ke modelmu, kamu memasukkannya ke Rimay dulu, lalu melatih modelmu dengan fitur hasil transformasi kuantum.
Benchmark
Kipu Quantum melakukan benchmark Rimay pada dataset German credit dari OpenML [2], yang mengklasifikasikan 1000 pemohon kredit sebagai berisiko kredit baik atau buruk. Dataset ini punya 13 atribut kategorikal dan tujuh atribut numerik. One-hot encoding pada atribut kategorikal menghasilkan 48 fitur numerik. Benchmark menyisihkan 20% sampel sebagai set pengujian.
Sebagai baseline, beberapa model klasik dilatih pada fitur klasik. Dengan Rimay, sebuah random forest dilatih dengan dua cara: hanya pada fitur hasil transformasi kuantum (Random forest Q), dan pada fitur hasil transformasi kuantum yang digabung dengan fitur klasik (Random forest H, untuk hybrid). Tabel hanya melaporkan random forest, karena model ini berkinerja paling baik pada fitur hasil transformasi kuantum.
| Model | Fitur | Akurasi | AUC | Skor F1 | Presisi | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Klasik | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Klasik | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Klasik | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Klasik | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Kuantum | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybrid | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Fitur hybrid meningkatkan semua metrik random forest kecuali presisi, dan random forest hybrid mencapai AUC, skor F1, dan recall yang lebih tinggi daripada CatBoost pada fitur klasik. Efek terbesar ada pada recall, yang naik dari 0.921 menjadi 0.957. Fitur hasil transformasi kuantum saja tidak mencapai presisi model klasik.
Set pengujian hanya berisi 200 sampel, jadi satu sampel tambahan yang diprediksi dengan benar menggeser akurasi sebesar 0.005. Anggap selisih ini sebagai tren yang perlu diverifikasi lebih lanjut, bukan efek yang signifikan. Akurasi prediksi juga bisa bergantung pada noise akibat perangkat keras pada fitur yang diekstrak. Karena itu, gunakan shot yang cukup supaya shot noise tidak membatasi hasil.
Benchmark menggunakan sumber daya berikut:
| Contoh | Jumlah qubit | Jumlah sampel | Jumlah shot | Total waktu (menit) | Penggunaan QPU (menit) | Prosesor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Jumlah sampel, yang sama dengan jumlah circuit, menentukan waktu QPU. Gunakan tipe prosesor Nighthawk r2, karena tipe ini sangat mengurangi waktu QPU yang dibutuhkan.
Input
mode menentukan parameter apa saja yang dibutuhkan sebuah run. Untuk deskripsi setiap parameter input, lihat referensi API.
File input
-
Unggah setiap file dengan
catalog.file_upload()sebelum kamu menjalankan function. -
Unggahan akan menggantikan file lama dengan nama yang sama, bahkan untuk job yang sudah kamu kirim tetapi belum mulai berjalan. Untuk menjalankan beberapa job sekaligus, beri file tiap job nama sendiri, misalnya
run1_x_train.csvdanrun2_x_train.csv. -
Setiap file adalah file CSV dengan baris header. Setiap kolom pada file fitur adalah satu fitur, dan setiap nilai harus numerik.
-
y_trainberisi tepat satu kolom numerik, dengan satu label untuk setiap barisx_train. Petakan label kategorikal ke angka, misalnya baik dan buruk menjadi 1 dan 0. -
x_testdanx_inferenceharus punya kolom yang sama denganx_train, dengan urutan yang sama.
mapping_id adalah satu-satunya cara untuk mengakses mapping yang dihasilkan oleh fit kamu, dan tidak bisa dicari atau dipulihkan. ID ini memberi otorisasi untuk menggunakan mapping tersebut, jadi perlakukan seperti kredensial dan jangan dibagikan. Kalau hilang, kamu harus melakukan fit mapping baru, yang berarti memakai satu run lagi di perangkat keras kuantum. Catat juga backend_name dari fit tersebut, karena mapping hanya berjalan di prosesor itu.
Batasan
-
Setiap fitur dipetakan ke satu qubit, jadi prosesor harus punya qubit minimal sebanyak fitur pada datamu. Kalau fiturmu lebih banyak dari itu, kurangi dulu dengan teknik seleksi fitur.
-
Setiap sampel menjadi satu circuit, dan sebuah run menghitung sampel pelatihan dan pengujian bersama-sama. Satu run bisa berisi maksimal 15.000 sampel.
-
Satu job bisa meminta maksimal 10 juta eksekusi, jadi jumlah sampel dikali
shotstidak boleh melebihi 10 juta. -
Sebuah job harus selesai dalam 24 jam, termasuk waktu circuit-nya menunggu di antrean prosesor. Job yang berjalan lebih lama dihentikan tanpa hasil. Di prosesor yang sibuk, jaga dataset besar tetap jauh di bawah batas ini.
Output
job.result() mengembalikan sebuah dictionary. Fitur hasil transformasi kuantum itu sendiri ditulis ke file CSV yang kamu unduh dengan catalog.file_download(). Untuk deskripsi setiap key pada dictionary, lihat referensi API. Untuk waktu yang dibutuhkan setiap fase eksekusi, lihat Metadata run.
Setiap file output berisi satu baris untuk setiap baris input, dengan urutan yang sama seperti file input, dan satu kolom untuk setiap fitur hasil transformasi kuantum. Kolom yang namanya diawali corr_ adalah nilai ekspektasi dua-benda. File ini tidak punya kolom label. Label data pelatihanmu tetap ada di file y_train.
Metadata run
resource_usage berisi satu entri untuk setiap fase eksekusi yang dilalui run: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING", dan, di QPU, biasanya "RUNNING: WAITING_FOR_QPU". Setiap entri berisi CPU_TIME, yaitu waktu wall-clock fase tersebut dalam detik, dan QPU_TIME, yaitu waktu QPU dalam detik. Di QPU, waktu QPU yang ditagihkan IBM dicatat di bawah "RUNNING: MAPPING", fase tempat circuit dijalankan.
"RUNNING: WAITING_FOR_QPU" adalah waktu job kamu menunggu di antrean IBM. Run mengambil waktu ini dari timestamp job IBM, dan tidak menghitungnya di "RUNNING: MAPPING". Kalau IBM tidak melaporkan timestamp itu untuk setiap job, entri ini tidak ada, dan waktu tunggu menjadi bagian dari "RUNNING: MAPPING".
IBM® menyelesaikan perhitungan penggunaannya beberapa saat setelah job selesai. Run menunggu hingga sekitar satu menit untuk itu. Penggunaan yang masih dihitung setelah waktu tersebut tidak dimasukkan ke QPU_TIME, dan penggunaan akhirnya ditampilkan di IBM Quantum Platform. Kalau run tidak bisa membaca penggunaan dari IBM, QPU_TIME bernilai None.
Contoh:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Mulai
Autentikasi dengan API key IBM Quantum Platform kamu, lalu pilih Qiskit Function sebagai berikut:
Kode berikut mengasumsikan kamu sudah menyimpan kredensial. Kalau belum, ikuti petunjuk di Install the Qiskit Functions Catalog client untuk menyimpan akunmu dengan API key.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Ukuran function
Setiap job berjalan pada satu ukuran — S, M, atau L. Kalau ukuran yang ditentukan terlalu kecil, job ditolak. Kalau ukurannya lebih besar dari yang dibutuhkan, job berjalan pada compute profile yang lebih besar daripada kebutuhan pekerjaannya.
Ukuran job Rimay bergantung pada jumlah sampel yang dipetakannya: baris x_train dan x_test untuk fit-transform, dan baris x_inference untuk transform. Label di y_train tidak dihitung, dan run delete tidak memetakan sampel.
| Ukuran | Sampel per job | Compute profile | vCPU | RAM |
|---|---|---|---|---|
S | Hingga 2.999 | 8x32 | 8 | 32 GB |
M | 3.000 sampai 9.999 | 8x32 | 8 | 32 GB |
L | 10.000 sampai 15.000 | 16x128 | 16 | 128 GB |
Jumlah sampel adalah satu-satunya kriteria. Ukuran tidak mengubah apa pun selain compute profile: batasan untuk fitur, sampel, dan shot sama untuk setiap ukuran. S dan M berjalan pada compute profile yang sama dan hanya berbeda pada jumlah sampel yang dicakup masing-masing.
Default-nya M, yang dipakai ketika job tidak meminta ukuran. Karena itu, job dengan lebih dari 9.999 sampel harus meminta L.
Kamu juga bisa membaca pemetaan itu dari function-nya langsung dengan rimay.sizes_map, dan ukuran yang dipakai job ketika tidak meminta ukuran dengan rimay.default_size.
Hitung ukuran sebelum mengirim
Jalankan ini pada inputmu sendiri. Ini hanya membaca input dan tidak melakukan hal lain: tidak ada job yang dikirim dan tidak ada yang dicadangkan, jadi kamu bisa memanggilnya sesering yang kamu mau.
Berikan dataset-nya langsung, bukan nama file-nya, dengan urutan yang sama seperti input_file, beserta mode dari run. Langkah 2 pada contoh menunjukkan pemanggilannya.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Kalau ukurannya terlalu kecil, job gagal dengan error 4600 dan pesannya menyebutkan ukuran yang harus dipakai. Kalau lebih besar dari yang dibutuhkan, job berjalan normal dan mencatat event advisory 4601.
Contoh
Contoh ini menunjukkan cara mengunggah data, menjalankan function, dan mengambil fitur hasil transformasi kuantum. Untuk contoh end-to-end yang mencakup praproses dan pelatihan model klasik, lihat tutorial.
1. Unggah data
Contoh ini memakai dataset sintetis kecil dengan empat fitur numerik dan satu label biner, jadi sebuah run hanya butuh empat qubit dan selesai dengan cepat. Cell berikutnya menulisnya ke empat file CSV: fitur pelatihan, label pelatihan, fitur pengujian, dan fitur untuk langkah 4 contoh ini. Untuk memakai datamu sendiri, tulis set pelatihan dan pengujian yang sudah dipraproses ke file dengan layout yang sama.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Unggah file pelatihan dan pengujian. Kamu mengunggah x_inference.csv di langkah 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Jalankan function
Hitung ukuran run dari data yang kamu unggah, dengan kalkulator dari Ukuran function.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Pilih prosesor dengan qubit minimal sebanyak fitur pada datamu, lalu jalankan function dalam mode fit-transform dengan ukuran itu. Data contoh punya empat fitur, jadi prosesor IBM Quantum mana pun bisa menjalankannya.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Cek status workload atau ambil hasil sebagai berikut:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Ambil hasilnya
Unduh fitur hasil transformasi kuantum. Berikan target_name supaya setiap file disimpan dengan namanya sendiri.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Petakan data baru
Setelah melatih modelmu, petakan data baru dengan mapping hasil fit, misalnya untuk menjalankan inferensi. Contoh ini memetakan x_inference.csv, yang ditulis oleh cell pertama contoh ini. Berikan mapping_id yang dikembalikan fit, supaya baris baru dipetakan dengan mapping yang sama, bukan mapping baru.
Sebuah mapping dibangun untuk layout qubit satu prosesor, jadi berikan backend_name yang sama dengan fit, yang dikembalikan fit di result["backend_name"]. Jangan pakai least_busy() untuk memilih prosesor, karena bisa mengembalikan prosesor yang berbeda. Rimay menolak prosesor lain sebelum mengirim apa pun. Jumlah shot juga berasal dari fit.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Hapus mapping
Kalau kamu sudah tidak membutuhkan fitted mapping, hapus saja. Run delete tidak melakukan pekerjaan kuantum apa pun, jadi tidak perlu prosesor, shot, maupun function size. Penghapusan tidak bisa dibatalkan. Setelah dihapus, mapping_id tidak merujuk ke apa pun lagi, dan run transform dengan ID itu akan gagal.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Ambil pesan error
Kalau status workload kamu ERROR, pakai job.error_message() untuk mengambil pesan error, sebagai berikut:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Setiap error yang dilaporkan Rimay membawa kode dari kode error IBM Quantum, sebuah pesan, dan solusi yang menyebutkan nilai yang kamu berikan dan nilai yang diizinkan. Tabel berikut mendaftar error yang paling umum:
| Kode | Penyebab |
|---|---|
1221 | Ada parameter yang hilang atau bertipe salah, mode tidak valid, file yang disebut di input_file belum diunggah, file-file tidak cocok satu sama lain, ada fitur yang tidak numerik, atau mapping_id tidak cocok dengan mapping yang tersimpan. |
1221 | Run "transform" menyebut backend_name yang berbeda dari fit yang menghasilkan mapping-nya. |
1216 | Instance kamu tidak punya prosesor dengan backend_name yang kamu berikan. Solusinya mendaftar prosesor yang dimilikinya. |
1200 | API key kamu tidak punya akses ke instance tempat job berjalan. |
3200 | backend_name tidak diawali ibm_. |
4500 | Data punya lebih banyak fitur daripada jumlah qubit prosesor. |
6000 | Jumlah sampel dikali shots melebihi 10 juta eksekusi. |
6001 | shots lebih kecil dari 1. |
6002 | Data punya lebih banyak sampel daripada yang diizinkan satu run. |
Kasus penggunaan
Pada klasifikasi tabular untuk dataset berukuran kecil dan menengah, Kipu Quantum telah menerapkan ekstraksi fitur kuantum pada hal berikut:
Selain data tabular, neural network yang dibekukan bisa mengubah gambar menjadi fitur numerik, yang kemudian dipetakan oleh ekstraksi fitur kuantum menjadi fitur hasil transformasi kuantum:
Dapatkan dukungan
Untuk dukungan, hubungi support@kipu-quantum.com.
Langkah berikutnya
-
Kunjungi referensi API untuk Qiskit Function ini.
-
Coba tutorial Classify credit risk with Kipu Quantum's Rimay quantum feature extraction.
Referensi
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Informasi tambahan
Rimay adalah kata dalam bahasa Quechua yang artinya "menjelaskan".