Benchmark process fidelity QFT+M dengan Orbit, sebuah Qiskit Function oleh Quantum Elements
Perkiraan penggunaan: 2 menit pada prosesor Heron r3. (CATATAN: Ini hanya perkiraan. Runtime Anda mungkin bervariasi.) Secara default, tutorial ini mengirimkan tiga job fungsi Orbit ke dalam satu workload batch mode IBM Quantum Compute Service, dengan 300 PUB per job, untuk total 900 PUB dan 921.600 shot.
Peringatan: Dynamic circuit saat ini merupakan fitur eksperimental, dan tunduk pada keterbatasan dalam Quantum Compute [3] yang dapat menyebabkan kegagalan job. Misalnya, error 6073 mengindikasikan bahwa sebuah job melampaui batas memori hardware classical-control [4]. Notebook ini mengurangi risiko tersebut dengan mempartisi ukuran circuit di tiga job Quantum Compute dalam satu batch [5]. Setiap perbandingan ukuran-tetap tetap berada dalam satu job, sementara ukuran besar dan kecil dipasangkan untuk menyeimbangkan beban kerja classical-control dari job tersebut.
Hasil pembelajaran
-
Menyiapkan product state yang digunakan oleh estimator process-fidelity yang disampel dalam Gambar 2a dari Ref. [1].
-
Membangun implementasi unitary dan dynamic yang setara dari quantum Fourier transform diikuti pengukuran (QFT+M).
-
Memilih qubit fisik untuk dynamic circuit menggunakan data kalibrasi dan konektivitas terkini.
-
Membandingkan estimasi process-fidelity raw unitary, raw dynamic, dan dynamic yang ditingkatkan Orbit dari QFT+M seiring bertambahnya ukuran circuit.
-
Menggunakan API transpilasi Orbit yang disederhanakan dengan
mode="raw"dantranspilation_mode="validate". -
Mengirimkan beberapa workload Orbit melalui API batch mode sambil tetap menjaga setiap perbandingan tiga-strategi ukuran-tetap dalam satu job.
-
Memeriksa metadata Orbit untuk mengonfirmasi apakah dynamical decoupling (DD) dan mitigasi error pengukuran (MEM) telah diterapkan.
Latar belakang
Gambar 2a dari Ref. [1] melakukan benchmark process fidelity dari channel QFT+M ideal terhadap implementasi unitary dan dynamic yang noisy. Untuk label basis komputasi yang disampel, benchmark menyiapkan , menerapkan implementasi QFT+M yang noisy, dan mengestimasi probabilitas untuk mendapatkan output ideal yang bersesuaian. State invers-QFT ini bersifat separable dan dapat disiapkan secara efisien dengan gate Hadamard dan rotasi fase virtual.
Untuk label yang disampel secara independen, notebook ini menggunakan estimator tak bias yang diturunkan dalam Ref. [1]:
Konstruksi dynamic menggantikan controlled-phase gate dari QFT+M unitary dengan pengukuran mid-circuit dan rotasi fase yang dikondisikan secara klasik [1]. Dengan deferred measurement, kedua circuit memiliki distribusi output ideal yang sama. Bentuk dynamic ini menghilangkan kebutuhan two-qubit-gate all-to-all dan sebagai gantinya menggunakan pengukuran mid-circuit dengan feedforward dan tanpa batasan konektivitas. Pengukuran dan feedforward juga meninggalkan periode idle yang panjang pada qubit yang belum diukur, membuat DD sangat relevan.
Hubungan dengan Gambar 2a. Notebook ini mengikuti protokol process-fidelity yang disampel dari paper tersebut, tetapi ini adalah adaptasi tutorial yang berfokus pada Orbit dan bukan reproduksi. Misalnya, sementara Gambar 2a menggunakan ibm_kyiv dengan 2000 shot, kita menggunakan perangkat modern ibm_aachen dengan jumlah shot yang lebih kecil, 1024, untuk menghemat waktu QPU.
Contoh hasil
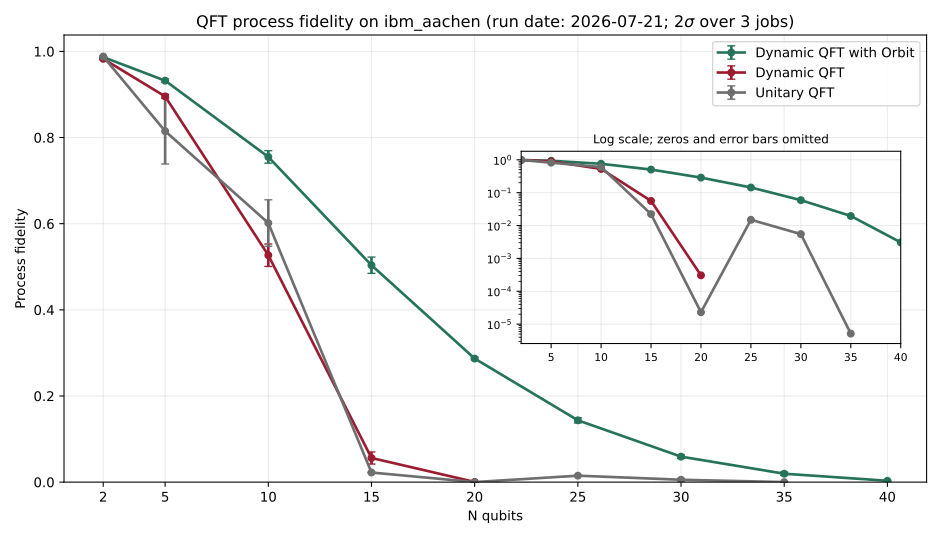
Plot statis di bawah ini menunjukkan kurva process-fidelity rata-rata dari tiga job pengembangan berturut-turut yang dijalankan pada ibm_aachen dengan proses yang dijelaskan di bawah ini. Seperti yang ditunjukkan di sini, Orbit dapat sangat meningkatkan kualitas dynamic circuit; QFT dynamic menyamai kualitas benchmark yang dipublikasikan dan menunjukkan peningkatan dibandingkan QFT unitary standar. Seperti yang akan kita lihat, hasil ini berasal dari pilihan qubit otomatis yang baik, penyisipan dynamic decoupling otomatis (tidak dioptimalkan secara manual untuk masalah ini), dan mitigasi error pengukuran. Sebagai bonus, pastikan untuk membandingkan hasil ini dengan hasil Anda di akhir, terutama jika Anda memilih backend yang berbeda.
Catatan: Hasil ini adalah cuplikan ilustratif dari run sebelumnya yang berhasil dengan Orbit, bukan jaminan performa. Hasil di bawah ini seharusnya terlihat mirip secara kualitatif, tetapi spesifiknya bergantung pada perangkat yang dipilih dan propertinya, terutama error pengukuran dan idling, pada saat runtime.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-ibm-catalog qiskit-ibm-runtime
Persyaratan
Instal versi terbaru dari paket-paket berikut sebelum menjalankan tutorial ini:
-
numpy -
matplotlib -
qiskit -
qiskit-ibm-runtime -
qiskit-ibm-catalog
pip install qiskit qiskit-ibm-runtime qiskit-ibm-catalog numpy matplotlib
Persiapan
Autentikasi dengan IBM Quantum® Platform, muat ibm_aachen, dan muat Quantum Elements Orbit dari Qiskit Functions Catalog. Sweep default mengevaluasi 15 ukuran circuit, 20 bitstring yang disampel per ukuran, dan tiga strategi. NUM_BATCH_JOBS=3 mempartisi ukuran-ukuran tersebut di tiga job dalam satu batch. Kurangi N_VALUES atau M, atau tingkatkan NUM_BATCH_JOBS, jika sebuah job dynamic-circuit individual masih mencapai batas memori classical-control backend. Kurangi SHOTS ketika tujuannya adalah menurunkan penggunaan eksekusi, bukan jumlah atau kompleksitas circuit.
import warnings
from collections import Counter, defaultdict

import matplotlib.pyplot as plt
import numpy as np
from qiskit import (
    ClassicalRegister,
    QuantumCircuit,
    QuantumRegister,
    transpile,
)
from qiskit.circuit import IfElseOp
from qiskit.synthesis.qft import synth_qft_full
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

IBM_BACKEND_NAME = "ibm_aachen"

N_VALUES = [2, 3, 4, 5, 6, 7, 8, 9, 10, 15, 20, 25, 30, 35, 40]
M = 20
SHOTS = 1024
RNG_SEED = 12345
OPTIMIZATION_LEVEL = 0
NUM_BATCH_JOBS = 3
STRATEGY_LABELS = ("unitary/raw", "dynamic/raw", "dynamic/orbit")

def balanced_n_groups(
    n_values: list[int], num_jobs: int = 3
) -> list[list[int]]:
    values = sorted(n_values)
    if len(set(values)) != len(values):
        raise ValueError("N_VALUES must not contain duplicates")
    if not 1 <= num_jobs <= len(values):
        raise ValueError("NUM_BATCH_JOBS must be between 1 and len(N_VALUES)")

    max_group_size = (len(values) + num_jobs - 1) // num_jobs
    groups = [[] for _ in range(num_jobs)]
    loads = [0] * num_jobs
    pair_counts = [0] * num_jobs
    remaining = values.copy()

    while len(remaining) >= 2:
        candidates = [
            i
            for i, group in enumerate(groups)
            if len(group) + 2 <= max_group_size
        ]
        if not candidates:
            break
        smallest = remaining.pop(0)
        largest = remaining.pop()
        job_index = min(
            candidates, key=lambda i: (loads[i], len(groups[i]), i)
        )
        pair = (
            [largest, smallest]
            if pair_counts[job_index] % 2 == 0
            else [smallest, largest]
        )
        groups[job_index].extend(pair)
        loads[job_index] += smallest + largest
        pair_counts[job_index] += 1

    while remaining:
        value = remaining.pop()
        candidates = [
            i for i, group in enumerate(groups) if len(group) < max_group_size
        ]
        job_index = min(
            candidates, key=lambda i: (loads[i], len(groups[i]), i)
        )
        groups[job_index].append(value)
        loads[job_index] += value

    return groups

N_GROUPS = balanced_n_groups(N_VALUES, NUM_BATCH_JOBS)

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend(IBM_BACKEND_NAME)
if "if_else" not in backend.target.operation_names:
    backend.target.add_instruction(IfElseOp, name="if_else")

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
quantum_elements_orbit = catalog.load("quantum-elements/orbit")
if quantum_elements_orbit is None:
    raise RuntimeError(
        "Quantum Elements Orbit is not enabled for this IBM Quantum instance."
    )

required_qubits = max(N_VALUES)
if backend.num_qubits < required_qubits:
    raise ValueError(
        f"Backend {backend.name} has {backend.num_qubits} qubits, "
        f"but this benchmark needs at least {required_qubits}."
    )

{
    "backend": backend.name,
    "num_qubits": backend.num_qubits,
    "n_values": N_VALUES,
    "m": M,
    "shots": SHOTS,
    "num_function_jobs": NUM_BATCH_JOBS,
    "n_groups": N_GROUPS,
    "pubs_per_job": [
        len(group) * M * len(STRATEGY_LABELS) for group in N_GROUPS
    ],
    "total_pubs": len(N_VALUES) * M * len(STRATEGY_LABELS),
    "total_shots": len(N_VALUES) * M * len(STRATEGY_LABELS) * SHOTS,
}
qiskit_runtime_service._discover_account:WARNING:2026-07-21 15:57:39,310: Loading account with the given token. A saved account will not be used.
{'backend': 'ibm_aachen',
 'num_qubits': 156,
 'n_values': [2, 3, 4, 5, 6, 7, 8, 9, 10, 15, 20, 25, 30, 35, 40],
 'm': 20,
 'shots': 1024,
 'num_function_jobs': 3,
 'n_groups': [[40, 2, 7, 15, 10], [35, 3, 6, 20, 9], [30, 4, 5, 25, 8]],
 'pubs_per_job': [300, 300, 300],
 'total_pubs': 900,
 'total_shots': 921600}
Bangun circuit QFT+M
Untuk setiap integer yang disampel, bit_inv_qft menyiapkan product state dengan Hadamard diikuti rotasi fase. Notebook ini kemudian menambahkan salah satu dari QFT unitary standar atau padanan semiklasik QFT+M dinamisnya.
Kedua implementasi menghilangkan swap network akhir. Urutan tampilan classical-bit dalam Qiskit oleh karena itu membuat string yang diharapkan terukur menjadi kebalikan dari representasi biner zero-padded dari , yang dikodekan oleh format(x, f"0{n}b")[::-1].
def bit_inv_qft(circuit: QuantumCircuit, x: int, conv: str = "LSB") -> None:
    num_qubits = circuit.num_qubits
    circuit.h(range(num_qubits))
    for j in range(num_qubits):
        phase = (
            2 * np.pi * x / 2 ** (num_qubits - j)
            if conv == "LSB"
            else 2 * np.pi * x / 2 ** (j + 1)
        )
        circuit.p(-phase, j)

def build_unitary_qft_circuit(num_qubits: int, x: int) -> QuantumCircuit:
    if not 0 <= x < 2**num_qubits:
        raise ValueError(
            f"x={x} is outside the {num_qubits}-qubit basis range"
        )
    qreg = QuantumRegister(num_qubits, "q")
    creg = ClassicalRegister(num_qubits, "c")
    circuit = QuantumCircuit(qreg, creg, name=f"unitary_qft_{num_qubits}q")
    bit_inv_qft(circuit, x)
    circuit.append(
        synth_qft_full(num_qubits, do_swaps=False), range(num_qubits)
    )
    circuit.measure(range(num_qubits), range(num_qubits))
    return circuit

def _warn_if_precision_loss(max_num_entanglements: int) -> None:
    if max_num_entanglements > -np.finfo(float).minexp:
        warnings.warn(
            "precision loss in QFT."
            f" The rotation needed to represent {max_num_entanglements} entanglements"
            " is smaller than the smallest normal floating-point number.",
            category=RuntimeWarning,
            stacklevel=4,
        )

def synth_dynamic_qft(
    circuit: QuantumCircuit, *, do_swaps: bool = False
) -> QuantumCircuit:
    num_qubits = circuit.num_qubits
    creg = circuit.cregs[0]
    _warn_if_precision_loss(num_qubits - 1)

    for j in reversed(range(num_qubits)):
        circuit.h(j)
        circuit.measure([j], [j])

        if j > 0:
            with circuit.if_test((creg[j], 1)):
                for k in reversed(range(j)):
                    circuit.p(np.pi * (2.0 ** (k - j)), k)

    if do_swaps:
        for i in range(num_qubits // 2):
            circuit.swap(i, num_qubits - i - 1)
    return circuit

def build_dynamic_qft_circuit(num_qubits: int, x: int) -> QuantumCircuit:
    if not 0 <= x < 2**num_qubits:
        raise ValueError(
            f"x={x} is outside the {num_qubits}-qubit basis range"
        )
    qreg = QuantumRegister(num_qubits, "q")
    creg = ClassicalRegister(num_qubits, "c")
    circuit = QuantumCircuit(qreg, creg, name=f"dynamic_qft_{num_qubits}q")
    bit_inv_qft(circuit, x)
    synth_dynamic_qft(circuit, do_swaps=False)
    return circuit

def target_output_bitstring(x: int, n_qubits: int) -> str:
    return format(int(x), f"0{n_qubits}b")[::-1]

def process_fidelity_from_success_probabilities(
    success_probabilities: list[float],
) -> float:
    m = len(success_probabilities)
    if m <= 1:
        raise ValueError(
            "m must be larger than 1 for the process-fidelity estimator"
        )
    succ = np.asarray(success_probabilities, dtype=float)
    return float(
        (m / (m - 1)) * (np.mean(np.sqrt(succ)) ** 2)
        - np.sum(succ) / (m * (m - 1))
    )
Pilih qubit fisik dynamic circuit
Implementasi dynamic tidak memerlukan two-qubit gate, sehingga qubit fisiknya tidak perlu membentuk subgraph yang terhubung. Untuk setiap ukuran circuit, selector memeringkat qubit backend saat ini menggunakan skor yang dibobotkan 80% terhadap error readout yang lebih rendah dan masing-masing 10% terhadap dan yang lebih tinggi. Pertama-tama ia memilih qubit dengan skor tinggi yang tidak memiliki coupling langsung di antara mereka jika memungkinkan, yang dapat mengurangi paparan terhadap crosstalk nearest-neighbor, dan kemudian mengisi posisi yang tersisa berdasarkan skor.
Varian dynamic/raw dan dynamic/orbit menggunakan layout terpilih yang persis sama untuk ukuran tertentu, membuat perbandingannya layout-controlled. Circuit unitary/raw sebaliknya dipetakan dan dirutekan oleh transpiler karena ia membutuhkan konektivitas two-qubit. Pemilihan berbasis kalibrasi runtime ini spesifik untuk tutorial ini; ini bukan layout ibm_kyiv 40-qubit tetap yang digunakan untuk eksperimen Gambar 2a dari paper tersebut.
def value_from_property(raw):
    if raw is None:
        return None
    if isinstance(raw, tuple):
        return raw[0]
    return getattr(raw, "value", raw)

def qubit_property_value(properties, qubit: int, *names: str) -> float | None:
    for name in names:
        try:
            value = value_from_property(
                properties.qubit_property(qubit, name)
            )
        except Exception:
            value = None
        if value is not None:
            return float(value)
    return None

def measurement_error(properties, qubit: int) -> float | None:
    readout = qubit_property_value(properties, qubit, "readout_error")
    if readout is not None:
        return readout
    p01 = qubit_property_value(properties, qubit, "prob_meas0_prep1")
    p10 = qubit_property_value(properties, qubit, "prob_meas1_prep0")
    if p01 is not None and p10 is not None:
        return 0.5 * (p01 + p10)
    return None

def coupling_edges(backend) -> list[tuple[int, int]]:
    coupling_map = getattr(backend, "coupling_map", None)
    if coupling_map is not None:
        try:
            return [(int(a), int(b)) for a, b in coupling_map.get_edges()]
        except Exception:
            pass
    built = backend.target.build_coupling_map()
    return [(int(a), int(b)) for a, b in built.get_edges()]

def neighbor_map(backend) -> dict[int, set[int]]:
    neighbors = {qubit: set() for qubit in range(backend.num_qubits)}
    for a, b in coupling_edges(backend):
        neighbors[a].add(b)
        neighbors[b].add(a)
    return neighbors

def anchored_score(
    value: float | None, *, good: float, bad: float, higher_is_better: bool
) -> float:
    if value is None:
        return 0.0
    if higher_is_better:
        low, high = sorted((bad, good))
        score = (value - low) / (high - low)
    else:
        low, high = sorted((good, bad))
        score = (high - value) / (high - low)
    return float(min(1.0, max(0.0, score)))

def qubit_metrics(backend) -> list[dict]:
    properties = backend.properties()
    rows = []
    for qubit in range(backend.num_qubits):
        t1 = qubit_property_value(properties, qubit, "T1", "t1")
        t2 = qubit_property_value(properties, qubit, "T2", "t2")
        meas_error = measurement_error(properties, qubit)
        measurement_score = anchored_score(
            meas_error, good=0.005, bad=0.05, higher_is_better=False
        )
        t1_score = anchored_score(
            t1, good=0.00025, bad=0.00005, higher_is_better=True
        )
        t2_score = anchored_score(
            t2, good=0.00025, bad=0.00005, higher_is_better=True
        )
        rows.append(
            {
                "qubit": qubit,
                "t1": t1,
                "t2": t2,
                "measurement_error": meas_error,
                "score": 0.8 * measurement_score
                + 0.1 * t1_score
                + 0.1 * t2_score,
            }
        )
    return sorted(rows, key=lambda row: row["score"], reverse=True)

def select_dynamic_qubits(backend, n_qubits: int) -> list[int]:
    ranked = qubit_metrics(backend)
    neighbors = neighbor_map(backend)
    selected = []
    blocked = set()
    for row in ranked:
        qubit = row["qubit"]
        if qubit in blocked:
            continue
        selected.append(qubit)
        blocked.add(qubit)
        blocked.update(neighbors.get(qubit, set()))
        if len(selected) == n_qubits:
            return selected

    for row in ranked:
        qubit = row["qubit"]
        if qubit not in selected:
            selected.append(qubit)
        if len(selected) == n_qubits:
            return selected
    raise RuntimeError(f"Could not select {n_qubits} physical qubits")

print("The top 3 qubits (according to our scoring): ")
print(qubit_metrics(backend)[0:3])
print("Worst  3 qubits (according to our scoring): ")
print(qubit_metrics(backend)[-3:])
The top 3 qubits (according to our scoring):
[{'qubit': 0, 't1': 0.0002514242577986401, 't2': 0.00037559012475638467, 'measurement_error': 0.0028076171875, 'score': 1.0}, {'qubit': 20, 't1': 0.0002526252407383437, 't2': 0.00038493543771861573, 'measurement_error': 0.00390625, 'score': 1.0}, {'qubit': 25, 't1': 0.0002712841332005567, 't2': 0.00025793268824583597, 'measurement_error': 0.0040283203125, 'score': 1.0}]
Worst  3 qubits (according to our scoring):
[{'qubit': 146, 't1': 7.619772882181663e-05, 't2': 0.00014166983578724752, 'measurement_error': 0.0802001953125, 'score': 0.05893378230453208}, {'qubit': 51, 't1': 0.00014200221819602618, 't2': 1.930870507157441e-06, 'measurement_error': 0.054443359375, 'score': 0.04600110909801309}, {'qubit': 35, 't1': 7.116087485472031e-05, 't2': 9.463696242928626e-05, 'measurement_error': 0.14501953125, 'score': 0.03289891864200328}]
Siapkan PUB benchmark
Untuk setiap pasangan (N, x), notebook ini terlebih dahulu mentranspilasi circuit logis dan membuat satu PUB Sampler untuk setiap strategi:
-
unitary/raw: QFT+M unitary pada layout yang dipilih oleh transpiler, dengan routing sesuai kebutuhan dan tanpa Orbit DD atau MEM. -
dynamic/raw: QFT+M dinamis pada qubit fisik yang dipilih oleh kalibrasi, tanpa Orbit DD atau MEM. -
dynamic/orbit: circuit dinamis yang sama yang telah ditranspilasi pada qubit fisik yang sama, dengan Orbit DD dan MEM diaktifkan.
PUB yang ditingkatkan dengan Orbit menggunakan transpilation_mode="validate" karena pemetaannya sudah dipilih sebelumnya. Orbit memvalidasi circuit fisik yang diberikan alih-alih memetakannya ulang, lalu menerapkan pipeline DD dan MEM-nya. Karena hanya kurva dinamis yang ditingkatkan yang meminta MEM, ini tidak boleh diinterpretasikan sebagai perbandingan terisolasi DD versus tanpa-DD.
PUB, opsi per-PUB, dan rekaman hasil disimpan berdasarkan indeks batch-job. Untuk setiap tetap, PUB unitary/raw, dynamic/raw, dan dynamic/orbit disimpan bersama dalam job yang sama. Helper pengelompokan memasangkan ukuran circuit besar dan kecil, mengganti urutannya secara bergantian, dan menyeimbangkan jumlah di ketiga job sebagai proksi sederhana untuk beban kerja kontrol klasik.
strategy_options = {
    "unitary/raw": {"mode": "raw"},
    "dynamic/raw": {"mode": "raw"},
    "dynamic/orbit": {"mode": "orbit", "transpilation_mode": "validate"},
}
rng = np.random.default_rng(RNG_SEED)
pubs_by_job = [[] for _ in N_GROUPS]
pub_options_by_job = [[] for _ in N_GROUPS]
pub_records_by_job = [[] for _ in N_GROUPS]
layout_summary = {}

target_decimals_by_n = {
    n_qubits: [int(x) for x in rng.integers(0, 2**n_qubits, size=M)]
    for n_qubits in N_VALUES
}

for job_index, n_group in enumerate(N_GROUPS):
    for n_qubits in n_group:
        dynamic_qubits = select_dynamic_qubits(backend, n_qubits)
        layout_summary[str(n_qubits)] = {"dynamic_qubits": dynamic_qubits}

        for x in target_decimals_by_n[n_qubits]:
            target_bitstring = target_output_bitstring(x, n_qubits)
            unitary_logical = build_unitary_qft_circuit(n_qubits, x)
            dynamic_logical = build_dynamic_qft_circuit(n_qubits, x)

            unitary_transpiled = transpile(
                unitary_logical,
                backend=backend,
                optimization_level=OPTIMIZATION_LEVEL,
                seed_transpiler=RNG_SEED,
            )
            dynamic_transpiled = transpile(
                dynamic_logical,
                backend=backend,
                optimization_level=OPTIMIZATION_LEVEL,
                seed_transpiler=RNG_SEED,
                initial_layout=dynamic_qubits,
            )

            circuits_by_label = {
                "unitary/raw": unitary_transpiled,
                "dynamic/raw": dynamic_transpiled,
                "dynamic/orbit": dynamic_transpiled,
            }
            for label in STRATEGY_LABELS:
                circuit = circuits_by_label[label]
                options = dict(strategy_options[label])
                pubs_by_job[job_index].append((circuit, None, SHOTS))
                pub_options_by_job[job_index].append(options)
                pub_records_by_job[job_index].append(
                    {
                        "job_index": job_index,
                        "n_qubits": n_qubits,
                        "target_decimal": x,
                        "target_bitstring": target_bitstring,
                        "label": label,
                        "pub_options": options,
                        "dynamic_qubits": (
                            dynamic_qubits
                            if label.startswith("dynamic/")
                            else None
                        ),
                        "transpiled_depth": circuit.depth(),
                        "transpiled_size": circuit.size(),
                    }
                )

{
    "num_function_jobs": len(N_GROUPS),
    "n_groups": {
        job_index: group for job_index, group in enumerate(N_GROUPS)
    },
    "n_load_per_job": {
        job_index: sum(group) for job_index, group in enumerate(N_GROUPS)
    },
    "pubs_per_job": {
        job_index: len(pubs) for job_index, pubs in enumerate(pubs_by_job)
    },
    "expected_executions_per_job": {
        job_index: len(pubs) * SHOTS
        for job_index, pubs in enumerate(pubs_by_job)
    },
    "first_pub_record_by_job": {
        job_index: records[0]
        for job_index, records in enumerate(pub_records_by_job)
    },
    "largest_dynamic_qubit_set": layout_summary[str(max(N_VALUES))][
        "dynamic_qubits"
    ],
}
{'num_function_jobs': 3,
 'n_groups': {0: [40, 2, 7, 15, 10],
  1: [35, 3, 6, 20, 9],
  2: [30, 4, 5, 25, 8]},
 'n_load_per_job': {0: 74, 1: 73, 2: 72},
 'pubs_per_job': {0: 300, 1: 300, 2: 300},
 'expected_executions_per_job': {0: 307200, 1: 307200, 2: 307200},
 'first_pub_record_by_job': {0: {'job_index': 0,
   'n_qubits': 40,
   'target_decimal': 853235401719,
   'target_bitstring': '1110111111000000110100110001010101100011',
   'label': 'unitary/raw',
   'pub_options': {'mode': 'raw'},
   'dynamic_qubits': None,
   'transpiled_depth': 4778,
   'transpiled_size': 28259},
  1: {'job_index': 1,
   'n_qubits': 35,
   'target_decimal': 26888951661,
   'target_bitstring': '10110110111010110010110101000010011',
   'label': 'unitary/raw',
   'pub_options': {'mode': 'raw'},
   'dynamic_qubits': None,
   'transpiled_depth': 3614,
   'transpiled_size': 21204},
  2: {'job_index': 2,
   'n_qubits': 30,
   'target_decimal': 620442965,
   'target_bitstring': '101010101010110011011111001001',
   'label': 'unitary/raw',
   'pub_options': {'mode': 'raw'},
   'dynamic_qubits': None,
   'transpiled_depth': 2835,
   'transpiled_size': 15078}},
 'largest_dynamic_qubit_set': [0,
  20,
  25,
  27,
  33,
  59,
  74,
  80,
  95,
  144,
  151,
  155,
  79,
  90,
  60,
  68,
  114,
  107,
  13,
  126,
  133,
  103,
  3,
  87,
  53,
  41,
  130,
  5,
  98,
  135,
  153,
  15,
  116,
  45,
  7,
  48,
  136,
  11,
  147,
  77]}
Jalankan benchmark
Buat satu batch, lalu kirim tiga job fungsi Orbit ke dalamnya.
Job dipartisi berdasarkan kelompok jumlah qubit sehingga ketiga strategi untuk tetap dapat dibandingkan. Artinya, semua 60 PUB untuk tetap — 20 input yang di-sampling dikalikan tiga strategi — oleh karena itu dijalankan dalam job yang sama dan dengan demikian dapat dibandingkan seadil mungkin (kalau tidak, jika dijalankan di job yang berbeda, device dapat mengalami drift saat mengantre). Kelompok default menggabungkan circuit besar dan kecil serta berisi 300 PUB masing-masing, mengurangi kemungkinan satu job mengumpulkan semua program dinamis terbesar sekaligus mempertahankan perbandingan dalam job.
runtime_batch = Batch(backend=backend)
jobs = []
try:
    for job_index, pubs in enumerate(pubs_by_job):
        jobs.append(
            quantum_elements_orbit.run(
                primitive="sampler",
                pubs=pubs,
                backend_name=backend.name,
                options={
                    "pub_options": pub_options_by_job[job_index],
                    "save_backend_info": True,
                },
            )
        )
except Exception:
    runtime_batch.close()
    raise

{
    "runtime_batch_id": runtime_batch.session_id,
    "jobs": {
        job_index: {
            "backend": backend.name,
            "function_job_id": job.job_id,
            "status": job.status(),
            "n_values": N_GROUPS[job_index],
            "num_pubs": len(pubs_by_job[job_index]),
        }
        for job_index, job in enumerate(jobs)
    },
}
{'runtime_batch_id': '80120e36-436d-46c7-96c9-597ec86060c1',
 'jobs': {0: {'backend': 'ibm_aachen',
   'function_job_id': '2b6b05ac-0136-40f0-94bf-ade5658f5f4f',
   'status': 'QUEUED',
   'n_values': [40, 2, 7, 15, 10],
   'num_pubs': 300},
  1: {'backend': 'ibm_aachen',
   'function_job_id': '4f046fd4-80e4-460b-87c7-e7252691f764',
   'status': 'QUEUED',
   'n_values': [35, 3, 6, 20, 9],
   'num_pubs': 300},
  2: {'backend': 'ibm_aachen',
   'function_job_id': '6d70d64d-fa38-4ca2-9cbd-ffda5d8c99be',
   'status': 'QUEUED',
   'n_values': [30, 4, 5, 25, 8],
   'num_pubs': 300}}}
Ambil hasil dan hitung process fidelity
Ambil dan validasi setiap hasil kelompok qubit secara independen, lalu gabungkan ketiga aliran job melalui rekaman terindeks job-nya. Batch tetap terbuka selama semua hasil fungsi diminta dan ditutup dalam blok finally setelah setiap job selesai dicoba. Untuk setiap PUB, adalah probabilitas yang diberikan pada bitstring yang diharapkan. extract_counts membaca counts yang dikembalikan ke pemanggil; untuk dynamic/orbit, ini adalah counts yang disesuaikan MEM saat mitigasi berhasil. extract_raw_counts juga mengambil kembali counts yang belum dimitigasi yang sesuai, yang dicatat dalam metadata Orbit. Kode ini mengelompokkan 20 nilai untuk setiap pasangan (N, label) dan menerapkan estimator yang diperkenalkan di atas.
Dictionary process_fidelity yang diplot karena itu menggunakan raw counts untuk unitary/raw dan dynamic/raw, tetapi counts yang disesuaikan MEM untuk dynamic/orbit. Dictionary paralel raw_process_fidelity mempertahankan perhitungan yang belum dimitigasi untuk setiap strategi dan berguna saat memisahkan efek MEM dari sisa pipeline Orbit. MEM mengoreksi histogram output yang dikembalikan; ia tidak bisa secara retroaktif mengubah hasil pengukuran mid-circuit yang sudah digunakan oleh feedforward real-time.
def extract_counts(pub_result) -> dict[str, int]:
    data = getattr(pub_result, "data", None)
    if data is None:
        raise TypeError("pub_result.data is missing")

    for name in dir(data):
        if name.startswith("_"):
            continue
        register = getattr(data, name)
        get_counts = getattr(register, "get_counts", None)
        if callable(get_counts):
            counts = get_counts()
            if counts:
                return counts

    raise TypeError(
        "No classical register with get_counts() found in pub_result.data"
    )

def extract_raw_counts(pub_result) -> dict[str, int]:
    orbit_metadata = pub_result.metadata.get("quantum_elements_orbit", {})
    mem_report = orbit_metadata.get("measurementErrorMitigation", {})
    return mem_report.get("rawCounts") or extract_counts(pub_result)

def probability_for_bitstring(
    counts: dict[str, int], bitstring: str, n_qubits: int
) -> float:
    total = sum(counts.values())
    if total <= 0:
        return 0.0
    normalized = Counter()
    for measured, count in counts.items():
        key = measured.replace(" ", "")[-n_qubits:].zfill(n_qubits)
        normalized[key] += count
    return float(normalized.get(bitstring, 0) / total)

results_by_job = {}
job_failures = []
try:
    for job_index, job in enumerate(jobs):
        try:
            job_result = job.result()
        except Exception as exc:
            job_logs = getattr(job, "logs", lambda: "")()
            if job_logs:
                print(f"Logs for job {job_index} ({job.job_id}):\n{job_logs}")
            job_failures.append(
                f"job {job_index} ({job.job_id}) failed: {type(exc).__name__}: {exc}"
            )
            continue

        expected_results = len(pub_records_by_job[job_index])
        if len(job_result) != expected_results:
            job_failures.append(
                f"job {job_index} ({job.job_id}) returned {len(job_result)} PUB results; "
                f"expected {expected_results}"
            )
            continue
        results_by_job[job_index] = job_result
finally:
    runtime_batch.close()

if job_failures:
    raise RuntimeError(
        "One or more batched Orbit jobs failed:\n" + "\n".join(job_failures)
    )

grouped_success = defaultdict(list)
grouped_raw_success = defaultdict(list)
pub_summaries = []

for job_index, job_result in sorted(results_by_job.items()):
    records = pub_records_by_job[job_index]
    for record, pub_result in zip(records, job_result, strict=True):
        label = record["label"]
        n_qubits = record["n_qubits"]
        counts = extract_counts(pub_result)
        raw_counts = extract_raw_counts(pub_result)
        success = probability_for_bitstring(
            counts, record["target_bitstring"], n_qubits
        )
        raw_success = probability_for_bitstring(
            raw_counts, record["target_bitstring"], n_qubits
        )
        key = (n_qubits, label)
        grouped_success[key].append(success)
        grouped_raw_success[key].append(raw_success)

        orbit_report = pub_result.metadata.get("quantum_elements_orbit", {})
        mem_report = orbit_report.get("measurementErrorMitigation", {})
        pub_summaries.append(
            {
                **record,
                "function_job_id": jobs[job_index].job_id,
                "runtime_batch_id": runtime_batch.session_id,
                "success_probability": success,
                "raw_success_probability": raw_success,
                "orbit_mode": orbit_report.get("mode"),
                "transpilation_mode": orbit_report.get("transpilationMode"),
                "physical_layout": orbit_report.get("physicalLayout"),
                "dd_status": orbit_report.get("status", "not_applied"),
                "num_sequences_added": orbit_report.get(
                    "numSequencesAdded", 0
                ),
                "num_gaps_filled": orbit_report.get("numGapsFilled", 0),
                "dynamic_dd_seq": orbit_report.get("dynamicDdSeq"),
                "mem_status": mem_report.get("status", "not_requested"),
                "warnings": orbit_report.get("warnings", [])
                + mem_report.get("warnings", []),
            }
        )

process_fidelity = defaultdict(dict)
raw_process_fidelity = defaultdict(dict)
mean_success_probability = defaultdict(dict)
raw_mean_success_probability = defaultdict(dict)

for (n_qubits, label), probabilities in sorted(grouped_success.items()):
    n_key = str(n_qubits)
    process_fidelity[n_key][label] = (
        process_fidelity_from_success_probabilities(probabilities)
    )
    mean_success_probability[n_key][label] = float(np.mean(probabilities))

for (n_qubits, label), probabilities in sorted(grouped_raw_success.items()):
    n_key = str(n_qubits)
    raw_process_fidelity[n_key][label] = (
        process_fidelity_from_success_probabilities(probabilities)
    )
    raw_mean_success_probability[n_key][label] = float(np.mean(probabilities))

process_fidelity = dict(process_fidelity)
raw_process_fidelity = dict(raw_process_fidelity)
mean_success_probability = dict(mean_success_probability)
raw_mean_success_probability = dict(raw_mean_success_probability)

{
    "runtime_batch_id": runtime_batch.session_id,
    "function_job_ids": {
        job_index: job.job_id for job_index, job in enumerate(jobs)
    },
    "n_groups": {
        job_index: group for job_index, group in enumerate(N_GROUPS)
    },
    "process_fidelity": process_fidelity,
    "mean_success_probability": mean_success_probability,
}
{'runtime_batch_id': '80120e36-436d-46c7-96c9-597ec86060c1',
 'function_job_ids': {0: '2b6b05ac-0136-40f0-94bf-ade5658f5f4f',
  1: '4f046fd4-80e4-460b-87c7-e7252691f764',
  2: '6d70d64d-fa38-4ca2-9cbd-ffda5d8c99be'},
 'n_groups': {0: [40, 2, 7, 15, 10],
  1: [35, 3, 6, 20, 9],
  2: [30, 4, 5, 25, 8]},
 'process_fidelity': {'2': {'dynamic/orbit': 0.9870551835473073,
   'dynamic/raw': 0.9912537998030566,
   'unitary/raw': 0.9884650767434809},
  '3': {'dynamic/orbit': 0.9662998634131841,
   'dynamic/raw': 0.9699631603283018,
   'unitary/raw': 0.9388637172865901},
  '4': {'dynamic/orbit': 0.9271266520750502,
   'dynamic/raw': 0.7334377020091254,
   'unitary/raw': 0.9010122207121433},
  '5': {'dynamic/orbit': 0.8883501513887149,
   'dynamic/raw': 0.6577660260669806,
   'unitary/raw': 0.7806443417987445},
  '6': {'dynamic/orbit': 0.8524225652033044,
   'dynamic/raw': 0.4444025126308521,
   'unitary/raw': 0.7167426842521228},
  '7': {'dynamic/orbit': 0.832962085697061,
   'dynamic/raw': 0.2253787798698553,
   'unitary/raw': 0.5746335601063436},
  '8': {'dynamic/orbit': 0.7881895956180588,
   'dynamic/raw': 0.16909516699831612,
   'unitary/raw': 0.5408263851227074},
  '9': {'dynamic/orbit': 0.7422635627368794,
   'dynamic/raw': 0.0242474245097341,
   'unitary/raw': 0.4855953298367578},
  '10': {'dynamic/orbit': 0.7002274273149545,
   'dynamic/raw': 0.033718865729016285,
   'unitary/raw': 0.3607634828181049},
  '15': {'dynamic/orbit': 0.4694995355699914,
   'dynamic/raw': 7.70970394736842e-05,
   'unitary/raw': 0.054582117352985286},
  '20': {'dynamic/orbit': 0.24118032284867608,
   'dynamic/raw': 4.235164736271502e-22,
   'unitary/raw': 0.0},
  '25': {'dynamic/orbit': 0.027122712989729438,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '30': {'dynamic/orbit': 0.0003581886014704875,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '35': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '40': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0}},
 'mean_success_probability': {'2': {'dynamic/orbit': 0.987060546875,
   'dynamic/raw': 0.991259765625,
   'unitary/raw': 0.9884765625},
  '3': {'dynamic/orbit': 0.96630859375,
   'dynamic/raw': 0.969970703125,
   'unitary/raw': 0.939013671875},
  '4': {'dynamic/orbit': 0.9271484375,
   'dynamic/raw': 0.7337890625,
   'unitary/raw': 0.901318359375},
  '5': {'dynamic/orbit': 0.88837890625,
   'dynamic/raw': 0.657861328125,
   'unitary/raw': 0.78115234375},
  '6': {'dynamic/orbit': 0.85244140625,
   'dynamic/raw': 0.44453125,
   'unitary/raw': 0.71728515625},
  '7': {'dynamic/orbit': 0.8330078125,
   'dynamic/raw': 0.22568359375,
   'unitary/raw': 0.575390625},
  '8': {'dynamic/orbit': 0.788232421875,
   'dynamic/raw': 0.169189453125,
   'unitary/raw': 0.541796875},
  '9': {'dynamic/orbit': 0.742333984375,
   'dynamic/raw': 0.0244140625,
   'unitary/raw': 0.487353515625},
  '10': {'dynamic/orbit': 0.70029296875,
   'dynamic/raw': 0.033935546875,
   'unitary/raw': 0.363037109375},
  '15': {'dynamic/orbit': 0.4697265625,
   'dynamic/raw': 0.00029296875,
   'unitary/raw': 0.055615234375},
  '20': {'dynamic/orbit': 0.241357421875,
   'dynamic/raw': 4.8828125e-05,
   'unitary/raw': 0.0},
  '25': {'dynamic/orbit': 0.041015625, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '30': {'dynamic/orbit': 0.0013671875,
   'dynamic/raw': 0.0,
   'unitary/raw': 0.0},
  '35': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0},
  '40': {'dynamic/orbit': 0.0, 'dynamic/raw': 0.0, 'unitary/raw': 0.0}}}
Periksa metadata Orbit DD
Ringkasan di bawah ini memeriksa metadata PUB dynamic/orbit alih-alih mengasumsikan bahwa DD yang diminta telah disisipkan. Periksa status, urutan DD dinamis yang dilaporkan, peringatan, dan jumlah gap yang diisi serta urutan yang ditambahkan. Penyisipan yang berhasil seharusnya menghasilkan jumlah bukan nol untuk setidaknya beberapa PUB, tetapi nilai pastinya bergantung pada circuit yang dijadwalkan, batasan pewaktuan backend, dan ukuran circuit. Metadata ini menggambarkan urutan yang diterapkan Orbit; ini tidak boleh diberi label sebagai protokol FC-DD dari paper kecuali laporan tersebut secara eksplisit menetapkan kesetaraan itu.
dd_summary = defaultdict(lambda: Counter())
sequence_totals = defaultdict(int)
warning_examples = []

for summary in pub_summaries:
    if summary["label"] != "dynamic/orbit":
        continue
    n_key = str(summary["n_qubits"])
    dd_summary[n_key][summary["dd_status"]] += 1
    sequence_totals[n_key] += int(summary.get("num_sequences_added") or 0)
    if summary.get("warnings") and len(warning_examples) < 5:
        warning_examples.append(
            {
                "n_qubits": summary["n_qubits"],
                "target_decimal": summary["target_decimal"],
                "warnings": summary["warnings"],
            }
        )

{
    "dynamic_orbit_dd_status_counts": {
        key: dict(value) for key, value in dd_summary.items()
    },
    "dynamic_orbit_sequences_added": dict(sequence_totals),
    "warning_examples": warning_examples,
}
{'dynamic_orbit_dd_status_counts': {'40': {'dd_inserted': 20},
  '2': {'dd_inserted': 20},
  '7': {'dd_inserted': 20},
  '15': {'dd_inserted': 20},
  '10': {'dd_inserted': 20},
  '35': {'dd_inserted': 20},
  '3': {'dd_inserted': 20},
  '6': {'dd_inserted': 20},
  '20': {'dd_inserted': 20},
  '9': {'dd_inserted': 20},
  '30': {'dd_inserted': 20},
  '4': {'dd_inserted': 20},
  '5': {'dd_inserted': 20},
  '25': {'dd_inserted': 20},
  '8': {'dd_inserted': 20}},
 'dynamic_orbit_sequences_added': {'40': 31200,
  '2': 40,
  '7': 840,
  '15': 4200,
  '10': 1800,
  '35': 23800,
  '3': 120,
  '6': 600,
  '20': 7600,
  '9': 1440,
  '30': 17400,
  '4': 240,
  '5': 400,
  '25': 12000,
  '8': 1120},
 'warning_examples': [{'n_qubits': 40,
   'target_decimal': 853235401719,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 954673909846,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 524641045908,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 185651043478,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']},
  {'n_qubits': 40,
   'target_decimal': 587114273567,
   'warnings': ['Post-DD x/y pulses are rewritten into the target basis (e.g. sx) for ISA compliance; this shifts exact pulse timing within each gap, so DD spacing is approximate. A future release will emit native pulses directly.',
    'MEM was applied unconditionally to the returned output bitstring without inferring whether each bit came from a terminal measurement or a mid-circuit measurement. This is meaningful for bits intended as circuit outputs, but Orbit does not retroactively or in real time change conditional branches that used unmitigated measurement results.']}]}
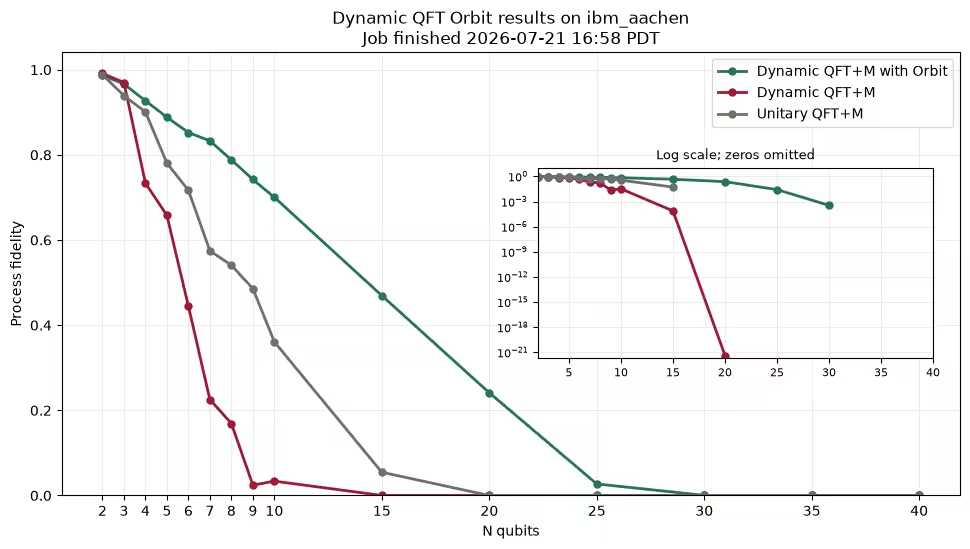
Plot kurva process-fidelity
Plot ini menunjukkan estimasi titik process-fidelity QFT+M yang di-sampling versus jumlah qubit untuk ketiga strategi. dynamic/raw dan dynamic/orbit berbagi layout fisik pada setiap ukuran; unitary/raw menggunakan layout dan routing transpiler.
Berbeda dengan Gambar 2a, plot ini tidak menunjukkan kurva unitary-dengan-DD atau uncertainty band, dan kurva mentahnya tidak dimitigasi readout. Sebaiknya ini dibaca sebagai perbandingan penskalaan bergaya Gambar-2a untuk workflow Orbit ini, bukan sebagai reproduksi langsung dari kurva yang dipublikasikan.
from datetime import datetime
from zoneinfo import ZoneInfo

closed_at = runtime_batch.details()["closed_at"]  # "2026-07-22T00:08:54.89Z"
closed_dt = datetime.fromisoformat(closed_at.replace("Z", "+00:00"))
closed_local = closed_dt.astimezone(ZoneInfo("America/Los_Angeles"))
labels = ["dynamic/orbit", "dynamic/raw", "unitary/raw"]
colors = {
    "dynamic/orbit": "#26735b",
    "dynamic/raw": "#9b1c31",
    "unitary/raw": "#6e6e6e",
}
pretty_labels = {
    "dynamic/orbit": "Dynamic QFT+M with Orbit",
    "dynamic/raw": "Dynamic QFT+M",
    "unitary/raw": "Unitary QFT+M",
}

series = []
for label in labels:
    values = [process_fidelity[str(n)][label] for n in N_VALUES]
    log_values = [value if value > 0.0 else float("nan") for value in values]
    series.append((label, values, log_values))

nonzero_values = [
    value
    for _, _, log_values in series
    for value in log_values
    if value > 0.0
]
if not nonzero_values:
    raise RuntimeError(
        "No nonzero process-fidelity values found for log inset"
    )
log_floor = min(nonzero_values) / 2

fig, ax = plt.subplots(figsize=(9.8, 5.6))
for label, values, _ in series:
    ax.plot(
        N_VALUES,
        values,
        marker="o",
        linewidth=2.0,
        markersize=5,
        color=colors[label],
        label=pretty_labels[label],
    )

ax.set_xlabel("N qubits")
ax.set_ylabel("Process fidelity")
finished_time_for_title = globals().get("finished_local", closed_local)
ax.set_title(
    f"Dynamic QFT Orbit results on {IBM_BACKEND_NAME}\n"
    f"Job finished {finished_time_for_title:%Y-%m-%d %H:%M %Z}"
)
ax.set_xticks(N_VALUES)
ax.set_ylim(bottom=0)
ax.grid(axis="both", alpha=0.25)
ax.legend(loc="upper right")

inset = ax.inset_axes([0.53, 0.31, 0.44, 0.43])
for label, _, log_values in series:
    inset.plot(
        N_VALUES,
        log_values,
        marker="o",
        linewidth=2.0,
        markersize=5,
        color=colors[label],
    )
inset.set_yscale("log")
inset.set_ylim(bottom=log_floor)
inset.set_xlim(min(N_VALUES), max(N_VALUES))
inset.set_title("Log scale; zeros omitted", fontsize=9)
inset.grid(axis="both", alpha=0.25)
inset.tick_params(axis="both", labelsize=8)
inset.patch.set_alpha(0.96)

fig.tight_layout()
plt.show()
Referensi
Langkah selanjutnya
-
Lihat dokumentasi panduan Orbit dan referensi API.
-
Coba backend yang berbeda, layout alternatif, atau bereksperimen dengan urutan dynamical decoupling alternatif yang diaktifkan orbit dengan mengubah opsi
dd_strategy. Perlu diingat bahwa karena sifat eksperimental dari circuit dinamis, kamu harus berhati-hati terhadap kemungkinan mode kegagalan job (lihat [3] dan [4]). Jika kamu menemukan nilai stretch negatif [3], coba urutan DD yang lebih kecil (pulsa lebih sedikit). Jika kamu menemukan [4], tingkatkanNUM_BATCH_JOBS, kurangiM, atau kurangi nilai terbesar dalamN_VALUES.