Segarkan properti backend dengan benchmarking real-time
Estimasi penggunaan: 3 menit pada ibm_kingston (CATATAN: Ini hanya estimasi. Waktu eksekusi kamu mungkin berbeda.)
Hasil pembelajaran
-
Mengapa properti yang dilaporkan oleh QPU dapat tertinggal dari perilaku device saat ini, dan kapan layak untuk mengukurnya kembali sendiri
-
Apa yang diukur oleh masing-masing dari lima eksperimen karakterisasi standar (readout, randomized benchmarking satu-qubit, randomized benchmarking dua-qubit berlapis, , dan )
-
Cara menjalankan seluruh rangkaian karakterisasi dalam satu panggilan atau langkah demi langkah, dan mendapatkan kembali objek backend dengan properti yang telah disegarkan
-
Cara membandingkan properti yang diukur dengan properti yang dilaporkan, dan mengapa beberapa perbedaan mencerminkan metodologi pengukuran alih-alih drift device
Prasyarat
-
Alur kerja Qiskit patterns
-
Mode eksekusi Qiskit Runtime, khususnya batch mode
-
Cara menjelajahi informasi QPU, seperti properti backend dan data kalibrasi
Latar belakang
Setiap QPU IBM Quantum® melaporkan sekumpulan properti yang menggambarkan seberapa baik kinerja masing-masing qubit-nya saat ini: waktu relaksasi (), waktu koherensi (), error readout, serta error gate satu- dan dua-qubit. Angka-angka ini penting dalam praktiknya. Transpiler menggunakannya untuk memutuskan qubit fisik mana yang seharusnya menjalankan circuit kamu, teknik mitigasi error bergantung padanya, dan kamu mungkin menggunakannya untuk menilai apakah sebuah device bekerja cukup baik untuk sebuah eksperimen.
Properti yang dilaporkan berasal dari prosedur kalibrasi yang biasanya berjalan sekitar sekali sehari. Namun, qubit superkonduktor dapat mengalami drift dalam skala waktu yang lebih singkat, dan cacat sementara (yang disebut sistem dua-tingkat) dapat untuk sementara menurunkan kualitas qubit yang terlihat sangat baik saat kalibrasi. Selain itu, sebuah job seringkali ditranspilasi jauh sebelum benar-benar dieksekusi, sehingga keputusan yang didasarkan pada properti yang dilaporkan bisa bergantung pada informasi yang sudah usang. Tutorial Real-time benchmarking for qubit selection menunjukkan seberapa besar properti ini dapat berfluktuasi dari hari ke hari, dan membangun alur kerja karakterisasi lengkap secara manual dari masing-masing Qiskit Experiments.
Tutorial ini menunjukkan versi yang disederhanakan dari alur kerja tersebut, dengan menggunakan utilitas BackendCharacterization dari Qiskit Device Benchmarking, yang mengemas pembuatan eksperimen, pengiriman job, dan curve fitting menjadi beberapa panggilan saja. Kamu menghabiskan sekitar 70 detik waktu QPU dan mendapatkan kembali objek backend yang propertinya mencerminkan device saat ini, siap dibandingkan dengan nilai yang dilaporkan atau diteruskan ke tool hilir.
Eksperimen karakterisasi
Rangkaian eksperimen ini mengukur lima properti, masing-masing dengan eksperimen standar:
-
Error readout (
readout): Setiap qubit disiapkan dalam keadaan atau dan langsung diukur. Probabilitas membaca keadaan yang salah memberikan error state preparation and measurement (SPAM). -
Error gate satu-qubit (
rb_1q): Randomized benchmarking (RB) menjalankan urutan gate Clifford satu-qubit acak yang secara ideal tersusun menjadi identity. Cara probabilitas survival meluruh seiring panjang urutan menghasilkan rata-rata error per gate, terlepas dari error SPAM. -
Error gate dua-qubit (
rb_2q): Ide RB yang sama diterapkan pada lapisan penuh gate dua-qubit yang tidak tumpang tindih yang dijalankan secara bersamaan, seperti pada eksperimen layer fidelity. Karena banyak gate berjalan sekaligus, tingkat error yang dihasilkan mencakup efek crosstalk dan lebih mendekati apa yang sebenarnya dialami oleh circuit yang dalam. -
(
t1): Setiap qubit dieksitasi dan diukur setelah penundaan yang meningkat. Peluruhan populasi keadaan tereksitasi memberikan waktu relaksasi. -
(
t2): Eksperimen Hahn echo menempatkan setiap qubit dalam superposisi, menerapkan pulsa echo di tengah penundaan, dan mengukur seberapa cepat koherensi fase hilang. Secara default satu echo digunakan; varian multi-echo (bergaya CPMG) didemonstrasikan di akhir tutorial ini.
Apa yang dilakukan dan tidak dilakukan oleh penyegaran
Ingat tiga hal berikut saat menggunakan alur kerja ini:
-
Properti yang disegarkan hanya ada dalam objek backend yang dikembalikan kepada kamu. Tidak ada yang berubah pada device itu sendiri atau pada data kalibrasi yang dilaporkan IBM Quantum kepada pengguna lain.
-
Nilai yang diukur adalah snapshot yang diambil dengan metodologi tertentu. Beberapa di antaranya, terutama error dua-qubit berlapis dan nilai single-echo paralel, diukur secara berbeda dari data kalibrasi yang dilaporkan, sehingga sebagian dari selisih apa pun yang kamu amati bersifat metodologis, bukan drift. Tutorial ini menunjukkan di mana hal itu terjadi.
-
Karakterisasi itu sendiri memakan waktu QPU (sekitar 70 detik untuk rangkaian penuh pada prosesor Heron r2), yang merupakan harga dari informasi yang terkini.
Alur kerja ini mengikuti empat langkah dari sebuah Qiskit pattern:
-
Langkah 1: Memetakan input klasik ke masalah kuantum. Pilih device dan sekumpulan properti yang akan diukur.
-
Langkah 2: Mengoptimalkan masalah untuk eksekusi hardware kuantum. Utilitas ini membangun circuit eksperimen langsung dalam gate native device dan memparalelkannya di seluruh chip.
-
Langkah 3: Eksekusi menggunakan Qiskit primitives. Eksperimen berjalan sebagai job Sampler di dalam sebuah batch.
-
Langkah 4: Pasca-pemrosesan dan mengembalikan hasil dalam format klasik yang diinginkan. Fit data pengukuran ke dalam peta error per-qubit, segarkan backend, dan bandingkan properti yang diukur dengan yang dilaporkan.
Persyaratan
Sebelum memulai tutorial ini, pastikan kamu telah menginstal berikut ini:
-
Qiskit SDK v2.0 atau yang lebih baru, dengan dukungan visualisasi
-
Qiskit Runtime v0.40 atau yang lebih baru (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, yang juga menginstal Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Pengaturan
Impor library yang diperlukan.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
Rangkaian karakterisasi membangun beberapa eksperimen, mengirimkan banyak job, dan melakukan fit hasilnya, yang bisa memakan waktu beberapa menit secara total. Aktifkan logging tingkat INFO agar setiap tahap mencetak progresnya saat terjadi.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Contoh simulator skala kecil
Tutorial ini tidak menyertakan contoh simulator. Alur kerja ini mengukur ketidaksempurnaan fisik dari sebuah device tertentu: seberapa cepat qubit-nya mengalami relaksasi dan dephasing, dan seberapa sering gate serta readout-nya gagal. Simulator ideal tidak memiliki ketidaksempurnaan ini, sehingga tidak ada yang perlu dikarakterisasi. Kamu bisa melampirkan model noise sintetis ke fake backend, tetapi eksperimen tersebut hanya akan mengembalikan angka yang kamu masukkan sendiri. Karena itu, kita langsung melanjutkan ke hardware, dibagi menjadi empat langkah dari sebuah Qiskit pattern.
Contoh hardware skala besar
Langkah 1: Memetakan input klasik ke masalah kuantum
Dalam alur kerja ini, "masalah"-nya adalah device itu sendiri: input klasiknya adalah QPU yang ingin kamu karakterisasi dan daftar properti yang akan diukur, dan eksperimen kuantumnya adalah circuit karakterisasi yang dihasilkan darinya.
Pertama, pilih backend. Tutorial ini menggunakan ibm_kingston, sebuah prosesor Heron r2 dengan 156 qubit; kamu bisa menggantinya dengan device IBM Quantum mana pun yang kamu miliki akses (atau pilih satu dengan service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Selanjutnya, pilih properti mana yang akan diukur. Kamu bisa memberikan subset apa pun dari eksperimen berikut:
-
readout: eksperimen SPAM (state preparation and measurement) -
rb_1q: randomized benchmarking satu-qubit yang terisolasi -
rb_2q: randomized benchmarking dua-qubit simultan dari eksperimen layer fidelity -
t2: eksperimen Hahn echo (satu echo secara default) -
t1: eksperimen relaksasi
Jalankan rangkaian penuh untuk mendapatkan gambaran lengkap tentang device; hapus entri dari daftar jika kamu hanya peduli pada beberapa properti dan ingin menghemat waktu QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Langkah 2: Mengoptimalkan masalah untuk eksekusi hardware kuantum
Pada sebagian besar tutorial, di sinilah kamu akan mentranspilasi circuit kamu. Di sini, BackendCharacterization menangani hal itu secara internal. Ia membangun circuit eksperimen langsung dalam gate native device, menjalankan eksperimen satu-qubit pada semua qubit secara paralel, dan menjadwalkan benchmarking dua-qubit pada lapisan-lapisan terpisah dari coupling map sehingga seluruh device tercakup hanya dengan beberapa job. Karena paralelisasi ini, seluruh rangkaian hanya memakan sekitar 70 detik waktu QPU.
Inisialisasi kelas yang mengelola alur kerja ini:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Langkah 3: Eksekusi menggunakan Qiskit primitives
Metode run_experiments membangun circuit dan mengirimkannya sebagai job Sampler. Jalankan ini di dalam konteks Batch agar job-job dijadwalkan bersama pada QPU, dan metode ini mengembalikan hasil setelah semua job dikirim. (Kamu juga bisa menjalankannya di luar batch, atau di dalam Session.)
Kamu mungkin melihat peringatan tentang backend yang diteruskan sementara session context manager terbuka. Ini normal dan bisa diabaikan dengan aman.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Metode ini mengembalikan job yang dikirimkan sebagai dictionary yang diberi kunci berdasarkan eksperimen, yang berguna untuk melacaknya pada dashboard IBM Quantum Platform atau untuk debugging.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Langkah 4: Pasca-pemrosesan dan mengembalikan hasil dalam format klasik yang diinginkan
Analisis hasil
Metode analyze_results menunggu job selesai dan melakukan fit terhadap data pengukuran: peluruhan eksponensial untuk dan , peluruhan probabilitas survival untuk eksperimen RB, dan matriks assignment untuk readout. Metode ini mengembalikan dictionary peta error, satu entri per properti yang diukur, masing-masing memetakan qubit (atau pasangan qubit) ke nilai yang diukurnya.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Peta ini mencakup error readout, error gate x dan sx satu-qubit, error dua-qubit berlapis (lf_error_map, dari eksperimen layer fidelity), serta waktu dan dalam detik.
Perbarui properti backend
Metode update_backend menulis nilai yang diukur ke dalam properti salinan backend dan mengembalikannya. Objek backend asli tetap menyimpan data kalibrasi yang dilaporkan, sehingga kita dapat membandingkan keduanya, seperti ditunjukkan di bawah ini. Ingat bahwa pembaruan ini murni bersifat lokal pada sesi Python kamu; ini tidak mengubah apa pun pada device atau bagi pengguna lain.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Bandingkan properti yang diukur dengan yang dilaporkan
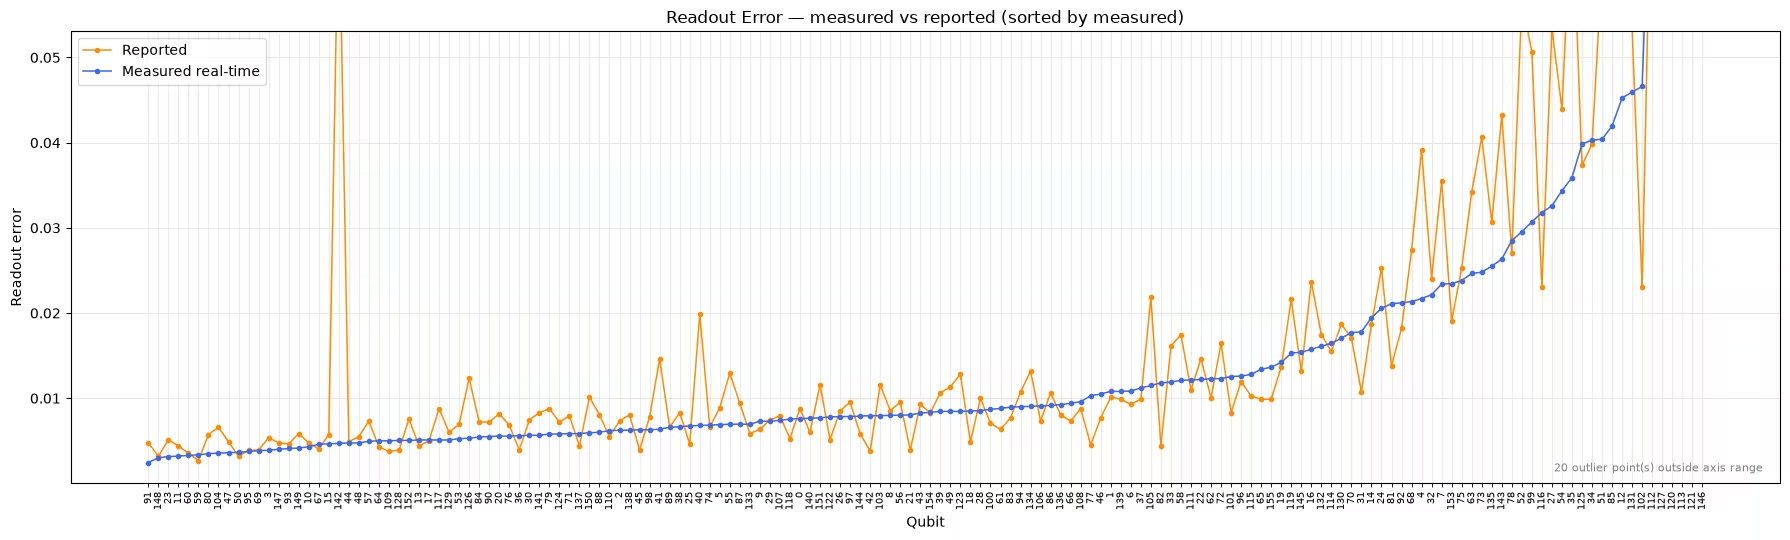
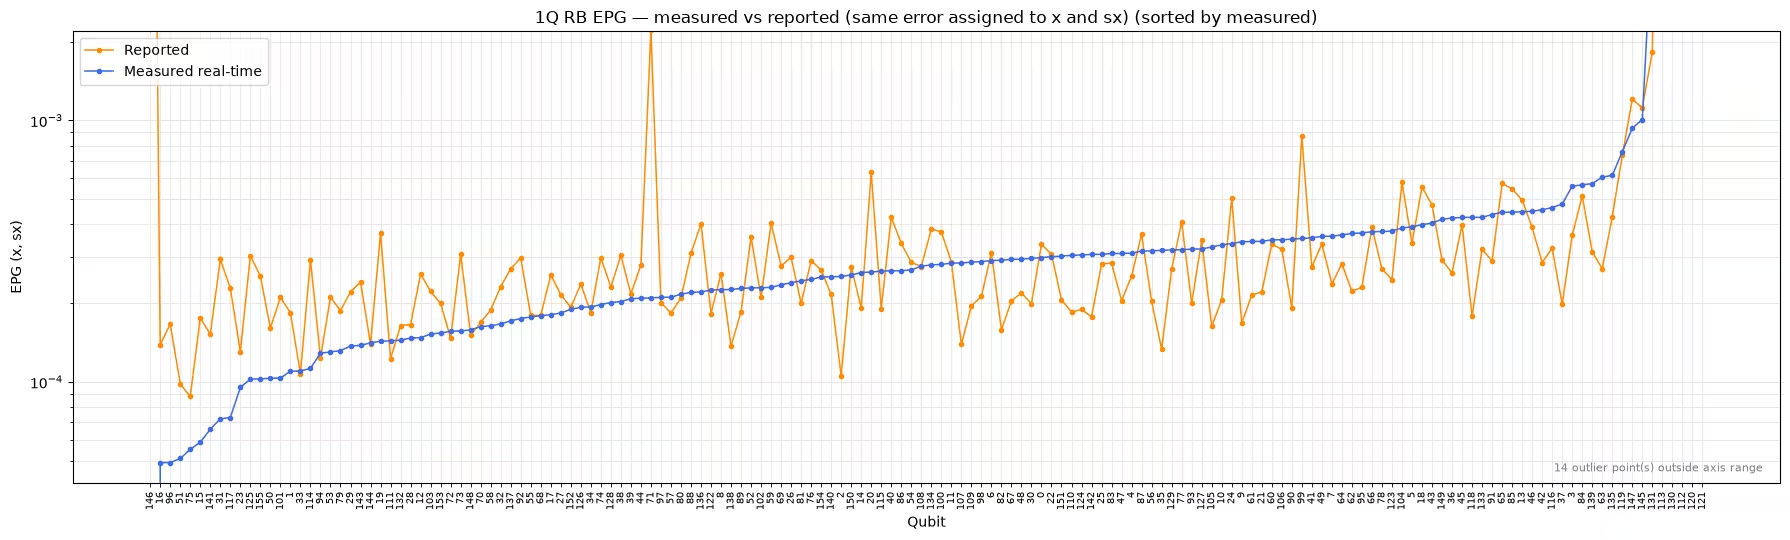
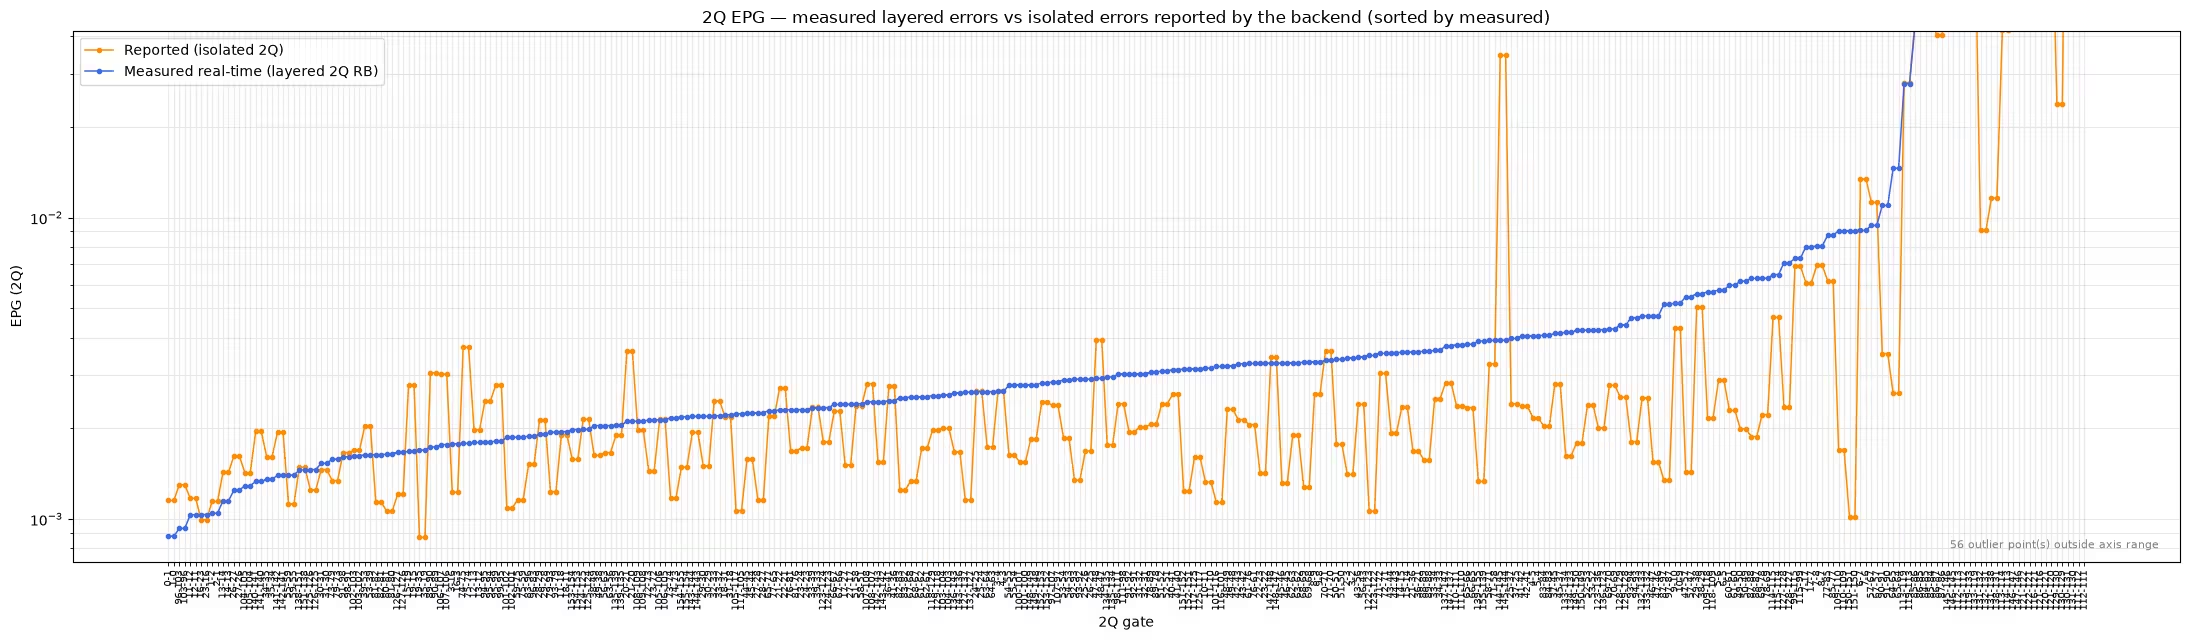
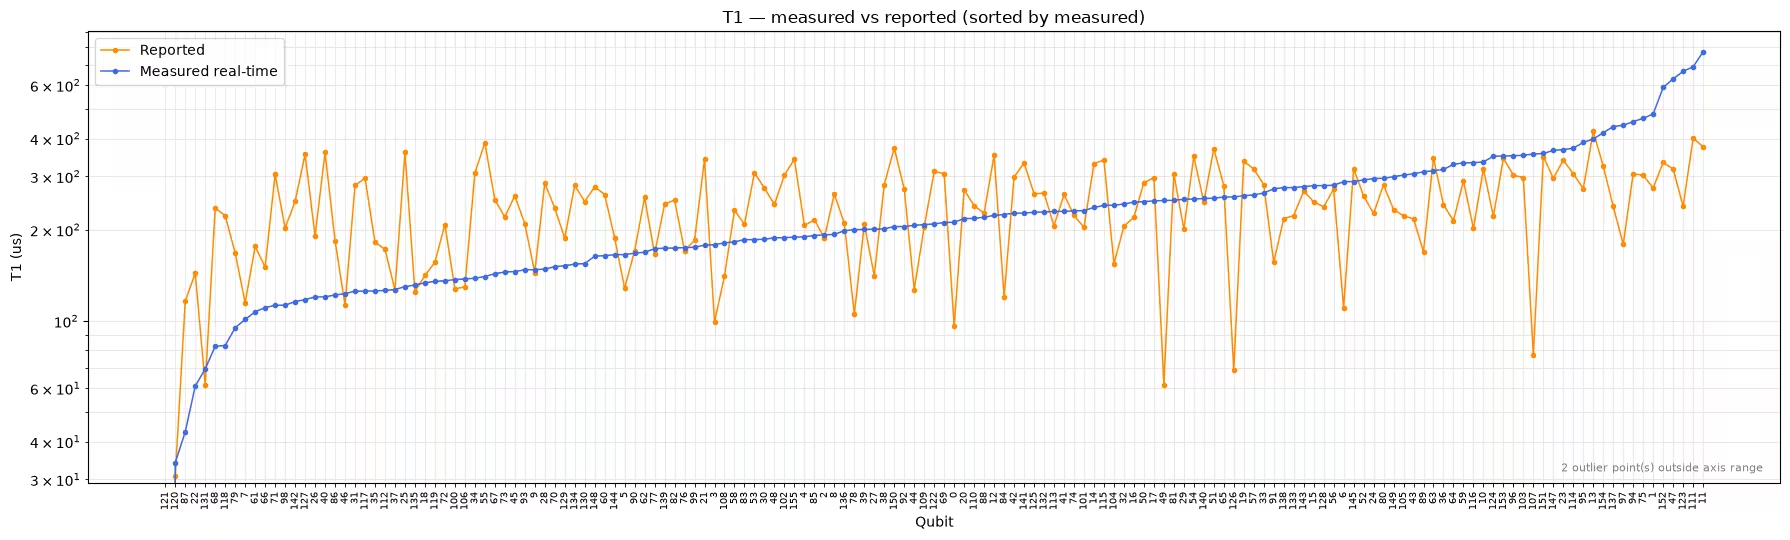
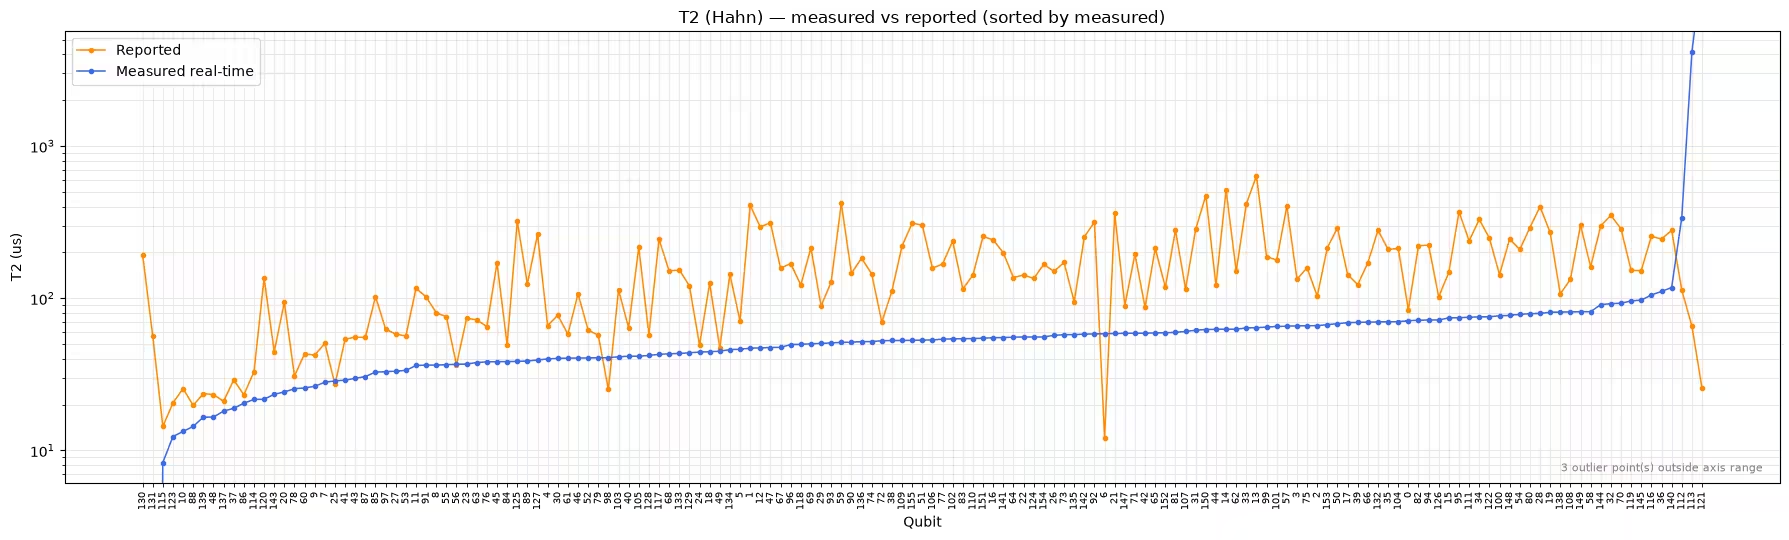
Terakhir, plot properti real-time yang diukur terhadap nilai yang dilaporkan oleh backend. Pada setiap panel, qubit (atau pasangan qubit) diurutkan berdasarkan nilai yang diukur, sehingga kurva yang diukur mulus secara konstruksi dan sebaran nilai yang dilaporkan di sekitarnya menunjukkan di mana keduanya tidak sepakat. Satu plot ditampilkan untuk RB satu-qubit karena error per gate yang diukur sama diberikan pada gate x dan sx. Batas sumbu dipilih dari mayoritas data sehingga beberapa outlier ekstrem tidak memampatkan plot; titik-titik di luar rentang dihitung dalam anotasi pada plot (atau berikan ylim untuk mengganti batasnya).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
Plot-plot ini memerlukan pembacaan yang cermat, karena tidak setiap selisih antara kedua kurva berarti device telah mengalami drift:
-
Readout dan error satu-qubit: Nilai yang diukur mengikuti nilai yang dilaporkan untuk sebagian besar qubit, sementara nilai yang dilaporkan untuk segelintir qubit jauh berbeda dari kurva yang diukur. Ketidaksesuaian lokal itulah drift yang dirancang untuk ditangkap oleh alur kerja ini.
-
: Kedua kumpulan data tersebar di sekitar satu sama lain tanpa offset sistematis, yang konsisten dengan yang berfluktuasi secara alami seiring waktu.
-
Error dua-qubit: Nilai yang diukur berada secara sistematis di atas nilai yang dilaporkan. Hal ini memang wajar karena nilai yang dilaporkan diukur pada gate yang terisolasi, sementara eksperimen layer fidelity menjalankan banyak gate secara bersamaan sehingga mencakup crosstalk. Angka berlapis ini lebih relevan untuk circuit yang dalam, tetapi tidak secara langsung dapat dibandingkan dengan data kalibrasi yang dilaporkan.
-
: Nilai yang diukur berada jauh di bawah nilai yang dilaporkan untuk sebagian besar qubit. Sekali lagi, metodologi berperan besar, seperti yang dibahas pada bagian berikutnya.
Periksa hasil eksperimen individual
Kamu juga bisa memeriksa hasil mentah dari masing-masing eksperimen karakterisasi melalui properti experiment_data, yang mengembalikan objek ExperimentData Qiskit Experiments yang mendasarinya. Sebagai contoh, berikut ini menampilkan kurva peluruhan yang diukur untuk satu qubit, yang berguna untuk memeriksa kualitas fit sebelum mempercayai angka yang dihasilkannya.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Ukur T2 dengan rangkaian dynamical decoupling
Secara default, eksperimen menerapkan satu Hahn echo dan mengukur semua qubit secara paralel, yang, seperti ditunjukkan oleh plot perbandingan di atas, dapat menghasilkan nilai yang jelas lebih rendah daripada yang dilaporkan backend. Salah satu hipotesisnya adalah jumlah echo: nilai yang dilaporkan mungkin dikalibrasi dengan dynamical decoupling, yang menekan noise frekuensi rendah. Untuk mengujinya, jalankan karakterisasi khusus dengan t2_num_echoes diatur ke nilai yang lebih besar, yang menerapkan rangkaian pulsa echo bergaya CPMG. Penundaan mewakili total waktu evolusi bebas dalam kedua kasus, sehingga nilai yang di-fit dapat langsung dibandingkan dengan hasil single-echo.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
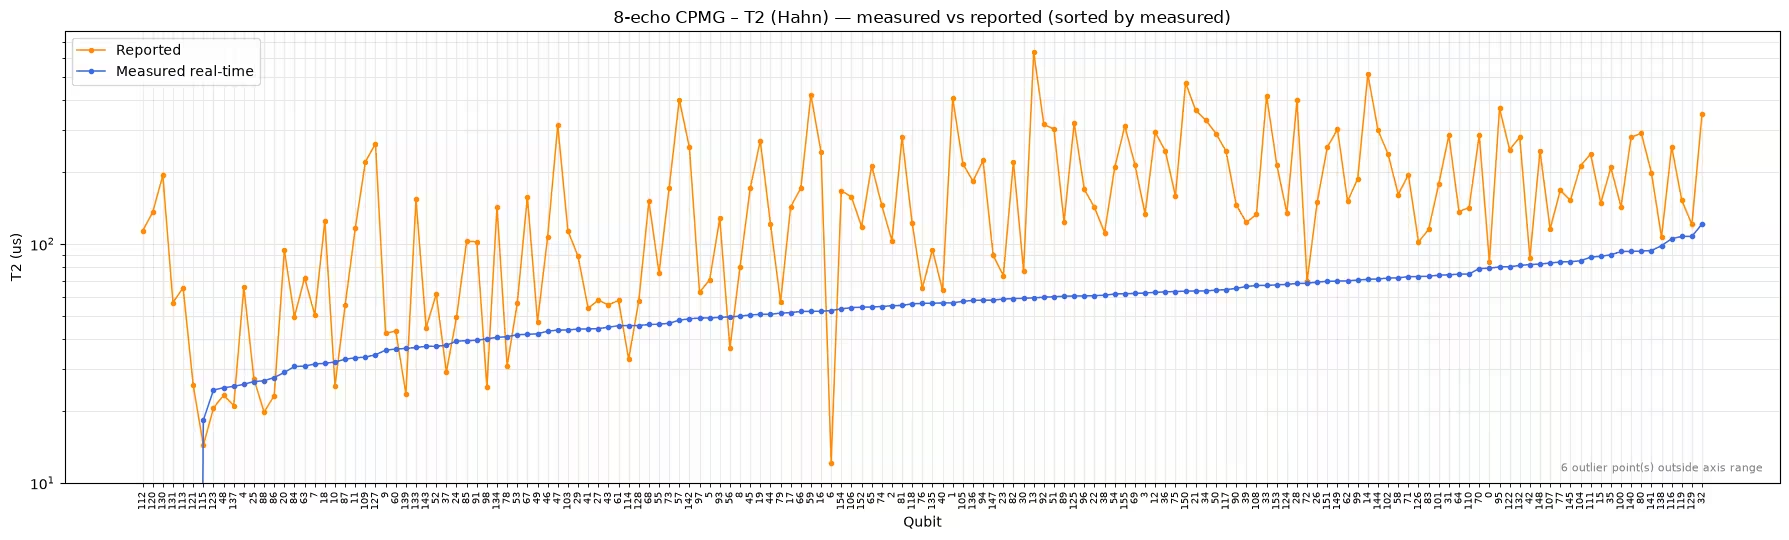
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
Dalam eksekusi ini, echo tambahan hampir tidak mengubah hasilnya: median 8-echo (56 µs) mendekati median single-echo (53 µs), dan keduanya masih jauh di bawah median yang dilaporkan (142 µs). Jumlah echo saja tidak menjelaskan selisih ini; perbedaan metodologis lain juga terlibat, seperti detail prosedur kalibrasi, pengukuran semua qubit secara paralel alih-alih secara terisolasi, dan sebagainya.
Pelajaran praktisnya adalah memperlakukan perbandingan (dan error dua-qubit berlapis) antar metodologi dengan hati-hati. Nilai yang disegarkan adalah snapshot yang konsisten secara internal, diambil dalam kondisi yang mendekati beban kerja nyata, yang membuatnya cocok untuk membandingkan qubit satu sama lain atau melacak sebuah device seiring waktu. Namun, selisih relatif terhadap data kalibrasi yang dilaporkan bukanlah bukti otomatis adanya drift.
Langkah 1–4 dipadatkan menjadi satu panggilan
Untuk penggunaan sehari-hari, kamu jarang membutuhkan hasil perantara. Metode run_and_update merangkai semua yang kamu lakukan di atas (membangun, mengirimkan, melakukan fit, dan memperbarui) menjadi satu panggilan yang mengembalikan backend yang telah disegarkan. Metode ini menerima daftar experiments yang sama (dan meneruskan opsi seperti t2_num_echoes), dan dapat pula dibungkus dalam konteks Batch atau Session.
Sel berikut tidak akan selesai dieksekusi sampai semua job dan post-processing selesai.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Objek backend_updated yang telah disegarkan kini siap digunakan di mana pun properti backend masuk ke dalam alur kerja kamu. Coba proses ini bersamaan dengan tutorial Real-time benchmarking for qubit selection untuk memilih qubit dengan performa terbaik saat mentranspilasi sebuah circuit. Karena device terus mengalami drift, segarkan propertinya mendekati waktu kamu benar-benar mengeksekusi beban kerja kamu.
Langkah selanjutnya
Jika kamu merasa pekerjaan ini menarik, kamu mungkin tertarik dengan materi berikut:
- Gunakan properti yang telah disegarkan untuk memilih qubit yang lebih baik dalam tutorial Real-time benchmarking for qubit selection
- Pelajari bagaimana data kalibrasi yang dilaporkan diekspos dalam panduan informasi QPU
- Jelajahi masing-masing eksperimen karakterisasi dalam dokumentasi Qiskit Experiments
- Jelajahi lebih banyak benchmark tingkat-device dalam repositori Qiskit Device Benchmarking