Pelajari keadaan kuantum bernoise dengan classical shadows
Perkiraan penggunaan: 34 menit pada prosesor Heron r2 (CATATAN: Ini hanya perkiraan. Waktu jalan kamu mungkin berbeda.)
Hasil pembelajaran
-
Kumpulkan pengukuran acak pada prosesor kuantum IBM® dari Julia dan simpan untuk analisis nanti
-
Periksa data pengukuran untuk mencari qubit dan gate yang rusak sebelum belajar
-
Fit model matrix product operator (MPO) dari keadaan bernoise ke classical shadows
-
Validasi model pada pengukuran held-out dan bandingkan dengan circuit ideal
Prasyarat
-
Classical shadows, seperti yang diperkenalkan di tutorial Shadow tomography of the Greenberger-Horne-Zeilinger (GHZ) state
-
Matriks densitas dan keadaan campuran, yang dibahas di Basics of quantum information
-
Menjalankan circuit dari Julia dengan
Qiskit.jldanQiskitIBMRuntime.jl, yang diperkenalkan di tutorial Simulate time evolution of the transverse-field Ising model
Latar belakang
Pada prosesor kuantum nyata, noise mengubah keadaan murni yang dirancang untuk disiapkan oleh sebuah circuit menjadi keadaan campuran . Tomografi keadaan kuantum penuh bisa merekonstruksi , tapi jumlah pengukuran yang dibutuhkannya tumbuh secara eksponensial terhadap jumlah qubit. Votto dkk. [1] sebaliknya mempelajari model ringkas dari untuk hingga 96 qubit dari pengukuran acak. Tutorial ini mengikuti alur kerja mereka.
Pada pengukuran acak [2], setiap qubit dirotasi oleh unitari acak independen lalu diukur dalam basis komputasi. Satu undian rotasi disebut measurement setting, dan setiap setting diulang sebanyak shot. Satu shot dengan bit hasil menghasilkan classical shadow [3]
yang rata-ratanya atas setting dan shot adalah . Tutorial prasyarat mengundi setiap dari tiga basis Pauli; tutorial ini, seperti makalahnya, mengundinya secara seragam dari semua unitari satu-qubit (Haar random), dan rumus yang sama berlaku.
Shadow memperkirakan properti beberapa qubit sekaligus. Makalah ini menggabungkannya menjadi matrix product operator (MPO), yang menuliskan matriks densitas sebagai rantai tensor kecil, satu per qubit; keadaan bernoise dengan korelasi jarak pendek hanya membutuhkan bond kecil di antara tensor yang bertetangga. Seperti algoritma density matrix renormalization group (DMRG), learner menyapu sepanjang rantai dan memperbarui satu tensor sekaligus, sehingga model cocok dengan shadow pada jendela qubit yang berpusat pada tensor itu (Persamaan 4 dalam makalah). Dimensi bond tetap selama pembaruan ini, jadi learner tidak pernah memotong model. Karena data hanya masuk lewat jendela-jendela ini, jumlah setting yang dibutuhkan tidak bertambah seiring panjang rantai.
Setting dibagi menjadi set pelatihan dan set pengujian. Pada set pengujian, makalah memperkirakan fidelitas maksimum antara dan model ,
Mengukur secara langsung akan membutuhkan pengukuran dalam jumlah eksponensial. Sebagai gantinya, makalah mengasumsikan approximate factorization condition (AFC): korelasi di meluruh dalam beberapa qubit, sehingga overlap dan purity global terfaktorkan menjadi suku-suku pada blok qubit bertetangga. Purity juga memberikan entropi Rényi-2 , yang mengukur seberapa campuran keadaan tersebut.
Makalah menyiapkan keadaan kicked-Ising berkedalaman
pada 96 qubit ibm_brisbane, prosesor Eagle, dengan 2.048 setting masing-masing 1.024 shot untuk . Gambar 1(c,d) dalam makalah melaporkan dua hasil untuk :
-
Model yang dipelajari mencapai dengan keadaan eksperimen pada , jauh di atas overlap keadaan ideal dengan eksperimen.
-
Entropi tumbuh secara linear, , dan entropi model sesuai dengan perkiraan independen dari set pengujian.
Tutorial ini memeriksa kedua hasil tersebut, pertama dalam simulasi delapan qubit di mana jawaban eksaknya diketahui, lalu dalam run 96-qubit baru pada ibm_fez, prosesor Heron r2. Learner-nya adalah implementasi Julia independen dari persamaan-persamaan dalam makalah dan suplemennya.
Persyaratan
Tutorial ini membutuhkan macOS atau Linux, karena Qiskit.jl belum mendukung Windows (Qiskit.jl issue #15). Kamu juga membutuhkan hal-hal berikut:
-
Julia 1.11, dari halaman unduhan Julia atau dengan
juliaup add 1.11, dan paketIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Untuk contoh perangkat keras, akun IBM Quantum® Platform dengan akses ke QPU yang punya setidaknya 96 qubit, dan kredensial tersimpan. Tanpa akun, kamu bisa menjalankan contoh perangkat keras dari pengukuran tersimpan hasil run
ibm_fezyang menghasilkan hasil di tutorial ini. Bagian lainnya berjalan tanpa akun.
Notebook ini memakai Qiskit.jl dan QiskitIBMRuntime.jl untuk membangun dan menjalankan circuit, RandomMeas.jl [4] untuk pengukuran acak (paket ini juga menyediakan ITensors.jl dan ITensorMPS.jl), serta NPZ.jl, JSON.jl, dan Plots.jl. Tutorial ini diuji dengan Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2, dan RandomMeas.jl 0.3.1.
Ada dua cara untuk menyiapkan environment:
-
Opsi 1: Instal versi terbaru yang kompatibel dari paket-paket ke environment sementara. Jalankan cell berikut tanpa perubahan.
-
Opsi 2: Reproduksi environment yang diuji secara persis. Setel
download_toml_files = truedi cell berikut. Cell ini mengunduhProject.tomldanManifest.tomldari repositori dokumentasi ke folderenv_tutorial/classical-shadows/di samping notebook ini, lalu menginstal versi persis dari setiap paket yang dicatat manifest, termasuk dependensi tidak langsung. Untuk detailnya, lihat dokumentasi Julia tentang file-file ini.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Persiapan
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Modul helper mpo_learning.jl, yang diunduh oleh cell Setup, mengimplementasikan learner. Tutorial memanggil fungsi-fungsi berikut darinya:
| Fungsi | Tujuan |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO eksak dari keadaan kicked-Ising ideal, atau dari keadaan setelah noise depolarisasi lokal |
split_settings(group; seed, train_fraction) | Menetapkan measurement setting secara acak ke set pelatihan dan pengujian (masing-masing separuh secara default) |
training_marginals(train; ell, prior) | Estimasi shadow dari setiap jendela pembelajaran, hanya dari setting pelatihan |
fitted_prior(ideal, train) | Prior untuk common randomized measurements (CRM), di-fit ke purity terukur dari setiap jendela, seperti dalam makalah |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Menyapu pembaruan satu-site dari makalah sepanjang rantai, mulai dari keadaan campuran maksimal |
max_fidelity(a, b), mpo_overlap(a, b) | eksak dan antara dua MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Estimasi AFC dari dan dari setting pengujian, dengan error bar jackknife |
Learner menyimpan MPO dalam basis Pauli. Ini menjaga model tetap Hermitian dengan trace satu, tapi tidak memaksa model menjadi semidefinit positif, jadi notebook melaporkan seberapa negatif nilai eigennya.
Contoh simulator skala kecil
Mulailah dengan sistem yang cukup kecil untuk dihitung semuanya secara eksak: keadaan kicked-Ising berkedalaman satu pada delapan qubit, dengan noise depolarisasi lokal 12% untuk memodelkan perangkat keras. Karena keadaan bernoise-nya diketahui, kamu bisa langsung membandingkan model yang dipelajari dengannya.
Langkah 1: Petakan input klasik ke masalah kuantum
Fungsi kicked_ising_reference mengembalikan keadaan eksak sebagai MPO. Dengan depolarization=0.12, vektor Bloch setiap qubit menyusut 12% setelah circuit.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Langkah 2: Optimalkan masalah untuk eksekusi di perangkat keras kuantum
Contoh ini mengambil sampel hasil pengukuran secara klasik, jadi tidak ada circuit yang perlu ditranspilasi. Contoh perangkat keras membahas langkah ini.
Langkah 3: Eksekusi memakai primitif Qiskit
Pakai RandomMeas.jl untuk mengundi 2.048 measurement setting Haar-random dan mengambil 256 shot dari masing-masingnya, lalu bagi setting secara merata menjadi set pelatihan dan pengujian. Bagi per setting, bukan per shot: shot dari setting yang sama berbagi rotasinya, jadi tidak independen.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Langkah 4: Pasca-proses dan kembalikan hasil dalam format klasik yang diinginkan
Pelajari model dengan parameter kedalaman-satu dari makalah: jendela yang memanjang qubit di setiap sisi tensor yang diperbarui, dimensi bond 4, dan 20 sweep yang dimulai dari keadaan campuran maksimal. Sweep pertama memperbarui pasangan tensor bertetangga, sehingga dimensi bond bisa tumbuh dari 1 ke 4; setiap sweep berikutnya memperbarui satu tensor sekaligus pada dimensi bond tetap itu.
Untuk mengurangi noise statistik dari shadow, makalah memakai common randomized measurements (CRM) [5]. Untuk setiap setting, ia mengurangi shadow rata-rata yang akan dihasilkan oleh tebakan prior dari keadaan itu pada setting yang sama, lalu menambahkan kembali nilai eksak prior. Koreksi ini rata-ratanya nol, jadi prior mengubah besar kesalahan statistik tapi bukan apa yang diperkirakan. Di sini prior-nya adalah keadaan ideal dengan depolarisasi lokal 10%, dekat dengan nilai sebenarnya 12%. Pada perangkat keras, tingkat noise tidak diketahui, jadi contoh perangkat keras mem-fit prior ke purity terukur, seperti yang dilakukan makalah.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
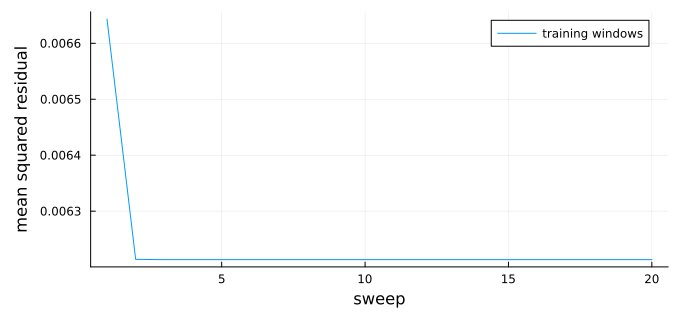
Residual mengukur seberapa jauh jendela model dari shadow pelatihan. Nilainya turun saat pembaruan satu-site dimulai, di sweep kedua, lalu tetap kira-kira konstan alih-alih mencapai nol, karena shadow mengandung noise statistik yang tidak bisa direproduksi oleh model dengan dimensi bond kecil.
Karena keadaan ini diketahui, kamu bisa membandingkan model yang dipelajari dengannya secara eksak, dan juga membandingkan dua tebakan paling sederhana dengannya: prior CRM dan keadaan ideal.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Model yang dipelajari lebih dekat ke keadaan bernoise daripada prior maupun keadaan ideal, jadi ia sudah mempelajari noise dari data. Nilai eigen negatifnya yang kecil berasal dari jumlah pengukuran yang terbatas.
Pada perangkat keras, keadaannya tidak diketahui, jadi kamu memperkirakan dari setting pengujian. AFC membagi rantai menjadi blok yang masing-masing berisi qubit dan mengaproksimasi purity dengan
dan dengan rasio overlap lokal yang sama. Dengan , kedua blok mencakup semua delapan qubit dan rumusnya eksak; dengan , ia bergantung pada asumsi faktorisasi. Error bar jackknife, yang menyisihkan satu setting pengujian setiap kali, hanya mencakup kesalahan statistik data pengujian, bukan keacakan pelatihan atau aproksimasi AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Kedua estimasi held-out sesuai dengan nilai eksak dalam batas error bar-nya.
Contoh perangkat keras skala besar
Sekarang jalankan eksperimen pada rantai 96-qubit dari ibm_fez, prosesor Heron r2. Seperti ibm_brisbane, ia punya coupling map heavy-hex dan tingkat noise yang mirip.
Pengumpulan data membutuhkan 1.024 job Sampler dan sekitar 34 menit waktu QPU. Kalau kamu tidak punya akses ke QPU dengan setidaknya 96 qubit, atau antreannya panjang, jalankan contoh perangkat keras dari pengukuran yang direkam pada ibm_fez pada 27 September 2026, yang menghasilkan hasil yang ditampilkan di tutorial ini. Dengan use_saved_data = true, notebook mengunduh pengukuran ini (15 MB) dari Zenodo [6] di Langkah 1 dan melewati pengiriman job di Langkah 3. Untuk mengumpulkan data sendiri, setel ke false.
use_saved_data = true; # set to false to collect new measurements on hardware
Langkah 1: Petakan input klasik ke masalah kuantum
Setiap setting membutuhkan satu circuit: circuit kicked-Ising, gate pada setiap qubit untuk , dan pengukuran setiap qubit. Mengambil sampel , dengan , , dan seragam di , membuat Haar random. Fungsi u3_matrix mengembalikan matriks , yang dipakai Langkah 4.
Anggarannya adalah 1.024 setelan dengan 1.024 shot, setengah dari jumlah setelan di makalah, dan dibagi rata antara pelatihan dan pengujian. Kalau ada data tersimpan, cell ini memuat sudut-sudut yang tercatat. Kalau tidak, cell ini mengambil sudut baru dan menyimpannya sebelum kamu mengirim apa pun, karena kamu tidak bisa menganalisis hasilnya tanpa sudut-sudut itu. Kalau file-nya sudah ada, cell ini memuatnya, sehingga sudut-sudut tetap cocok dengan hasil yang tersimpan setelah kamu me-restart Session.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Langkah 2: Optimalkan masalah untuk eksekusi di hardware kuantum
Sebuah rantai hanya sebaik qubit terburuknya, jadi pilih sendiri 96 qubit fisiknya. Fungsi transpile dari Qiskit.jl belum bisa menerima initial layout yang tetap, dan dalam uji di ibm_phoenix, layout yang dipilihnya menyertakan satu qubit dengan error pembacaan 51%. Rantai berikut adalah jalur 96 qubit di coupling map ibm_fez yang dipilih oleh layout sadar-error dari fungsi transpile Qiskit Python (dengan optimization_level=3) berdasarkan data kalibrasi tanggal 27 September 2026. Rata-rata error pembacaannya 1,6%, tetapi kisi heavy-hex punya sedikit jalur 96 qubit, dan jalur ini menyertakan qubit 35 yang error pembacaannya 15%. Kalibrasi berubah-ubah, jadi pilih rantai baru dari data kalibrasi terkini sebelum kamu menjalankan di hari lain atau di QPU lain.
Untuk mempertahankan rantai ini, tulis circuit langsung dalam native gate, bukan men-transpile-nya. Sebuah gate sama dengan sampai fase global. Dekomposisi ini mencakup rotasi acak sekaligus kick . Gate sama dengan gate CZ yang diikuti pada kedua qubit, sampai fase global. Karena gate ini diagonal, keduanya komut dengan gate CZ, jadi setiap qubit mengumpulkan satu per ikatan sebelum rotasi pengukurannya.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Langkah 3: Eksekusi menggunakan primitif Qiskit
QiskitIBMRuntime.jl menjalankan satu circuit per job Sampler, jadi pengumpulan data membutuhkan 1.024 job. Cell berikut menjaga hingga 32 job di antrean dan menyimpan hasil tiap setelan begitu job-nya selesai. Setiap shot dikembalikan sebagai vektor bit, dengan elemen adalah hasil dari qubit rantai ke-.
Kamu harus mengambil hasilnya di Session yang sama dengan yang mengirim job, karena QiskitIBMRuntime.jl belum bisa mencari job berdasarkan ID-nya (qiskit-ibm-runtime-c issue #28). Kalau sebuah job gagal, cell ini mengeluarkan peringatan dan lanjut. Kalau Session berhenti, jalankan lagi Langkah 1 sampai 3. Menjalankan ulang cell hanya mengirim setelan yang hasilnya belum ada. Dengan use_saved_data = true, cell tidak mengirim apa pun.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Langkah 4: Pasca-proses dan kembalikan hasil dalam format klasik yang diinginkan
Langkah ini hanya membaca data tersimpan: hasil run ibm_fez yang diunduh kalau use_saved_data bernilai true, atau kalau tidak, file yang ditulis Langkah 3. Jadi kamu bisa menjalankannya di Session baru tanpa mengirim job (jalankan dulu cell Setup, cell use_saved_data, dan Langkah 1). File yang diunduh menyimpan 96 hasil tiap shot yang dikemas dalam 12 byte, bit paling signifikan lebih dulu, jadi loader membongkarnya. RandomMeas.jl memberi label hasil 1 dan 2, jadi loader juga menambahkan 1 ke setiap bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Sebelum belajar, periksa datanya. Qubit yang rusak atau gate yang kalibrasinya buruk membuat state yang diukur jauh lebih campur di sekitarnya, dan bisa membuat learner divergen. Purity dari beberapa qubit bertetangga adalah tolok ukur bebas-model untuk noise ini: fungsi get_purity dari RandomMeas.jl memperkirakan untuk subsistem dengan membandingkan pasangan shot dari setelan yang sama. Hitung entropi Rényi-2 untuk setiap jendela enam qubit bertetangga, lalu bandingkan dengan jendela yang sama pada state ideal. Nilai idealnya bukan nol, karena setiap jendela terentang (entangled) dengan sisa rantai; noise menaikkannya, dan qubit yang rusak mendorong setiap jendela yang memuatnya ke arah maksimum enam.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
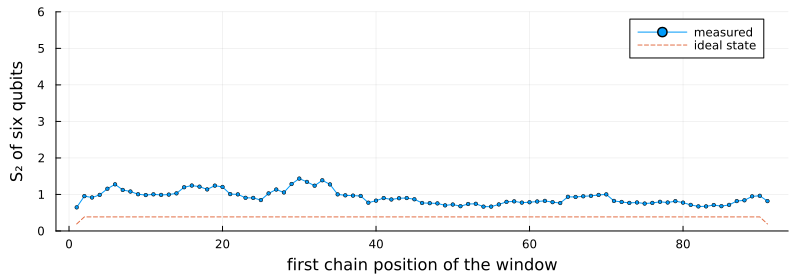
Setiap jendela lebih campur daripada state ideal, sekitar setengah bit sampai satu bit, dan bagian paling bising ada di sekitar posisi rantai 30 sampai 35. Tidak ada jendela yang mendekati maksimum enam, jadi tidak ada qubit yang rusak, dan analisis memakai seluruh rantai 96 qubit. Kalau ada jendela dengan entropi mendekati enam, kamu akan membuang qubit yang dimiliki bersama oleh jendela-jendela itu dan mempelajari bagian rantai terpanjang tanpa qubit tersebut.
Purity yang sama menentukan prior CRM. Untuk setiap jendela, fitted_prior mengambil state ideal dan mencocokkan kekuatan depolarizing lokal sehingga purity-nya sama dengan purity yang terukur di setelan pelatihan, seperti di makalah.
Fungsi learn_and_validate di cell berikut mengerjakan sisa analisisnya. Fungsi ini mempelajari model dari setelan pelatihan, lalu memperkirakan dan pada setelan pengujian untuk qubit pertama dari rantai, dengan langkah 12. Ini adalah besaran-besaran di Gambar 1(c,d) makalah. State ideal dievaluasi pada data pengujian yang sama sebagai pembanding.
Cell ini menjalankan fungsi dengan lalu mengulanginya dengan dan untuk melihat seberapa besar pengaruh ukuran jendela pembelajaran. Dimensi ikatan paling besar , jadi mempelajari product state: tiap qubit sendiri-sendiri, tanpa korelasi antar qubit.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
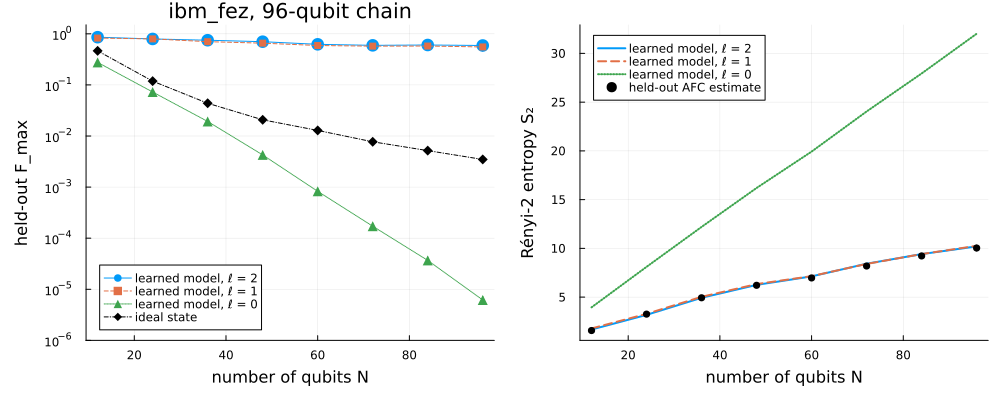
Hasilnya mereproduksi kedua klaim makalah di prosesor yang berbeda:
-
Model menjelaskan data jauh lebih baik daripada state ideal. Pada , held-out dari model adalah 0,59 ± 0,10, dibandingkan 0,0035 untuk state ideal. Makalah melaporkan sekitar 0,75 di
ibm_brisbane. -
Entropi model cocok dengan data pengujian di setiap . Pada , nilainya 10,2 dari model dan 10,0 ± 0,3 dari data pengujian, atau , dibandingkan 0,14 sampai 0,15 di
ibm_brisbaneyang lebih lama.
Perbandingan ukuran jendela menunjukkan di mana informasinya berada. Dengan , modelnya hampir sama bagusnya (), jadi untuk data ini, korelasi di luar beberapa qubit hanya menambah sedikit. Dengan , product state melewatkan entanglement antar qubit bertetangga: entropinya naik jadi 32 alih-alih 10, dan -nya turun bahkan lebih cepat daripada state ideal, jadi pada .
Ingat batasan-batasan berikut saat membaca angka-angka ini:
-
Pembagian pelatihan. Error bar hanya mencakup error statistik dari data pengujian. Pembagian acak lain dari setelan yang sama memberi antara 0,49 dan 0,59 pada untuk .
-
Sweep terakhir. Learner selalu mengembalikan model dari sweep terakhir, jadi data pengujian tidak pernah memengaruhi model.
-
Positivitas. Model tidak dibatasi untuk positif semidefinit; eigenvalue paling negatifnya dalam sebuah jendela pembelajaran sekitar . Jadi dan -nya menggambarkan sebuah operator, bukan properti tersertifikasi dari state fisik.
-
Faktorisasi. Setiap estimasi held-out bergantung pada asumsi AFC, yang tidak bisa disertifikasi oleh pengukuran itu sendiri.
Langkah selanjutnya
-
Ulangi eksperimen pada kedalaman dua dengan parameter makalah untuk kedalaman itu ( dan dimensi ikatan maksimum 8), lalu tentukan berapa banyak setelan pengukuran yang dibutuhkan learner.
-
Belajar dengan pembaruan dua-situs (
update=:two_siteditraining_marginalsdanlearn_mpo), yang memangkas dimensi ikatan setelah setiap langkah, dan lihat bagaimana perilakunya dengan lebih sedikit setelan pelatihan. -
Belajar tanpa prior CRM (
prior=nothing) dan bandingkan fidelity held-out-nya. -
Terapkan analisis yang sama pada pengukuran
ibm_brisbaneyang dipublikasikan para penulis. -
Baca suplemen makalah untuk penurunan rumus pembaruan dan estimator AFC.
-
Jelajahi protokol pengukuran acak lainnya di contoh
RandomMeas.jl.
Referensi
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174