Membatasi dimensi subruang
Dalam panduan ini, kita akan menunjukkan pengaruh dimensi subruang pada teknik pemulihan konfigurasi self-consistent.
A priori, kita tidak tahu berapa dimensi subruang yang tepat untuk mencapai tingkat akurasi target. Tapi, kita tahu bahwa menaikkan dimensi subruang meningkatkan akurasi metodenya. Jadi, kita bisa mempelajari akurasi prediksi sebagai fungsi dari dimensi subruang. Tentukan molekul dan propertinya.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Bangkitkan beberapa bitstring acak sebagai proksi sampel QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Panggil SQD dengan ukuran batch yang makin besar.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
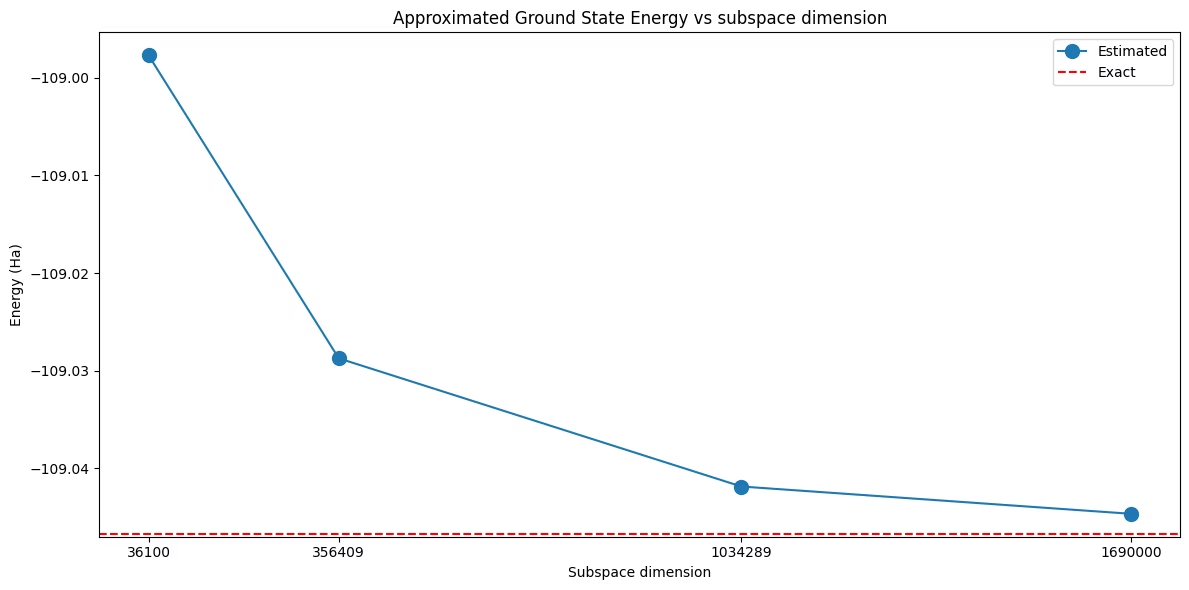
Plot ini menunjukkan bahwa menaikkan dimensi subruang menghasilkan hasil yang lebih akurat.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Menetapkan batas eksplisit dengan max_dim
Pada sweep di atas, dimensi subruang hanya dikendalikan secara tidak langsung. samples_per_batch menentukan berapa banyak bitstring yang diambil ke dalam tiap batch, tapi dimensi subruang yang dihasilkan ditentukan oleh berapa banyak string spin-alpha dan spin-beta berbeda yang ada di bitstring tersebut, dan pool konfigurasi yang tersedia untuk subsampling bertambah dari satu iterasi pemulihan konfigurasi ke iterasi berikutnya. Itulah sebabnya dimensi subruang di sumbu horizontal di atas berupa angka yang tidak beraturan dan tidak kita pilih sendiri.
Argumen max_dim pada diagonalize_fermionic_hamiltonian membatasi dimensi secara langsung. Argumen ini membatasi jumlah string CI yang dipertahankan di setiap sektor spin, dan karena subruang direntang oleh hasil kali Kartesius dari kedua sektor, dimensinya adalah hasil kali dari dua dimensi sektor tersebut:
-
max_dim=dmembatasi kedua sektor menjadidstring, sehingga dimensi subruang paling besard ** 2. -
max_dim=(d_a, d_b)membatasi sektor spin-alpha dan spin-beta secara terpisah, sehingga dimensi subruang paling besard_a * d_b. Saatsymmetrize_spin=True, kedua batas harus sama. -
max_dim=None, yang merupakan default, tidak memberi batas apa pun.
Ketika sebuah batch berisi lebih banyak string daripada yang diizinkan batas, string yang paling tidak penting dibuang: string yang diberikan lewat include_configurations dipertahankan lebih dulu, diikuti string yang dibawa dari iterasi sebelumnya (lihat carryover_threshold), dan slot yang tersisa diisi dengan string hasil sampling berdasarkan urutan menurun dari seberapa sering string itu disampel.
Karena max_dim membatasi ukuran diagonalisasi terbesar yang akan diminta dari eigenstate solver, ini cara praktis untuk menjaga solver tetap dalam anggaran runtime dan memori: pilih samples_per_batch yang besar, lalu biarkan max_dim yang menentukan seberapa besar subruang boleh tumbuh.
Di bawah ini, kita ulangi studinya, kali ini dengan samples_per_batch tetap dan max_dim dinaikkan.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
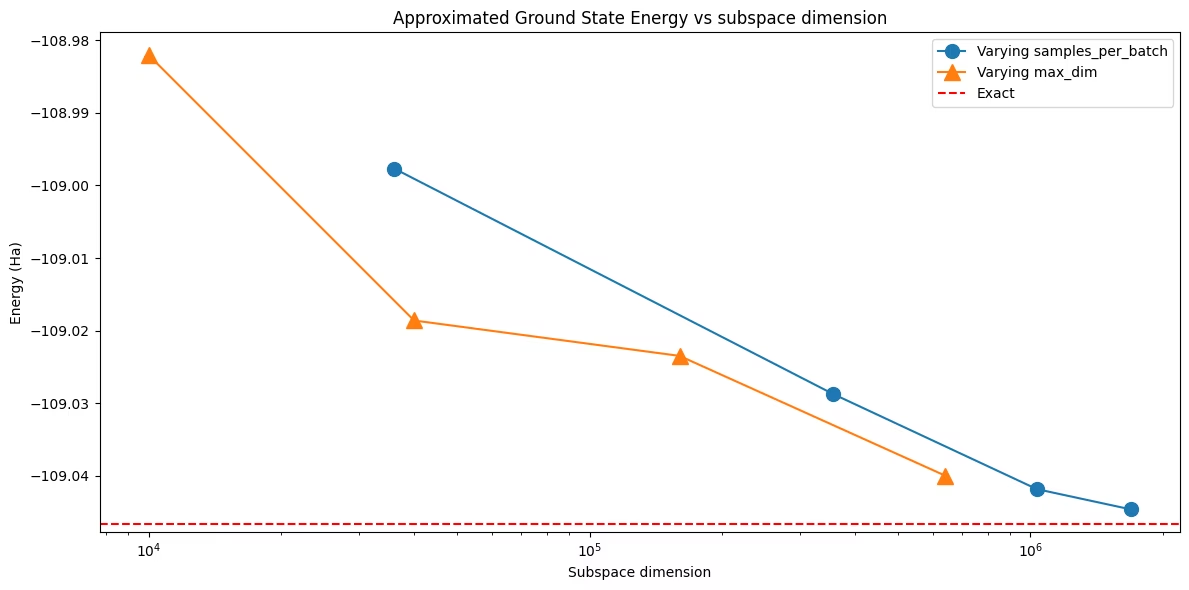
Dimensi subruang sekarang tepat max_dim ** 2 di setiap run: nilainya dipilih, bukan ditemukan. Memplot kedua sweep bersamaan menunjukkan bahwa akurasi ditentukan oleh dimensi subruang itu sendiri, argumen mana pun yang dipakai untuk mencapainya. Meski begitu, kedua kurva tidak harus persis berimpit. Run max_dim mengambil 600 bitstring per batch lalu mempertahankan string yang paling sering disampel, sehingga pada dimensi tertentu run tersebut bisa mempertahankan kumpulan konfigurasi yang lebih baik daripada run yang mencapai dimensi itu dengan mengambil lebih sedikit bitstring sejak awal.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()