Error mitigation
Pelajaran ini memberikan latar belakang tentang berbagai teknik error mitigation agar pengguna bisa membangun intuisi tentang bagaimana dan kapan teknik-teknik itu paling baik dipakai. Yang penting, penerapan modern teknik-teknik ini akan memanfaatkan alat yang lebih canggih, seperti Samplomatic, Shaded Lightcones, dan Executor. Alur kerja tersebut akan dibahas di pelajaran berikutnya.
Video ini memberikan gambaran umum tentang teknik error mitigation. Teks di bawah menambahkan detail dan menjelajahi metode-metode ini menggunakan Qiskit.
Gambaran umum teknik error mitigation
Error mitigation adalah proses apa pun yang berusaha mengurangi dampak error dalam komputasi kuantum setelah error itu terjadi. Ini berbeda dari suppression, yang berusaha mencegah error, dan dari error correction, yang mengodekan informasi ke banyak qubit fisik lalu memeriksa konsistensi informasi itu untuk menjaga informasi dalam satu qubit logis. Di sepanjang pelajaran ini, teknik error mitigation paling tepat dipahami sebagai metode untuk membangun estimator yang lebih baik bagi nilai ekspektasi ideal atau sampler yang lebih baik bagi distribusi probabilitas, bukan sebagai metode untuk mengoreksi keadaan kuantum saat eksekusi. Kita akan membahas metode error mitigation di bawah, yang semuanya tersedia di Qiskit dan addon-nya, dan merupakan alat yang menjanjikan dalam upaya mencapai quantum advantage.
Twirled readout error extinction (TREX) mengacak proses pengukuran dengan menerapkan operasi Pauli yang dipilih secara acak sebelum pengukuran, lalu secara klasik membatalkan efek yang diketahui dari operasi itu pada bitstring yang teramati. Di bawah asumsi derau pengukuran yang sesuai, ini mengubah kanal error readout menjadi bentuk yang lebih sederhana dan simetris sehingga lebih mudah dikalibrasi dan dimitigasi.
Matrix-free measurement mitigation (M3) adalah teknik measurement-error mitigation yang skalabel dan menghindari pembentukan matriks assignment atau inversnya secara eksplisit.
Zero noise extrapolation (ZNE) memperkirakan nilai yang akan dimiliki sebuah observable tanpa derau dengan cara menskalakan derau secara artifisial dengan faktor yang diketahui lalu mengekstrapolasi kembali ke kasus tanpa derau. Ini mensyaratkan derau berskala dengan cara yang dapat diprediksi. Prediktabilitas itu mungkin membutuhkan metode lain yang dibahas dalam pelajaran ini (pulse stretching, gate folding, dan probabilistic error amplification (PEA)).
Probabilistic error cancellation (PEC) termasuk teknik error mitigation yang paling andal, tetapi juga paling mahal secara komputasi. Teknik ini bekerja dengan mempelajari perilaku derau sistem dan berusaha membatalkan derau dengan membangun estimasi tak bias dari komputasi ideal secara statistik. PEC menghasilkan observable yang dikoreksi secara statistik, bukan hasil yang dikoreksi error.
Sekarang kita akan mendalami masing-masing metode ini.
M3
Error pengukuran adalah salah satu sumber derau yang paling persisten dan spesifik hardware pada perangkat kuantum jangka dekat. Bahkan ketika keadaan kuantum disiapkan dan berevolusi dengan benar, langkah readout akhir bisa salah melaporkan hasil basis komputasi yang sebenarnya. Error ini muncul dari pembedaan yang tidak sempurna antara keadaan fisik yang bersesuaian dengan dan , relaksasi selama pengukuran, dan ketidaksempurnaan elektronik pengukuran. Akibatnya, distribusi bitstring yang teramati sering kali merupakan versi terdistorsi dari distribusi sebenarnya (ideal), dengan probabilitas yang salah dialihkan antar hasil.
Measurement mitigation mengatasi masalah ini dengan memodelkan secara eksplisit bagaimana hasil pengukuran salah ditetapkan. Dalam formulasi standar, perilaku ini ditangkap oleh matriks assignment , yang elemen -nya menyatakan probabilitas mencatat hasil ketika keadaan basis sebenarnya adalah . Jika derau pengukuran bersifat klasik dan stasioner, vektor probabilitas teramati berhubungan dengan distribusi ideal melalui relasi linear sederhana,
Perhatikan bahwa matriks assignment adalah peta stokastik klasik, bukan kanal kuantum. Matriks ini bekerja pada hasil readout klasik, bukan pada keadaan kuantum yang disampel untuk mendapatkan readout tersebut.
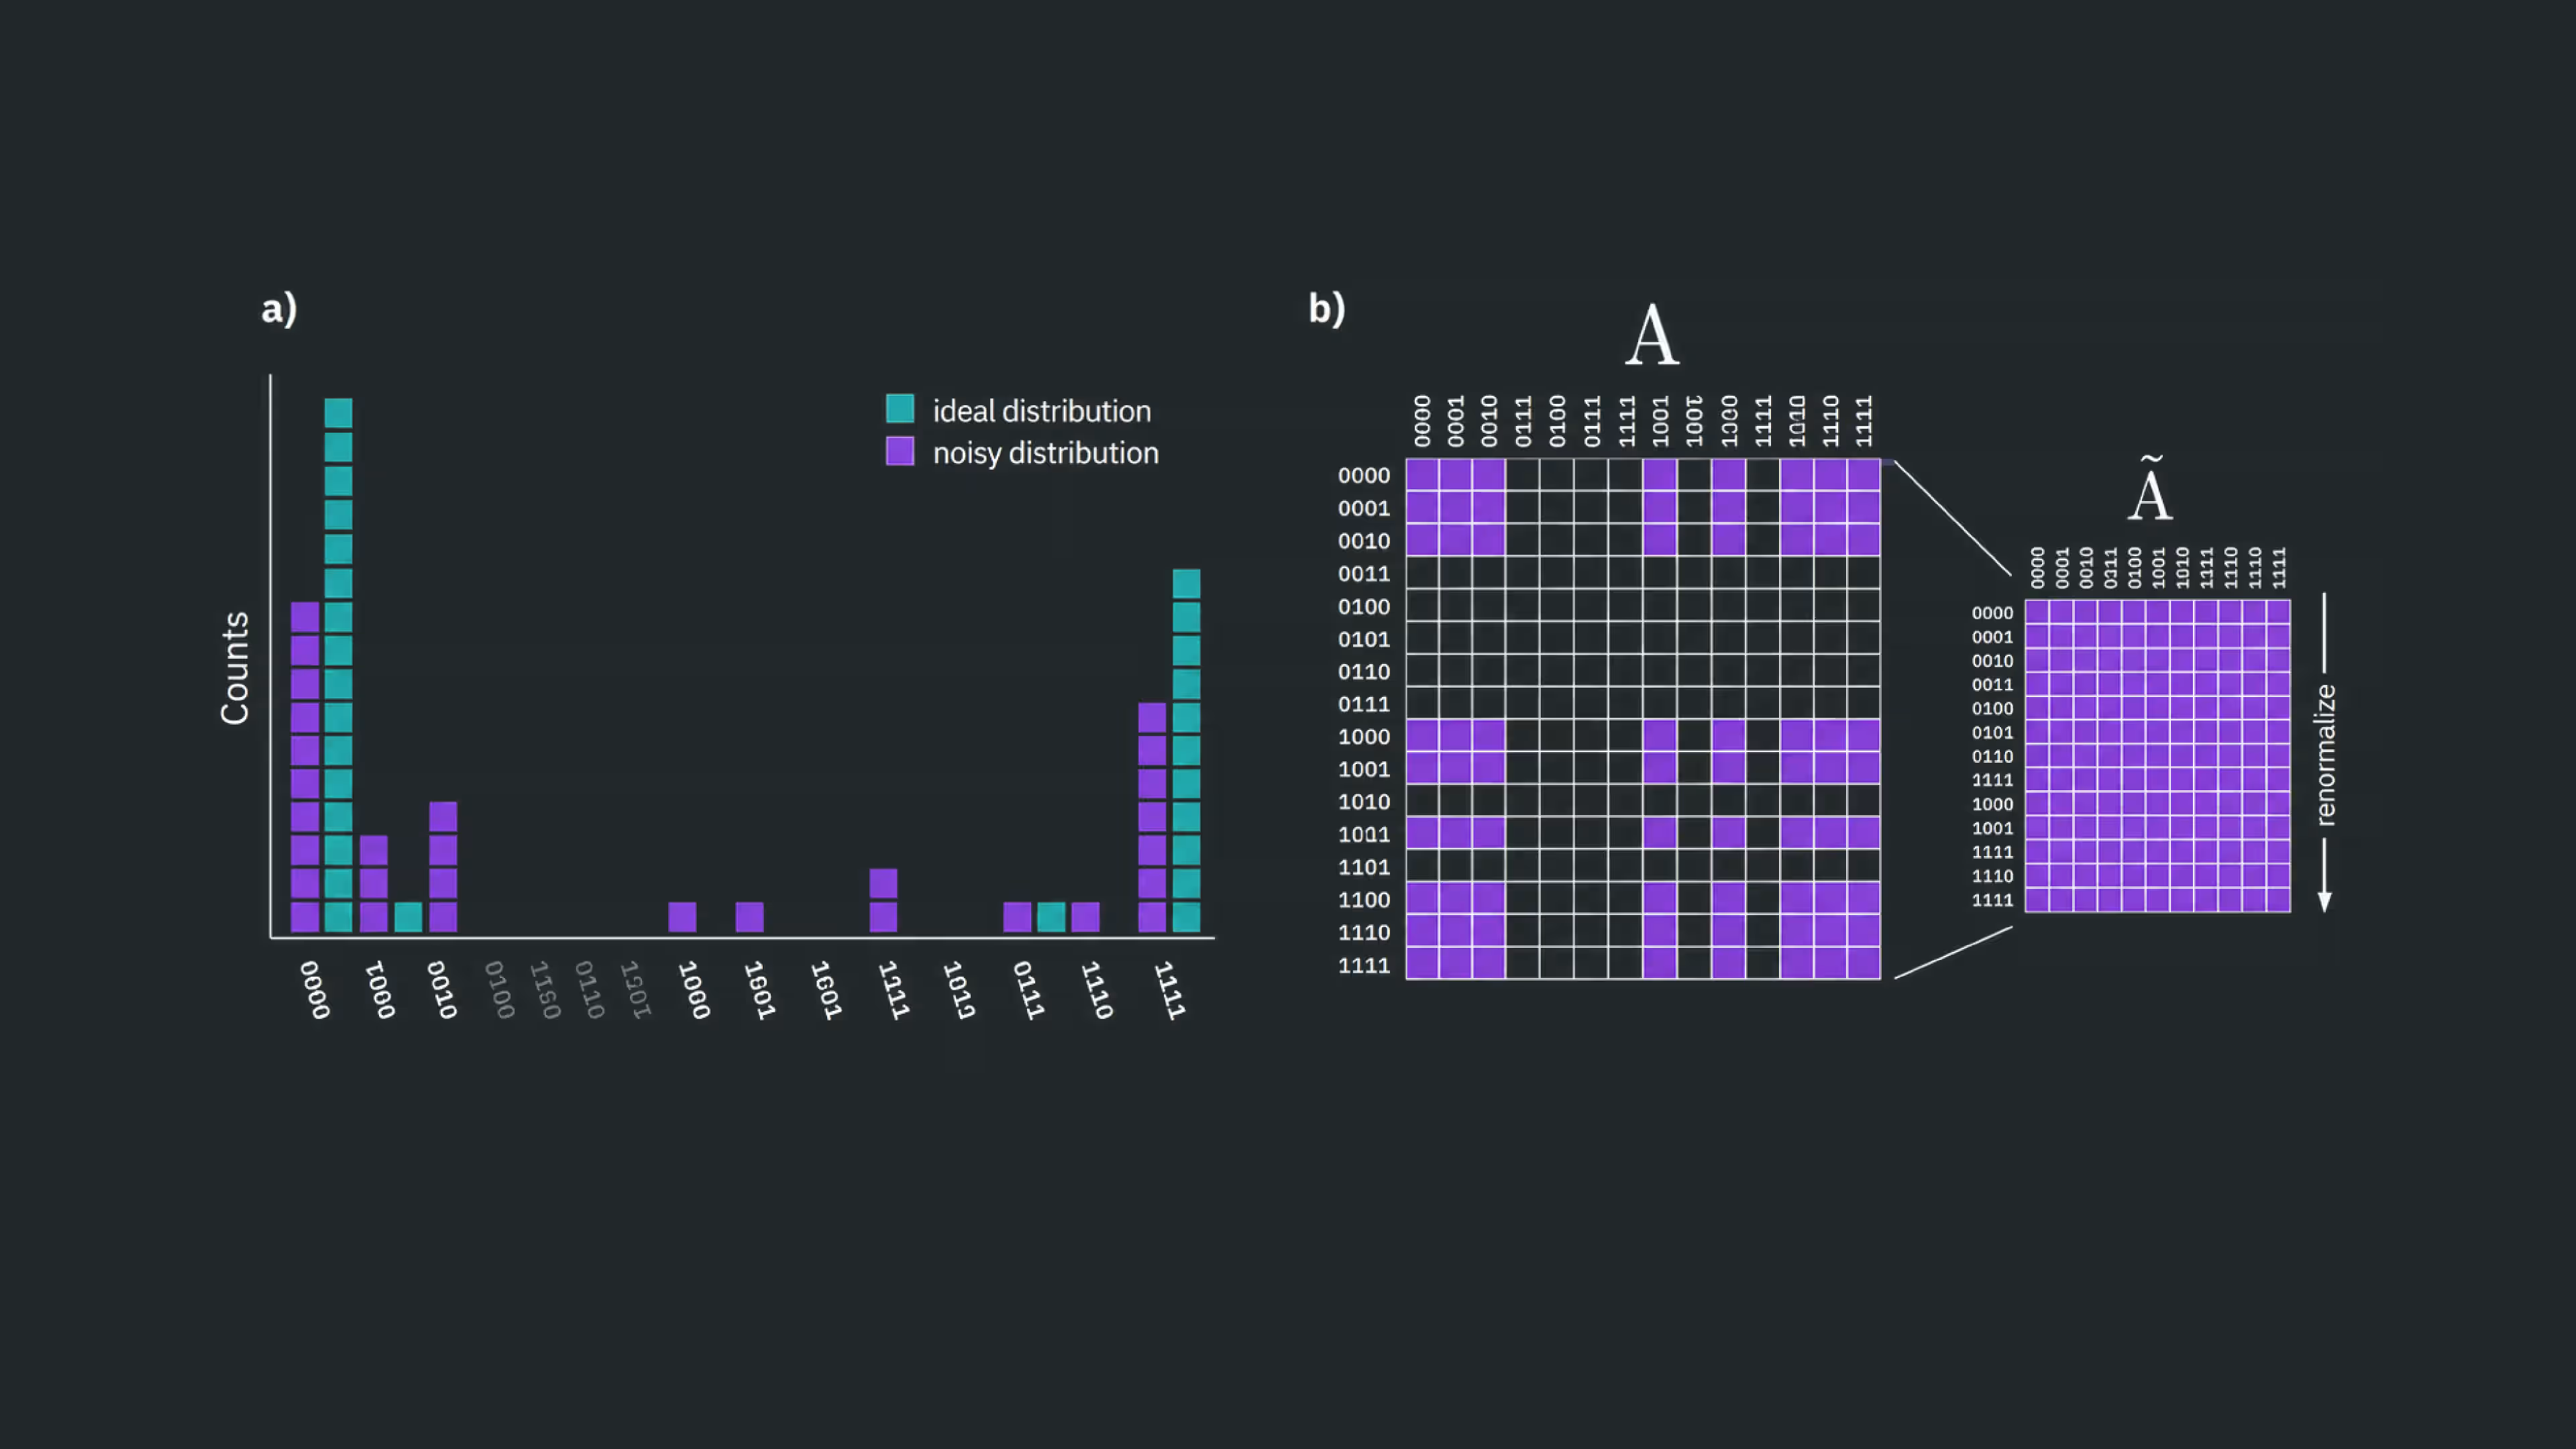
Matrix-free measurement mitigation (M3) memakai struktur ini untuk membangun estimasi termitigasi dari tanpa pernah membentuk atau membalik matriks penuh, yang tidak mungkin dilakukan untuk jumlah qubit yang besar. Sebaliknya, M3 memanfaatkan kenyataan bahwa banyak beban kerja kuantum jangka dekat menghasilkan distribusi yang sangat puncak atau berentropi rendah, sehingga mitigasi hanya berfokus pada subset hasil yang berkontribusi signifikan terhadap distribusi yang teramati.
Untuk membangun model assignment, eksperimen kalibrasi tambahan harus dijalankan di hardware kuantum. Biasanya ini melibatkan penyiapan keadaan basis komputasi yang diketahui dan pencatatan bagaimana keadaan itu dilaporkan oleh sistem pengukuran. Overhead kalibrasi berskala dengan jumlah qubit yang diukur, sedangkan biaya komputasi mitigasi bergantung pada struktur distribusi yang teramati. Biaya ini jauh lebih kecil daripada yang dibutuhkan untuk mengkarakterisasi matriks assignment penuh secara eksplisit. Meski overhead kalibrasi ini nyata, ia ringan dibandingkan teknik tingkat circuit seperti zero-noise extrapolation atau probabilistic error cancellation, sehingga M3 menjadi alat praktis dan banyak dipakai untuk memitigasi error readout dalam eksperimen kuantum jangka dekat.
Perhatikan bahwa kalibrasi hanya berguna sejauh proses pengukuran tetap cukup stabil antara run kalibrasi dan eksperimen target.
Pertama kita akan mengerjakan kasus sederhana secara manual untuk mengilustrasikan cara kerjanya, lalu memakai alat bawaan Qiskit untuk menunjukkan penggunaan M3 pada skala yang lebih realistis.
Contoh kecil M3
Kita mulai dengan membangun keadaan Bell sederhana.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Kita bisa memakai simulator dengan model derau karena contoh ini dibatasi pada circuit yang sangat kecil. Kita mengonfigurasi model derau secara eksplisit agar memiliki error readout dengan bentuk berikut:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Tingkat error readout ini jauh lebih tinggi daripada yang terlihat pada komputer kuantum IBM® sungguhan. Nilai tinggi ini dipilih demi tujuan pedagogis, supaya kita bisa melihat dengan jelas efek M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Kita bisa menjalankan circuit pada simulator berderau untuk mengamati efek error readout.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
Dalam contoh sederhana kita, kita mendefinisikan sendiri error readout untuk model derau. Namun saat memakai komputer kuantum sungguhan, error readout tidak diketahui sebelumnya. Error itu harus diestimasi secara eksperimental. Untuk itu, kita membuat circuit yang menyiapkan qubit dalam keadaan basis komputasi yang diketahui, atau , lalu mengukurnya. Tanpa error readout, kita akan mengukur persis keadaan yang disiapkan. Dengan mengumpulkan statistik dari pengukuran ini, kita bisa membangun matriks assignment yang menggambarkan error readout. Dalam contoh sederhana ini, hasilnya seharusnya mirip dengan yang kita definisikan.
Untuk sistem yang lebih realistis, statistik perlu dikumpulkan untuk setiap qubit fisik. Ini kadang tidak sepele, karena transpilasi memetakan circuit abstrak ke hardware dan nomor qubit berubah. Kita akan membahasnya lagi di contoh berikutnya. Dalam contoh simulator ini, kita menetapkan model error readout yang sama untuk setiap qubit, jadi satu karakterisasi sudah cukup.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Perhatikan bahwa ini sangat dekat dengan matriks error readout yang dipakai untuk membangun simulator.
Sekali lagi, pada komputer kuantum sungguhan kita akan punya statistik seperti ini untuk beberapa qubit fisik. Untuk simulator ini, kita asumsikan kedua qubit memiliki error readout yang identik dan independen, sehingga kita bisa membangun matriks assignment dua-qubit A_2q sebagai hasil kali tensor dari matriks satu-qubit yang bersesuaian. Perhatikan juga bahwa tujuan M3 bukan membangun seluruh matriks assignment. Sebaliknya, M3 berfokus pada subset hasil yang berkontribusi signifikan terhadap distribusi yang teramati. Kita akan membangun seluruh matriks untuk contoh yang sangat kecil ini agar melihat cara kerjanya. Implementasi M3 di qiskit-ibm-runtime lebih canggih daripada contoh sederhana ini karena harus menangani banyak qubit dengan karakteristik readout yang berbeda-beda sambil tetap menghindari pembentukan matriks assignment penuh.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Untuk contoh ini kita asumsikan error readout pada qubit yang berbeda saling independen, sehingga matriks assignment dua-qubit bisa dibangun sebagai hasil kali tensor dari matriks satu-qubit yang bersesuaian.
Kita mendapatkan hasil mentah dan hasil termitigasi untuk dibandingkan.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
Sampai di sini, kita sudah mengkarakterisasi secara eksperimental bagaimana proses pengukuran mendistorsi probabilitas hasil yang ideal. Tujuan kita sekarang adalah membatalkan distorsi ini dan menerapkan koreksi yang dihasilkan pada probabilitas mentah.
Karena kita melakukan inversi linear, bukan koreksi fisik, "probabilitas" yang dihasilkan tidak selalu positif. Quasi-probabilitas negatif yang sangat kecil memang wajar dan mencerminkan fakta bahwa measurement mitigation menghasilkan sebuah estimator, bukan distribusi probabilitas fisik.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Kita ubah ini menjadi counts untuk diplot.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Terakhir kita lihat distribusi mentah, termitigasi, dan ideal. "Counts" termitigasi di bawah hanyalah alat bantu visualisasi yang diperoleh dengan menskalakan ulang quasi-probabilitas termitigasi.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
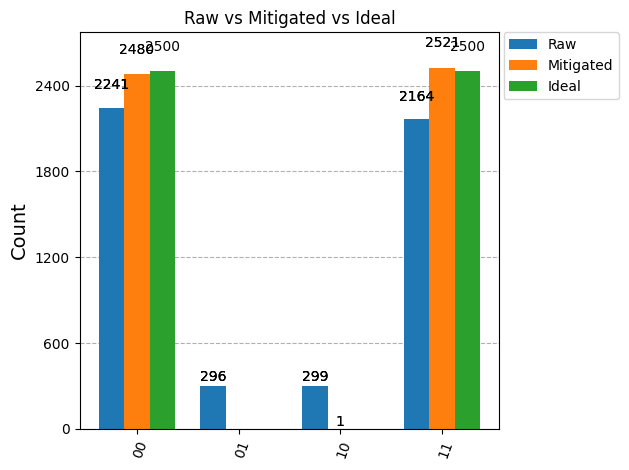
Jelas bahwa hasil yang dimitigasi dengan M3 jauh lebih dekat ke distribusi ideal, dan kita bisa melihat alasannya.
Menerapkan M3 pada alur kerja yang lebih realistis jauh lebih kompleks. Pertimbangkan:
- Komputer kuantum sungguhan memiliki banyak qubit fisik, masing-masing dengan karakteristik error readout sendiri. Error ini harus dimodelkan dan digabungkan dengan tepat.
- Matriks assignment penuh tumbuh secara eksponensial terhadap jumlah qubit dan dengan cepat menjadi tidak praktis untuk dibangun secara eksplisit. Inilah sebabnya M3 berfokus pada subset hasil yang berkontribusi signifikan terhadap distribusi yang teramati, bukan membangun seluruh matriks assignment.
- Untuk masalah nyata yang menarik, distribusi ideal mungkin tidak diketahui.
Karena semua alasan ini, alur kerja mitigasi lengkap dikemas dalam addon Qiskit mthree.
Contoh M3 yang lebih besar
Sekarang kita terapkan M3 pada circuit yang lebih besar, yang untuknya menentukan subruang relevan dari secara manual akan merepotkan, tetapi masih cukup sederhana sehingga kita tahu distribusi idealnya: keadaan GHZ. Kita mulai dengan mengimpor paket mthree dan mendefinisikan circuit kuantum GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
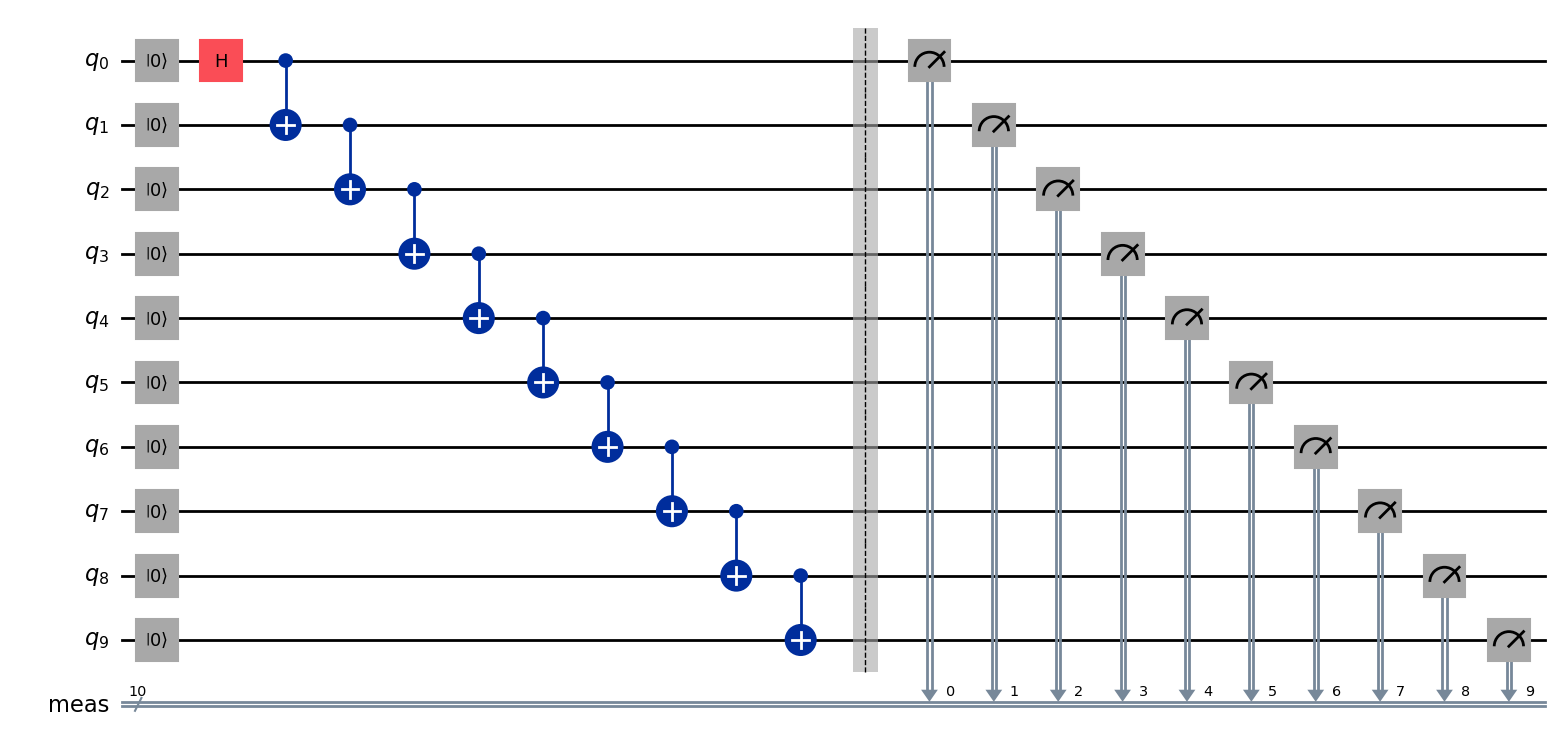
Untuk menjalankannya di komputer kuantum sungguhan, kita impor qiskit_ibm_runtime dan paket lain yang diperlukan. Kita memakai SamplerV2 untuk mendapatkan distribusi keluaran.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Sekarang kita transpile circuit ke backend kita. Kita menetapkan level optimisasi 0 di sini agar fokus pada efek M3, tanpa menambahkan alat tambahan. Artinya fidelity akhir tidak akan mewakili apa yang bisa dicapai di hardware IBM Quantum® dengan seluruh rangkaian alat yang tersedia, tetapi ini memungkinkan kita fokus khusus pada kegunaan M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Sekarang kita konfigurasi Sampler, lagi-lagi menonaktifkan teknik error-suppression tambahan seperti dynamical decoupling dan twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Terakhir, kita jalankan job kita.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Kita bisa mengekstrak counts mentah dari circuit di atas.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Sekarang kita jalankan mthree pada backend kita untuk mengkarakterisasi model assignment yang dipakai untuk measurement mitigation. Kita menskalakan ulang distribusi mentah memakai informasi itu. Perhatikan bahwa ini kadang menghasilkan probabilitas negatif yang sangat kecil (karena itu istilah quasi-probabilitas).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Koreksi mthree menghasilkan quasi-probabilitas, bukan counts. Kita bisa menskalakan ke counts secara manual. Fungsi pembantu di bawah mengubahnya menjadi counts dan membulatkan ke nilai bilangan bulat. Selain itu, untuk circuit besar akan ada banyak string keliru dengan counts sangat sedikit yang membuat histogram berantakan. Fungsi pembantu kedua di bawah memangkas string mana pun yang counts-nya di bawah ambang yang kita pilih, agar kita mendapat gambaran jelas tentang suku dominan dalam distribusi.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Kita juga dengan mudah bisa menghasilkan distribusi ideal teoretis, yang memiliki probabilitas sama untuk keadaan semua-nol dan semua-satu, dan probabilitas nol untuk semua hasil lain, sebagai pembanding.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Terakhir, kita bisa memvisualisasikan hasil kita.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
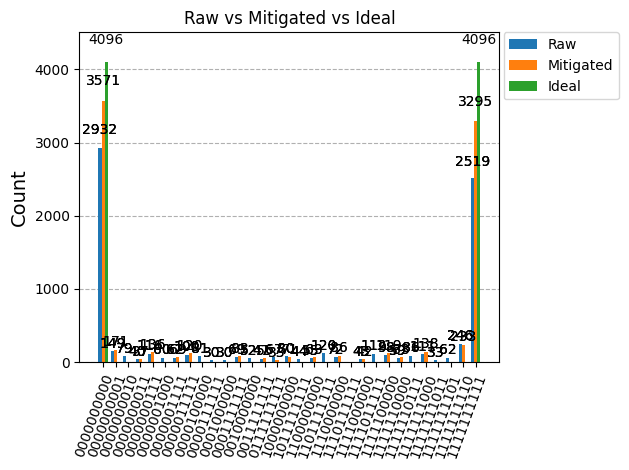
Hasil termitigasi lebih dekat ke distribusi ideal daripada hasil tanpa mitigasi. Kita bisa mengkuantifikasi ini dengan lebih baik memakai counts untuk bitstring ideal.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Alat sederhana ini meningkatkan fidelity kita sebesar 26% relatif terhadap fidelity tanpa mitigasi, dengan overhead yang cukup rendah. Jelas M3 bisa sangat berharga. Namun circuit GHZ dipilih sebagai kasus penggunaan yang baik karena distribusinya sangat puncak pada dua keadaan keluaran. Beberapa masalah menghasilkan counts yang lebih merata (keadaan berentropi tinggi). Untuk circuit yang sangat dalam dengan banyak qubit, error gate dan derau yang tidak terkait error pengukuran sering kali menghasilkan keadaan berentropi tinggi. Dalam kasus seperti itu, M3 beroperasi pada ruang keadaan yang cukup besar. Ada tiga pendekatan yang mungkin untuk ini:
(1) Terima bahwa ini adalah keterbatasan M3.
(2) Perhatikan bahwa batas atas ruang matriks yang dibentuk M3 adalah num_shots num_shots, bukan , dengan yang pertama jauh lebih kecil untuk jumlah qubit yang besar.
(3) Hanya dengan sangat hati-hati, hapus bitstring berprobabilitas sangat rendah dari counts mentah yang diberikan ke M3. Ini bisa menimbulkan bias, dan pembatasan support keadaan Anda dapat mengganggu konvergensi pada pendekatan seperti metode Krylov. Ini hanya boleh dilakukan jika Anda tahu persis alasannya dan dapat mengantisipasi semua efeknya. Itulah sebabnya pemangkasan seperti ini bukan fitur bawaan M3.
Untuk info lebih lanjut tentang addon Qiskit mthree, lihat contoh, petunjuk instalasi, latar belakang, dan referensi API di dokumentasinya.
Twirled readout error extinction (TREX)
Twirled Readout Error Extinction (TREX) adalah teknik measurement-error mitigation yang dipakai pada komputer kuantum modern. Tujuannya menghilangkan bias yang ditimbulkan error readout klasik tanpa memerlukan karakterisasi penuh atau inversi matriks assignment pengukuran.
TREX bukan error correction dan tidak meningkatkan fidelity keadaan. Sebaliknya, TREX memastikan estimator nilai ekspektasi tidak bias terhadap derau readout, hingga error statistik, dengan merata-ratakan basis pengukuran acak dan menskalakan ulang. Pada hardware IBM Quantum, TREX adalah metode mitigasi default untuk estimasi nilai ekspektasi dan bersesuaian dengan resilience_level = 1 pada primitif IBM Quantum Estimator.
Sifat error readout pada hardware superkonduktor
Pada qubit superkonduktor IBM, error readout didominasi oleh:
-
Probabilitas bit-flip asimetris (misalnya, lebih sering terjadi daripada sebaliknya)
-
Relaksasi yang bergantung pada keadaan selama pengukuran itu sendiri
-
Crosstalk ringan tetapi tidak dapat diabaikan antara resonator readout yang bertetangga
Yang penting, error ini sering kali dapat dimodelkan sebagai proses stokastik klasik yang bekerja pada hasil pengukuran. TREX memanfaatkan gagasan standar dari noise tailoring: pengacakan (twirling) prosedur pengukuran. TREX biasanya berjalan dalam dua tahap:
-
Twirling dan "untwirling" klasik
-
Penskalaan ulang nilai ekspektasi memakai circuit kalibrasi
Misalkan nilai ekspektasi observable berhubungan dengan estimasi berderau, seperti berikut:
di mana adalah faktor tetap yang menskalakan estimasi dan adalah bias dari sumber-sumber yang dijelaskan di atas. Kita memakai di sini sebagai pengingat bahwa kita hanya menangani error readout di sini; masih ada error gate yang perlu dipertimbangkan.
Tepat sebelum pengukuran, setiap qubit dikonjugasi secara acak dengan operator Pauli (seperti I atau X). Hasil pengukuran kemudian di-untwirl secara klasik.
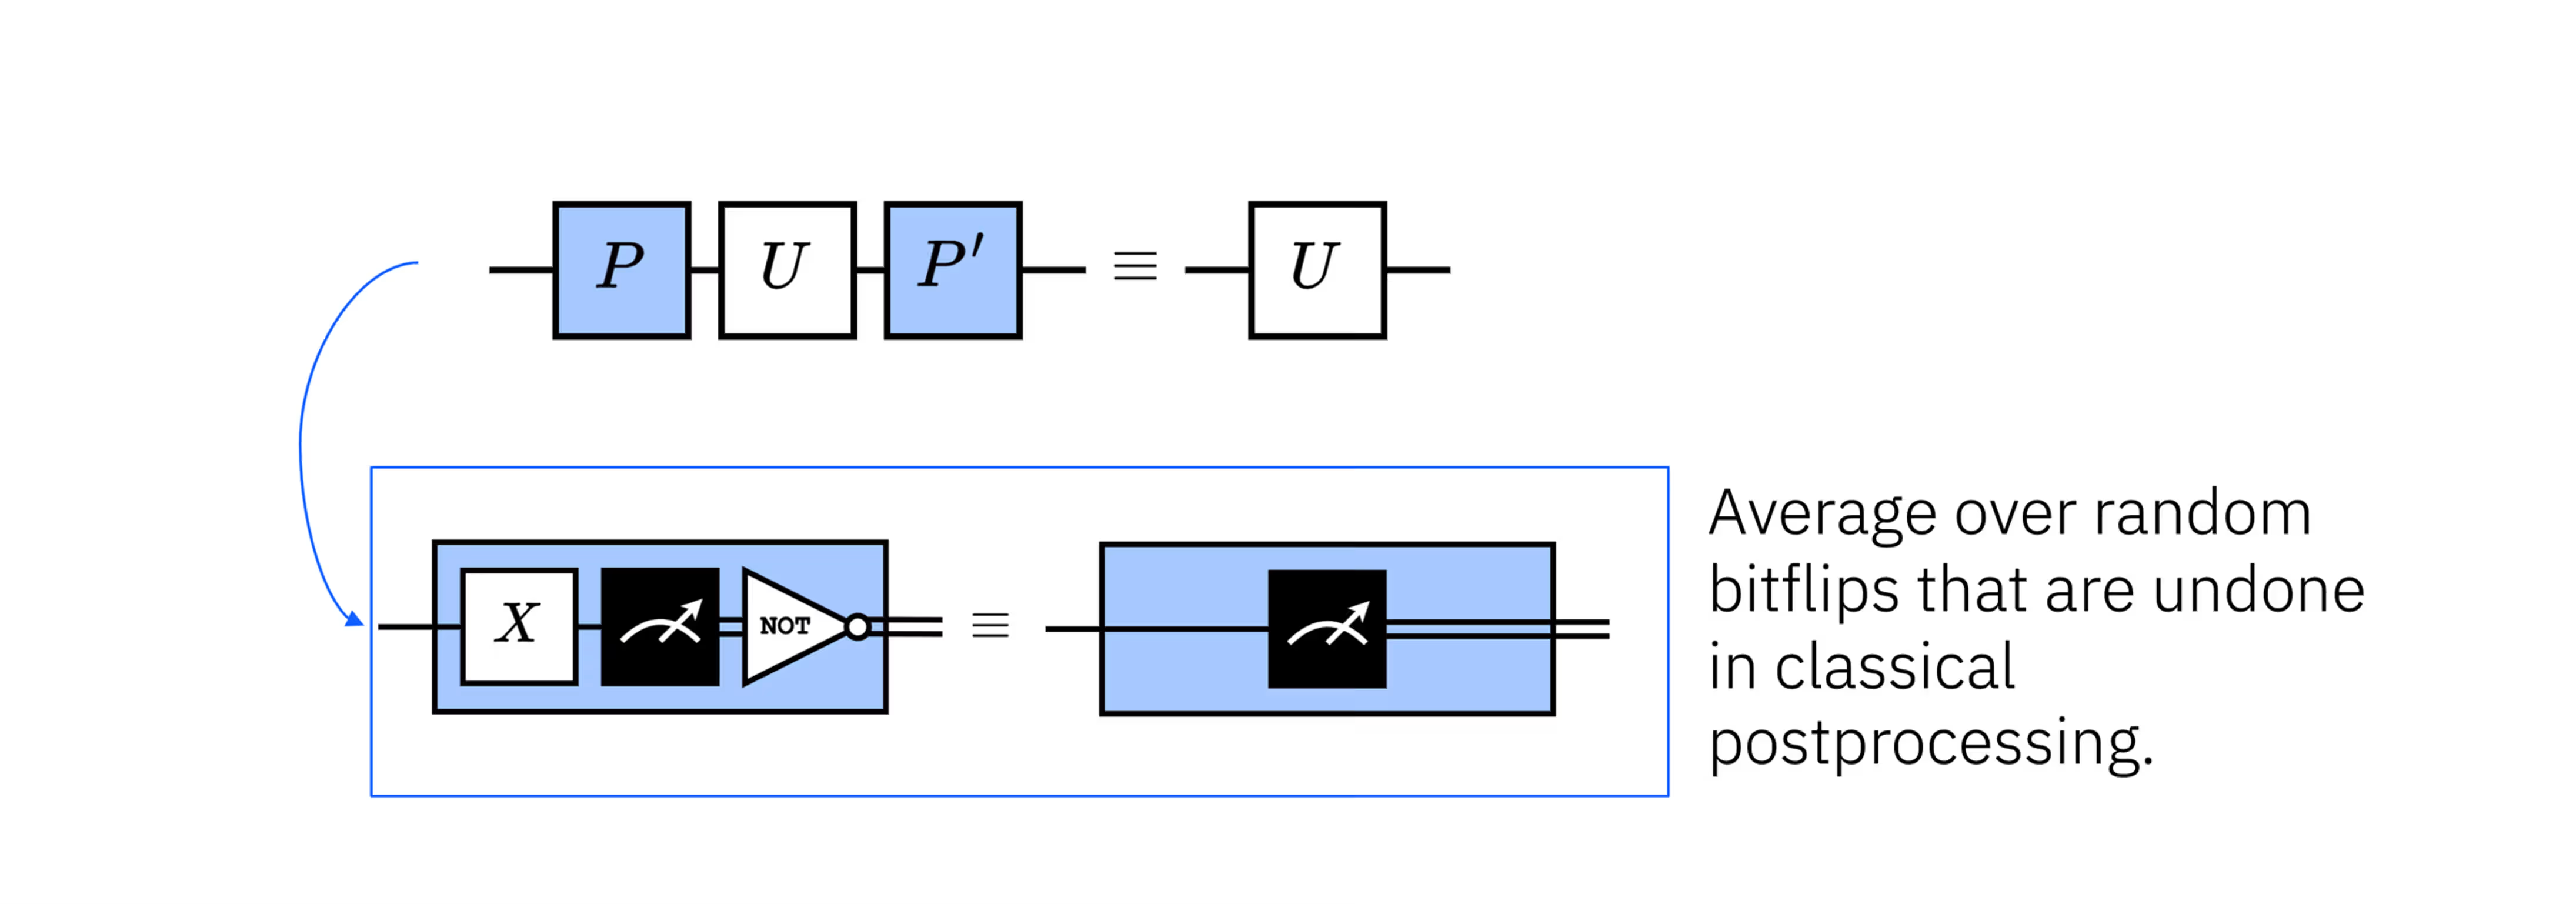
Merata-ratakan pengacakan ini membuat kanal readout menjadi simetris. Akibatnya, asimetri sistematis dalam proses readout diubah menjadi kanal error yang lebih simetris yang efek sisanya dapat ditangani melalui kalibrasi dan penskalaan ulang. Singkatnya, jika misalnya ada bias ke keadaan , kita akan kehilangan sebagian pengukuran . Dengan melakukan twirling di sekitar pengukuran, kita menukar secara acak hasil logis mana yang dikaitkan dengan proses readout fisik, lalu membatalkan pertukaran itu secara klasik setelahnya. Merata-ratakan banyak pengukuran acak seperti itu menghilangkan preferensi sistematis pada satu hasil yang dilaporkan dibanding yang lain. Ini menghilangkan bias pengukuran dominan di bawah asumsi model TREX, sehingga kita punya:
Namun, nilai ekspektasi mungkin masih perlu diskalakan ulang. Tahap kedua memakai circuit kalibrasi (circuit dengan hasil yang diketahui) untuk mengestimasi faktor skala . Ini kemudian dapat dipakai untuk mendapatkan estimasi yang jauh lebih baik.
Nilai ekspektasi observable Pauli menjadi estimator tak bias dari nilai idealnya. Tidak ada model derau eksplisit yang dipelajari atau dibalik, itulah sebabnya TREX stabil secara numerik dan murah. Sekali lagi, error gate belum ditangani di sini.
Dalam estimasi nilai ekspektasi dari observable , bisa ada varians akibat sampling terbatas, bisa ada banyak jenis error inkoheren dan koheren, dan bisa juga ada bias, , akibat error readout. Bias ini muncul dari sumber seperti transisi asimetris yang telah kita bahas. Dalam praktik, bias ini biasanya dimodelkan dengan baik sebagai kanal stokastik klasik yang bekerja setelah evolusi kuantum. TREX mengubah kanal pengukuran efektif sehingga estimator tidak bias terhadap error readout. Ini relatif mudah dilihat dengan contoh twirling gate paling sederhana: X. Jika ada asimetri pada dibandingkan , tetapi kita secara acak menukar keadaan mana yang dibaca (dan membaliknya kembali nanti secara klasik), maka jelas ini menghilangkan asimetri sistematis (meski sampling terbatas tetap berarti mungkin ada sedikit asimetri stokastik dalam pengukuran). Dalam praktik, gate twirling untuk TREX tidak terbatas pada I dan X, tetapi ini cukup untuk penjelasan.
TREX memungkinkan kita memperoleh estimasi nilai ekspektasi yang bebas dari bias akibat error readout. Masih bisa ada bias dari sumber lain (seperti over-rotation koheren); TREX hanya menargetkan readout. Karena TREX mengganti bias sistematis dengan simetrisasi acak, ia umumnya mengubah bias menjadi varians stokastik tambahan, sehingga meningkatkan varians estimator pada biaya sampling yang tetap.
Periksa pemahaman Anda
Misalkan kita memakai estimator pada circuit yang telah menyiapkan keadaan untuk mengestimasi . Misalkan juga error pengukuran menyebabkan hasil yang bersesuaian dengan dilaporkan sebagai sebanyak 10% dari waktu, sedangkan hasil yang bersesuaian dengan dilaporkan sebagai hanya 1% dari waktu. Asimetri antara error pelaporan ini menimbulkan bias pengukuran.
(a) Tanpa error pengukuran semacam itu, berapa nilai ekspektasi ideal dari observable ?
(b) Dengan error pengukuran atau readout asimetris, berapa nilai ekspektasi observable ?
(c) Pertimbangkan himpunan terbatas gate Pauli twirling: I dan X. Anggap I dan X diterapkan secara acak dengan probabilitas 50% pada banyak shot. Laju error pengukuran yang sama tetap berlaku. Lalu gate Pauli (I atau X) dibatalkan secara klasik. Buat tabel semua hasil yang mungkin beserta probabilitasnya akibat superposisi awal, error pengukuran asimetris, dan gate Pauli yang ditetapkan secara acak.
(d) Gunakan tabel untuk menentukan nilai ekspektasi dengan strategi twirling.
(e) Bandingkan nilai ekspektasi: ideal, tanpa twirling, dan dengan twirling.
(f) Apa yang dihilangkan dari pembahasan ini yang ada dalam penerapan TREX penuh?
Jawaban
(a) Anda cukup memakai intuisi dan simetri untuk menyatakan . Untuk menunjukkannya secara eksplisit:
(b) Keadaan bisa kolaps ke atau saat diukur, masing-masing dengan peluang 50%. Tetapi dari 50% yang kolaps ke keadaan , 1% di antaranya (atau 0,5% dari semua kasus) akan salah dilaporkan sebagai . Dari 50% yang kolaps ke , 10% (atau 5% dari semua kasus) akan salah dilaporkan sebagai . Ini menyisakan:
- 54,5%
- 45,5% Dengan mengabaikan semua jenis error lain yang mungkin, kita akan memperoleh estimasi
(c)
| Pauli | Hasil pengukuran ideal | Hasil setelah Pauli | Error readout | Batalkan Pauli | Hasil akhir yang dilaporkan | Probabilitas |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Tidak ada | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Tidak ada | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Tidak ada | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Tidak ada | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Dari bagian sebelumnya, kita tahu nilai ekspektasi Z pada masing-masing keadaan akhir. Kita tinggal mengambil rata-rata berbobot:
(e) Dalam kasus yang sangat sederhana ini, penerapan twirling kita memulihkan persis nilai ekspektasi ideal. Itu tidak lazim. Yang lazim adalah twirling membatalkan bias seperti yang ditimbulkan oleh transisi asimetris, dan menghasilkan nilai ekspektasi yang lebih dekat ke nilai ideal.
(f) Ini adalah penerapan model sederhana. Bisa ada beberapa hal yang hilang. Terutama, kita belum menjalankan circuit kalibrasi di sini untuk mengestimasi faktor penskalaan ulang . Ini biasanya diperlukan.
Detail implementasi
TREX diterapkan secara otomatis saat memakai primitif EstimatorV2 dengan resilience_level = 1 (default). Perhatikan bahwa TREX tidak diterapkan otomatis pada primitif Sampler, karena Sampler mengembalikan distribusi probabilitas penuh, bukan nilai ekspektasi.
Saat TREX diaktifkan, runtime menghasilkan varian circuit yang di-twirl pada pengukuran dengan menyisipkan Pauli satu-qubit acak tepat sebelum pengukuran. Pascapemrosesan klasik membalik Pauli ini. Varian circuit ini acak antar shot yang berbeda dan juga antar qubit yang berbeda dalam satu shot. Semua varian circuit kemudian digabungkan menjadi satu estimator.
TREX sangat skalabel. Ia memerlukan circuit kalibrasi tambahan, sehingga overhead sampling biasanya berupa faktor konstan kecil (sering 2-4x). Tetapi mitigasinya spesifik per observable, tidak mempertahankan distribusi.
TREX dirancang untuk terintegrasi dengan mulus bersama banyak metode error suppression dan error mitigation, termasuk berikut ini:
-
Dynamical decoupling (DD) - bekerja selama waktu idle, ortogonal terhadap readout mitigation.
-
Gate atau Pauli twirling - sering saling melengkapi; TREX sudah mengandalkan twirling tetapi hanya menargetkan derau readout.
-
Zero-Noise Extrapolation (ZNE) - ZNE menargetkan derau gate, sedangkan TREX menangani bias pengukuran. Kombinasi ini dipakai pada resilience level 2.
-
Probabilistic error amplification dan probabilistic error cancellation dalam alur kerja Estimator.
Namun, beberapa metode tidak bisa (atau sebaiknya tidak) digabungkan dengan TREX:
-
Koreksi probabilitas tingkat Sampler: TREX tidak mengembalikan probabilitas bitstring yang dikoreksi.
-
Mitigasi post-hoc pada data TREX yang sudah dimitigasi: koreksi ganda dapat memunculkan kembali bias.
Menggabungkan TREX dengan mitigasi readout berbasis assignment-matrix seperti M3 itu rumit. M3 mengasumsikan channel pengukuran yang tetap. TREX sengaja mengacak pengukuran, sehingga asumsi yang dipakai M3 jadi tidak berlaku. Jadi, kedua teknik ini tidak bisa begitu saja digabung. Namun, kalau kamu menerapkan measurement twirling saat kalibrasi yang dipakai di M3, kamu mungkin bisa memanfaatkan pendekatan ala assignment matrix sekaligus pendekatan mitigasi twirling (meski pendekatan twirling ini tidak persis sama dengan TREX). Ini tema yang sering muncul saat menggabungkan teknik mitigasi dan suppression: menambahkan teknik secara asal itu gagal; menambahkannya dengan hati-hati supaya saling "sadar" satu sama lain bisa berhasil dan sangat bermanfaat.
TREX hanya menjamin nilai ekspektasi yang bebas dari bias akibat error readout; TREX tidak mengurangi varians, dan tidak melindungi dari jenis bias lain. TREX jelas tidak mengoreksi semua error. Meski begitu, TREX sering memberi peningkatan yang besar, dan bisa dicapai dengan overhead yang jauh lebih rendah dibanding beberapa metode lain yang perlu mempelajari model noise secara penuh. TREX sering menjadi mitigasi readout yang paling murah dan paling andal, sehingga cocok sekali jadi default dalam eksperimen.
TREX dengan Qiskit
Di sini kita membuat circuit dua qubit yang sederhana, lalu memakai Estimator untuk memperkirakan nilai ekspektasi dari observable yang sangat sederhana, ZX. Nilai ekspektasi idealnya adalah 1. Kita akan membandingkan nilai ekspektasi dengan dan tanpa TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Buat quantum circuit yang sederhana.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpile circuit menggunakan pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Terapkan layout yang sama dari transpilasi ke observable.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Jalankan eksperimen di komputer kuantum sungguhan. Pertama kita lanjut dengan reslience_level = 1; ini adalah default, tapi kita tuliskan secara eksplisit untuk membedakan kedua kasus.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Sekarang kita atur resilience_level ke 0 untuk menjalankan tanpa TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Nilai ekspektasi dengan TREX jauh lebih dekat ke nilai ideal (1), seperti yang diharapkan. Tentu saja, ini hanya satu nilai ekspektasi pada satu qubit. Sekarang kita siapkan circuit dengan gate non-Clifford dan banyak qubit untuk menguji apakah peningkatan dari TREX tetap kuat dalam kondisi yang berbeda.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Di sini, sudut rotasi tidak istimewa. Kita hanya memilih sembarang superposisi tak seimbang dari dan untuk menyelidiki efek transisi error yang asimetris dan bagaimana TREX menanganinya. Dengan state ini, nilai ekspektasi ideal dari Z pada setiap qubit, tanpa error apa pun (readout atau lainnya), adalah:
Jadi kita berharap mendapat nilai ekspektasi yang mendekati -0.924 pada semua qubit. Kita akan lihat apakah TREX memperbaiki tiap nilai ekspektasi secara individual dan juga apakah rata-rata di semua qubit membaik.
Periksa pemahamanmu
Verifikasi nilai ekspektasi di atas lewat perhitungan langsung.
Jawaban
Kita melakukan transpile menggunakan pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Sekarang kita buat satu observable per qubit supaya bisa memperkirakan kedua puluh nilai ekspektasi dalam satu workflow. Artinya, untuk qubit ke-, kita mau observable dengan semua identitas , kecuali di posisi ke-, yang kita isi dengan . Ingat untuk menerapkan layout hasil transpile ke observable kamu juga.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Sekarang kita bisa menjalankannya. Cell kode di bawah memakai session mode; kalau kamu tidak punya akses ke session, kamu bisa menggantinya dengan batch mode untuk menjalankan workflow yang sama, tapi mungkin ada waktu antrean di antara circuit.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Di sini kita bandingkan mean absolute error dengan dan tanpa TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
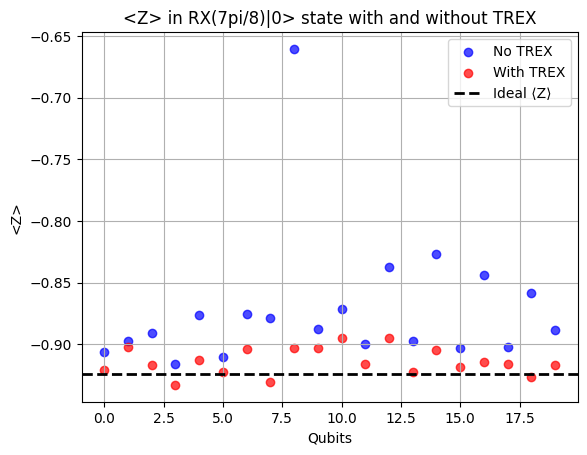
TREX jelas tampak membantu. Nilai ekspektasi pada setiap qubit membaik, kecuali qubit 16. Outlier seperti itu wajar terjadi. Kita bisa mengukur dampak keseluruhan TREX pada circuit dengan mengambil nilai rata-ratanya.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
Rata-rata, TREX menggeser hasil kita sekitar 2.9% lebih dekat ke hasil ideal, dan menyisakan hasil yang rata-rata hanya berbeda 0.4% dari nilai ideal teoretis. Bagus sekali, dan peningkatan dengan overhead rendah inilah alasan TREX menjadi mitigasi error default pada Estimator. Tapi kita harus sekali lagi menekankan bahwa TREX menghilangkan bias pada error readout, bukan mengoreksi semua error kita. Kita memilih state awal yang besar kemungkinannya terpengaruh asimetri readout. Efeknya akan berbeda kalau tiap qubit disiapkan di state yang berbeda. Sebagai argumen sederhana kenapa ini pasti begitu, bayangkan apa yang terjadi kalau kita membiarkan tiap qubit di ground state . Tidak akan ada kesempatan untuk mengamati (atau mengoreksi) asimetri error readout antara state dan .
Zero-noise extrapolation (ZNE)
Zero-noise extrapolation (ZNE) adalah salah satu teknik error-mitigation yang paling banyak dipakai. Strategi umumnya juga mudah dipahami, meski detail implementasinya kompleks. ZNE bekerja dengan:
-
Menjalankan target circuit pada beberapa "tingkat noise" — modifikasi pada circuit yang membuat noise-nya berskala dengan cara yang bisa diprediksi
-
Memperkirakan observable yang diminati untuk setiap skala noise.
-
Mengekstrapolasi kembali ke noise nol memakai model fitting (linear, polinomial, eksponensial, dan sebagainya).
Hasilnya adalah perkiraan nilai observable di batas tanpa noise sesuai model ekstrapolasi.
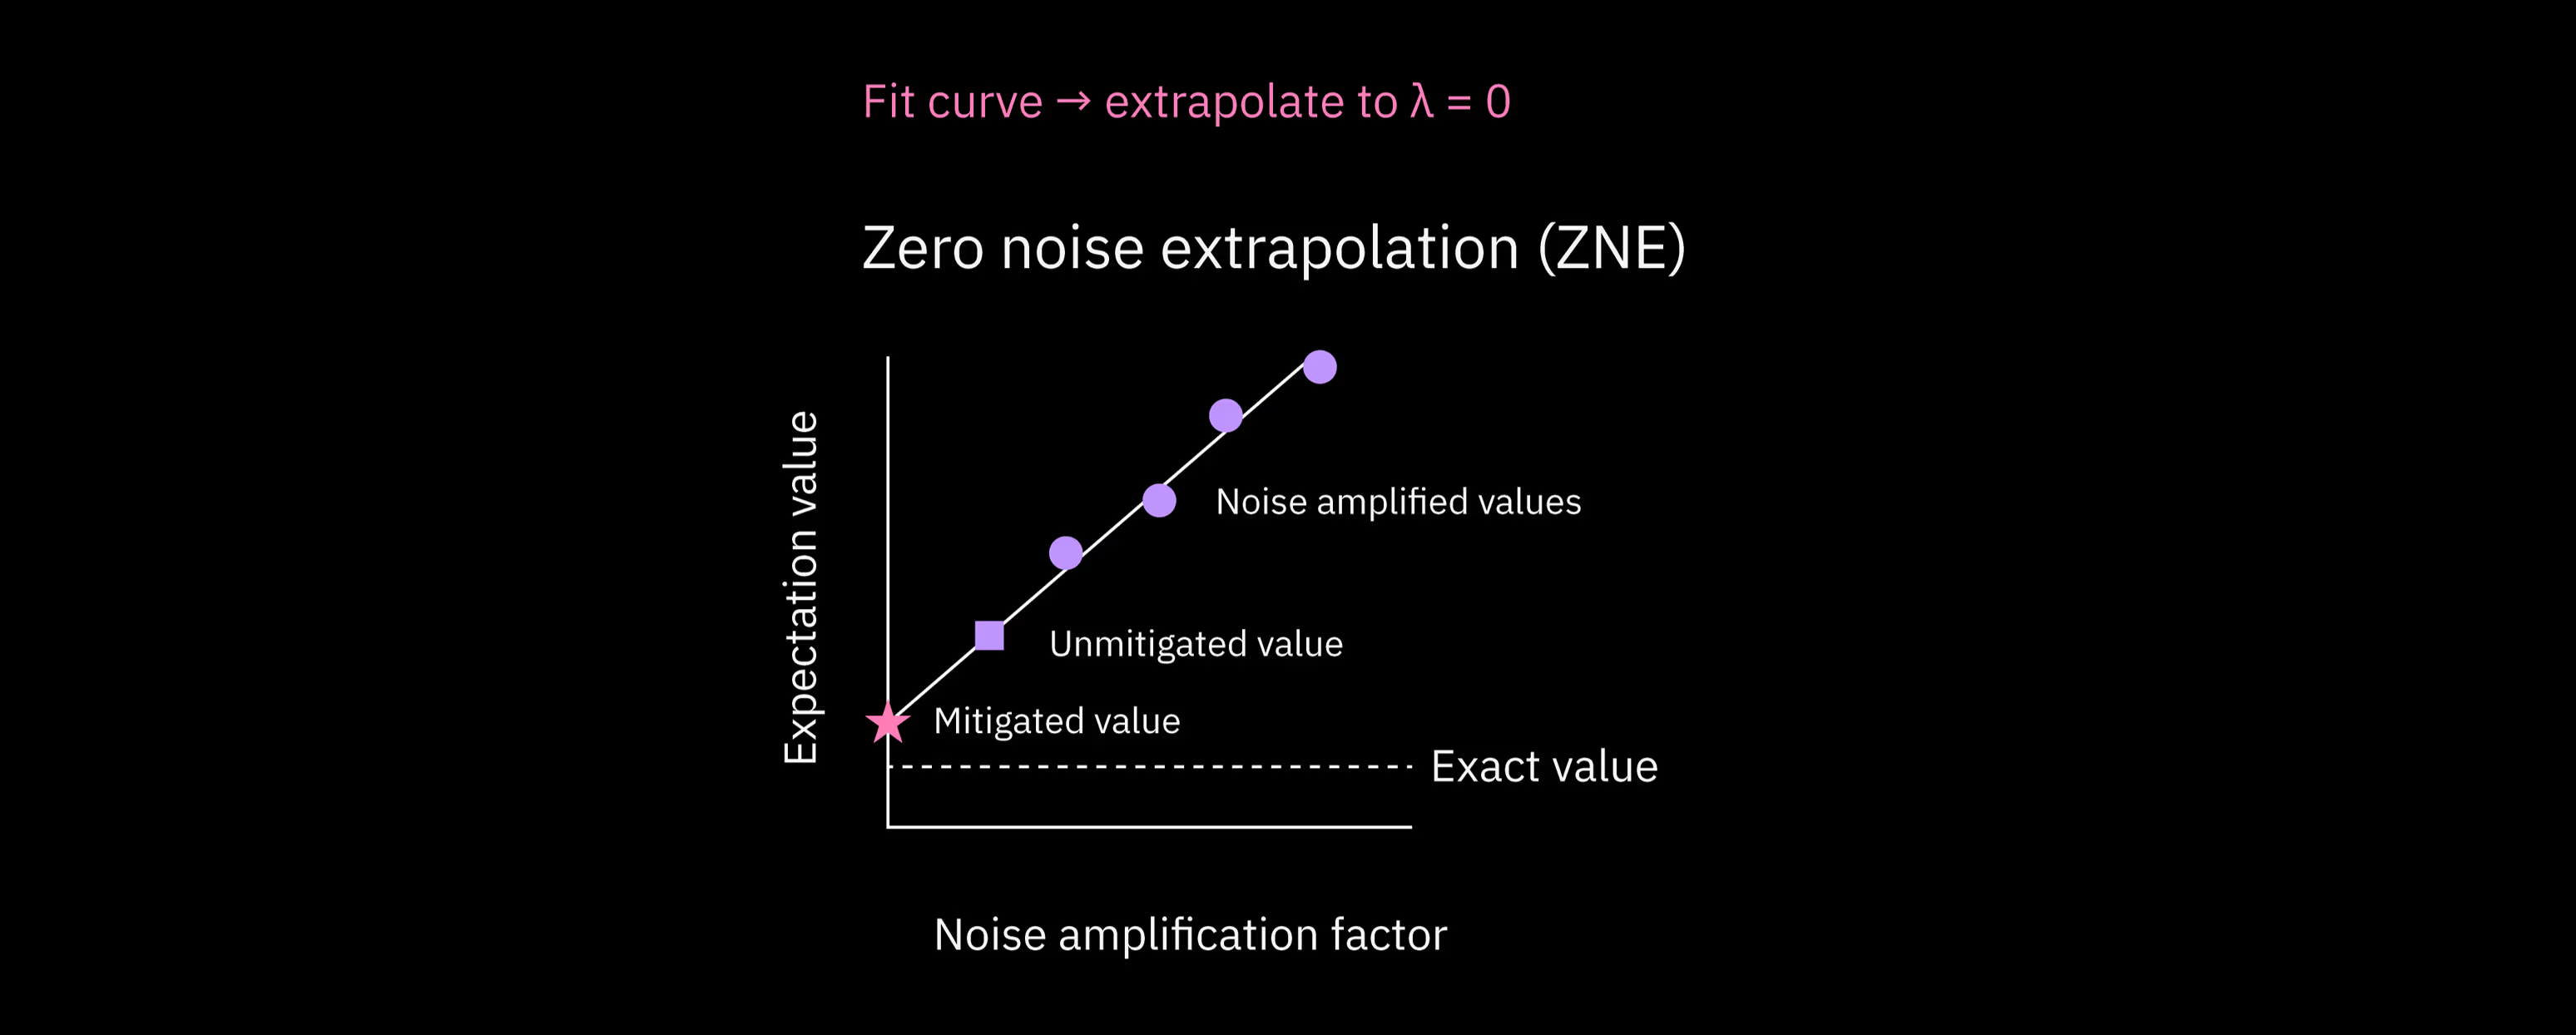
ZNE tidak menjamin noise naik secara mulus atau linear saat kita memodifikasi circuit. Sebaliknya, ZNE mengasumsikan bahwa penskalaan noise cukup berperilaku baik untuk memungkinkan ekstrapolasi. Kerumitan ZNE ada pada cara memodifikasi circuit supaya asumsi ini terpenuhi sebaik mungkin. Kita akan membahas beberapa pendekatan di pelajaran ini.
Penskalaan resource ZNE
Di ZNE, overhead-nya sebagian besar adalah overhead kuantum. Artinya, untuk mendapatkan nilai ekspektasi pada tingkat noise, kamu harus menjalankan eksperimen pada circuit, masing-masing dengan banyak shot. Untuk menjaga presisi statistik tetap, jumlah total sampel umumnya bertambah seiring bertambahnya circuit berskala noise.
Jumlah tingkat noise yang kamu periksa, , bergantung pada metode yang dipakai untuk menskalakan noise. Untuk satu teknik penskalaan noise yang sederhana (disebut "gate-folding", dibahas di bawah), biasanya antara 3 dan 5. Metode lain (probabilistic noise amplification (PNA)) memungkinkan faktor noise non-integer, dan biasanya menghasilkan tingkat noise yang lebih rendah daripada gate-folding. Total overhead berskala kira-kira sebagai:
dengan adalah jumlah shot dasar. Hal lain yang perlu diingat: kalau penskalaan noise melibatkan gate berulang, depth circuit bisa naik dengan faktor yang sebanding dengan nilai penskalaan noise. Penskalaan noise yang menyertai bertambahnya depth memang tujuannya, tapi tetap perhatikan total depth-nya.
ZNE cocok untuk masalah yang memenuhi poin-poin berikut:
-
Kamu butuh metode mitigasi serba guna yang efektif untuk banyak jenis error.
-
Depth circuit tidak terlalu besar; ZNE gagal ketika circuit berskala menjadi terlalu noisy untuk diekstrapolasi.
-
Kamu bisa menoleransi overhead runtime yang moderat demi akurasi yang lebih baik.
Dalam praktiknya, ini membuat ZNE ideal untuk banyak variational circuit, estimasi nilai ekspektasi, dan algoritma kuantum near-term lainnya. ZNE diimplementasikan di Estimator dengan resilience_level = 2. Perhatikan bahwa ZNE mengekstrapolasi di ruang yang punya satu hasil sebagai fungsi noise di seluruh circuit. Artinya ZNE cocok untuk masalah estimasi, tapi tidak untuk masalah sampling. ZNE tidak dirancang untuk bekerja pada distribusi bitstring.
Faktor noise
Bagaimana persisnya kita bisa menaikkan tingkat noise di sebuah circuit? Ada dua cara utama, meski banyak variannya.
-
Ganti sebuah gate atau blok gate dengan . Karena gate di komputer kuantum bersifat unitary, kita tahu sehingga secara logika: . Namun, setiap pengulangan atau menambah error yang mirip atau identik, sehingga kita bisa menaikkan tingkat noise/error. Perhatikan bahwa penggantian di atas membawa kita dari noise asli gate (tingkat noise 1) ke tiga kali tingkat noise itu pada (tingkat noise 3). Dalam praktiknya, kita bisa mengulang dua gate terakhir sebanyak kali: untuk mendapat tingkat noise . Ini disebut gate folding, dan merupakan teknik penskalaan noise yang sangat umum.
-
Ada metode lain untuk menaikkan tingkat noise, seperti probabilistic error amplification (PEA). Di PEA, pertama kita mempelajari model noise yang sesuai untuk circuit, biasanya dinyatakan sebagai Pauli channel. Noise kemudian diperkuat dengan melakukan sampling dari versi terskala ulang dari noise channel yang dipelajari ini. Dengan menyesuaikan sampling, kamu bisa menskalakan kekuatan noise efektif secara kontinu, termasuk ke nilai non-integer.
Dalam praktiknya, gate folding bisa menskalakan error dengan sangat andal, tapi juga bisa menghasilkan circuit yang sangat dalam. Kalau kamu hanya butuh tiga tingkat noise (1, 3, dan 5), itu berarti menaikkan depth circuit kamu 5 kali lipat dan tetap mendapat hasil yang wajar. Jadi, kalau target circuit kamu punya depth dua-qubit hasil transpile sebesar 60 atau lebih, PEA kemungkinan lebih cocok daripada gate-folding.
Gate bisa di-fold secara lokal (artinya kamu mengulang untuk setiap gate dua-qubit segera setelah muncul), atau bisa dikelompokkan menjadi satu blok gate dan blok itu diulang (seperti gate ). Sering kali folding lokal lebih disukai demi asumsi yang dibuat ZNE, tapi keduanya mungkin dilakukan.
Banyak nuansa dalam perlakuan statistik hasil berskala noise di ZNE. Misalnya, pada tingkat noise lima kali lipat, hasilmu pasti punya varians lebih tinggi dan kurang andal. Haruskah itu diberi bobot yang sama dengan data bernoise lebih rendah? Tidak. Meski begitu, demi melihat ZNE beraksi, kita akan mengabaikan sebagian kerumitan ini untuk eksperimen model mainan, di mana kita membangun circuit hasil folding secara manual, dan melakukan ekstrapolasi naif dengan bobot sama untuk menggambarkan langkah-langkah kuncinya. Tapi setelah itu kita akan melakukan eksperimen dengan fungsionalitas ZNE bawaan Qiskit, dan kita akan lihat bahwa hasilnya jauh lebih baik dalam menangani kerumitan yang kita lewati.
ZNE secara manual
Kita mulai dengan memilih quantum circuit dan observable yang nilai ekspektasi idealnya bisa kita hitung tanpa noise dan error. Kita memilih state GHZ , dengan jumlah qubit genap. Observable kita adalah . Kita memilihnya karena beberapa alasan:
- Nilai ekspektasi sepele dihitung pada kasus ideal. Karena jumlah qubit genap, kita mendapat
1dari setiap , yang dikalikan bersama, atau mendapat-1dari setiap , yang dikalikan bersama sebanyak bilangan genap kali. - Ini cukup sensitif terhadap error dan noise, karena satu error pada satu qubit bisa membalik hasil keseluruhan dari shot itu dari +1 menjadi -1.
- Nilai ekspektasinya jauh dari 0. ZNE bisa mengalami kesulitan ketika nilai ekspektasi ideal sangat dekat dengan nol, karena tingkat noise tinggi cenderung mengacak hasil, membuatnya positif sesering negatif. Akibatnya, nilai noise tinggi akan berakhir menghasilkan nilai yang dekat dengan ideal; ini bisa membuat ekstrapolasi sangat sulit.
Dengan motivasi ini, mari kita bangun circuit kita.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Perhatikan hal halus bahwa di sini . Meski gate folding dikatakan terdiri dari operator berbentuk , di sini struktur yang sama itu tampak seperti CNOT CNOT CNOT.
Mari pastikan circuit ke- kita memang circuit GHZ normal:
ghz_amp[0].draw("mpl")
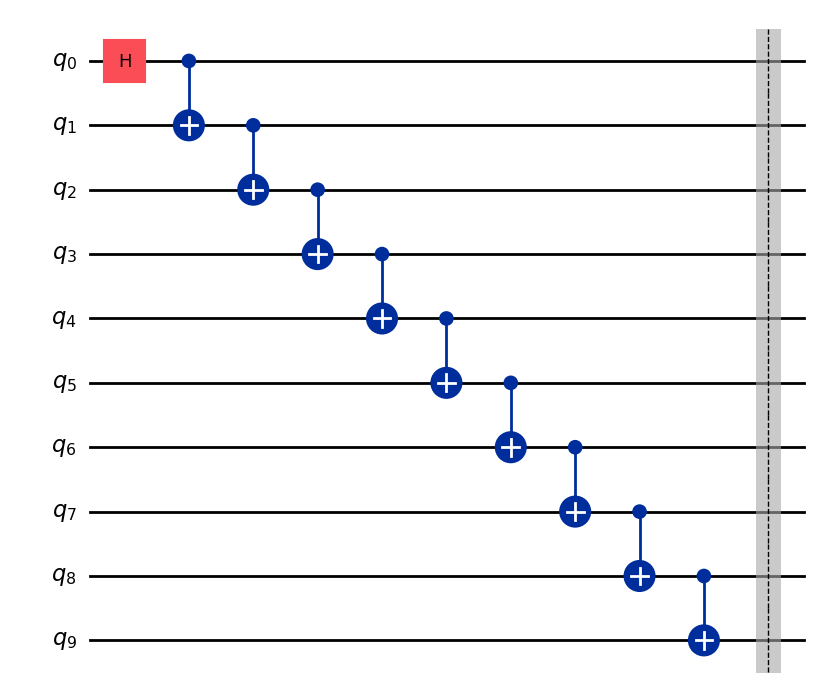
Kamu bisa melihat circuit lainnya untuk memverifikasi bahwa strukturnya sesuai harapan.
Sekarang kita bangun observable kita.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Kita membangun pass manager dan menerapkannya ke circuit kita. Lalu kita ambil layout-nya dan terapkan ke observable kita.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Format pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Sekarang kita jalankan Estimator. Kita ingin fokus pada peran ZNE, jadi mungkin kita ingin mengatur resilience_level = 0 supaya efek twirling tidak bercampur dengan efek ZNE. Namun, kita juga ingin membandingkan ZNE "manual" kita dengan pengaturan ZNE bawaan Qiskit, yang menyertakan twirling. Jadi di sini kita atur resilience_level = 1. Mengatur resilience_level = 2 akan memanggil pengaturan ZNE Qiskit, yang akan kita pakai sebentar lagi.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Sekarang kita cetak tingkat noise dan nilai ekspektasinya.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Ini bagian di mana kita paling ceroboh: kita melakukan fit linear pada data ini tanpa memperhatikan varians tiap nilai yang kita peroleh, dan tanpa mencoba memprediksi secara teoretis apakah fit-nya perlu linear. Sekali lagi, ZNE bawaan bekerja jauh lebih baik daripada yang kita lakukan secara manual.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Kita langsung buat plot-nya sebelum diinterpretasikan.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
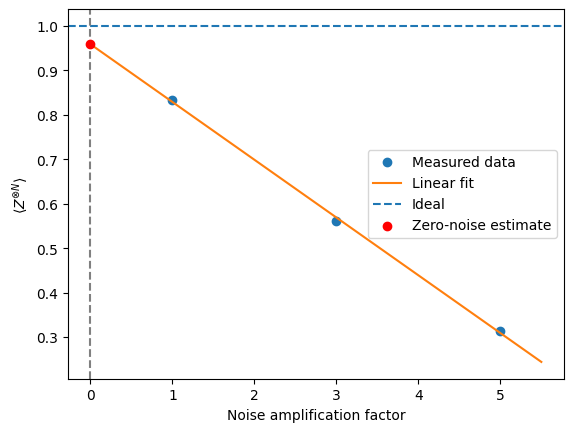
Saat pelajaran ini dibuat, dari ekstrapolasi ke kasus tanpa noise, kita mendapat nilai ekspektasi 0.959. Nilaimu mungkin berbeda. Ini jauh lebih baik daripada nilai ekspektasi circuit mentah sebesar 0.83, sekitar 13% lebih dekat ke nilai ideal. Tapi kamu juga bisa melihat bahwa kita memakai satu titik data di mana nilai ekspektasinya turun sampai 0.31. Jelas titik data ini kualitasnya lebih buruk. Kalau titik data itu diberi bobot lebih rendah dalam aproksimasi linear kita, dan garisnya di-fit lebih ke dua titik data pertama, kita bisa melihat estimasi hasil ekstrapolasi ke nol akan lebih tinggi (lebih dekat ke nilai ideal). Pertimbangan semacam ini ditangani secara otomatis di ZNE bawaan Estimator.
ZNE bawaan Estimator
Sekarang mari kita lihat apa yang terjadi ketika kita memakai fungsionalitas ZNE bawaan Estimator. Kita mulai dengan mendefinisikan circuit GHZ sederhana, tanpa gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Kita mendefinisikan observable yang sama seperti sebelumnya.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Kita sekali lagi mendefinisikan pass manager, dengan optimization_level = 1. Kita akan kembali membahas pilihan ini di bawah.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpile circuit dan terapkan layout ke observable.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Kita menjalankan Estimator dengan ZNE dan twirling, lalu membandingkan hasilnya dengan implementasi ZNE manual kita. Secara khusus, kita bandingkan dengan hasil tanpa ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Kita bisa mengambil nilai pada tiap faktor noise dengan sintaks job_zne.result()[0].data.evs_noise_factors. Seperti sebelumnya, kita bisa saja memakai hasil ini secara naif untuk mendapat fit linear dan mengekstrapolasi ke kasus tanpa noise, tapi estimator dengan resilience_level = 2 sudah bekerja lebih baik, dengan memperhitungkan varians dan pertimbangan lain. Di bawah kita tunjukkan apa yang akan dihasilkan ekstrapolasi linear, dan apa yang sebenarnya dihasilkan ZNE bawaan.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
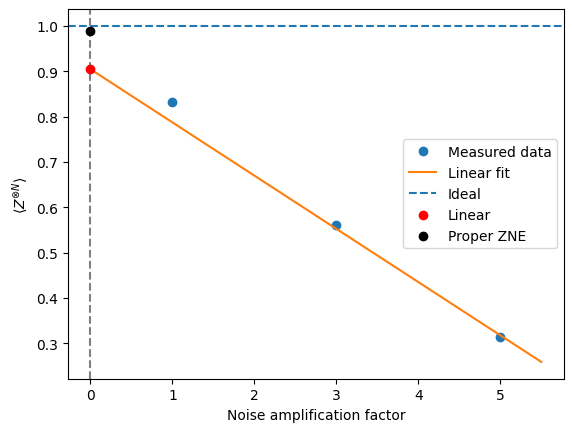
Kita lihat bahwa ZNE bawaan memperbaiki estimasi kita lebih dari 15%, dan bekerja jauh lebih baik daripada upaya manual kita.
Sebelum lanjut, perhatikan bahwa selama eksplorasi ZNE ini, kita mengatur optimization_level = 1 di pass manager. Tingkat optimisasi yang lebih tinggi mengurangi error, dan kadang pengurangan error itu bisa membuat error berskala kurang bisa diprediksi. Seperti biasa, ada keseimbangan: kurangi error, kecuali saat kamu sengaja menaikkannya dengan faktor yang diketahui.
Menggabungkan metode
ZNE bergantung pada hal-hal berikut:
-
Parameter penskalaan noise yang terdefinisi dengan baik
-
Penskalaan nilai ekspektasi terhadap yang cukup mulus dan bisa diprediksi
-
Noise channel efektif yang sama, pada kekuatan berbeda
-
Tidak ada bias yang diperkenalkan yang tidak berskala dengan
ZNE bisa digabung dengan mulus bersama teknik yang menghilangkan bias non-skala (seperti M3) atau membuat noise lebih teratur (seperti twirling), tapi bertentangan dengan teknik yang berusaha membatalkan noise sepenuhnya (PEC) atau membentuk ulang noise secara dinamis (DD).
Secara khusus, M3 hanya menangani error pengukuran/readout, yang dalam praktiknya bisa dianggap terpisah dari error gate (yang menjadi fokus proses penskalaan error di ZNE). M3 sebagian besar independen dari gate folding; M3 bisa digabung dengan ZNE secara bersih. TREX sangat mirip, dan bisa digabung dengan ZNE.
Pauli twirling memang berfokus pada gate, tidak seperti M3 dan TREX. Namun, ingat bahwa Pauli twirling tidak memitigasi error/noise secara langsung; melainkan mengubahnya agar lebih mudah diprediksi. Pauli twirling bisa jadi malah menguntungkan proses ZNE karena membuat error gate berskala lebih linear sehingga ekstrapolasi lebih akurat.
Dynamical decoupling (DD) lebih bernuansa. DD secara dinamis mengubah perilaku noise dengan membatalkan sebagian error tertentu lewat penambahan urutan gate. Kalau circuit bisa dibangun sedemikian rupa sehingga DD berperilaku sama bahkan ketika gate atau blok di-fold, maka secara prinsip kita bisa menggabungkan ZNE dan DD, tapi dalam praktiknya DD kadang mengganggu penskalaan. Kalau kamu ingin menggabungkannya, hal yang perlu dipertimbangkan antara lain:
- Apakah DD diterapkan secara konsisten di semua tingkat noise?
- Apakah folding mempertahankan struktur DD?
- Apakah penskalaan noise yang dihasilkan masih berperilaku monotonik?
Metode error mitigation terakhir yang akan kita bahas sebagai pendekatan mandiri tidak kompatibel dengan ZNE: probabilistic error cancellation.
Probabilistic Error Cancellation (PEC)
Tidak seperti ZNE atau mitigasi pengukuran, PEC berusaha membatalkan noise pada level gate dengan merekonstruksi channel ideal secara ekspektasi. Probabilistic Error Cancellation (PEC) adalah teknik error-mitigation yang paling kuat sekaligus paling mahal yang dibahas di pelajaran ini. PEC dibangun di sekitar inversi eksplisit dari noise channel, yang dilakukan secara statistik, bukan secara fisik. PEC bekerja dengan:
-
Mengkarakterisasi model noise dalam basis "operasi error."
-
Menyatakan invers dari noise channel sebagai distribusi quasi-probability atas operasi fisik.
-
Melakukan sampling dari distribusi ini selama eksekusi circuit untuk membangun secara statistik estimasi tak bias dari komputasi ideal.
Secara konseptual, PEC seperti koreksi error virtual — PEC "membatalkan" noise dengan menggabungkan operasi bernoise dalam pola acak yang bobotnya diatur dengan cermat. Namun secara prosedur, PEC tidak terkait erat dengan error correction atau kode deteksi error. Estimasi tak bias PEC terhadap nilai ekspektasi ideal tanpa noise datang dengan harga overhead sampling yang sangat besar dan ketergantungan kuat pada karakterisasi noise yang akurat.
Di komputer kuantum IBM, PEC paling tepat dipandang sebagai alat presisi, bukan lapisan mitigasi serba guna: PEC paling cocok untuk circuit kecil atau bagian kecil dari circuit yang lebih besar, tugas benchmarking, dan studi berakurasi tinggi di mana overhead kuantum yang tinggi bisa diterima.
Mengkarakterisasi noise channel
Di PEC, setiap gate ideal dalam quantum circuit dimodelkan sebagai unitary channel ideal yang diikuti oleh proses noise. Misalkan menyatakan density matrix dari quantum state. Gate ideal direpresentasikan oleh matriks unitary , yang menginduksi quantum channel:
Pada hardware sungguhan, evolusi ideal ini dirusak oleh noise. Kita memodelkan implementasi fisik dari gate sebagai noisy channel efektif:
dengan adalah noise channel yang menangkap error stokastik yang terkait dengan gate. Sepanjang pembahasan ini, , , dan adalah peta linear yang bekerja pada operator densitas. Channel ideal bersifat unitary dan reversibel, sedangkan noise channel (dan karenanya ) adalah peta completely positive, trace-preserving (CPTP).
PEC mengasumsikan bahwa noise channel diketahui atau kira-kira diketahui. Pada hardware IBM Quantum, informasi ini biasanya diperoleh dari data kalibrasi perangkat, laju error yang disimpulkan dari eksperimen benchmarking, dan model noise yang disederhanakan seperti aproksimasi Pauli atau depolarizing untuk set gate kecil. Meski PEC tidak membutuhkan model noise yang sempurna akurat, kinerjanya menurun dengan cepat ketika noise channel yang diasumsikan menyimpang dari perilaku hardware sebenarnya.
Dekomposisi quasi-probability dari invers noise channel
Gagasan utama PEC adalah membatalkan efek noise secara ekspektasi dengan membangun aproksimasi stokastik dari invers noise channel. Secara formal, tujuannya adalah menerapkan peta linear yang kira-kira membatalkan , sehingga:
secara ekspektasi atas banyak eksekusi circuit.
Invers di sini didefinisikan sebagai invers aljabar dari yang diperlakukan sebagai superoperator linear yang bekerja pada operator. Invers ini ada hanya jika berperingkat penuh (full-rank); proses noise yang tidak bisa diinversi tidak dapat dimitigasi secara tepat dengan PEC.
Ketika inversi memungkinkan, PEC menyatakan invers noise channel sebagai kombinasi linear dari operasi yang bisa diimplementasikan secara fisik:
Di sini, setiap adalah operasi bernoise yang bisa dieksekusi di hardware (biasanya gate native atau urutan gate pendek), dan koefisien real membentuk distribusi quasi-probability. Berbeda dengan probabilitas biasa, koefisien bisa negatif atau melebihi 1.
Norma quasi-probability:
mengukur biaya inversi noise. Untuk noise channel nontrivial apa pun, . Pada hardware IBM Quantum, dekomposisi ini biasanya dilakukan:
- per gate atau per set gate kecil,
- dengan mengasumsikan model noise terbatas (sering aproksimasi Pauli-diagonal),
- menggunakan operasi native spesifik backend dan batasan penjadwalan.
Rekonstruksi Monte Carlo dari circuit ideal
Untuk memperkirakan nilai ekspektasi dari observable , PEC memakai sampling Monte Carlo berdasarkan dekomposisi di atas. Untuk setiap kemunculan gate bernoise di circuit, prosedur berikut diterapkan:
-
Pilih secara acak sebuah operasi dengan probabilitas:
-
Tetapkan bobot klasik:
-
Eksekusi circuit bernoise acak yang dihasilkan di backend kuantum.
-
Kalikan hasil pengukuran dengan hasil kali semua bobot yang terakumulasi.
-
Rata-ratakan hasil berbobot itu atas banyak eksekusi circuit.
Estimator yang dihasilkan memenuhi
asalkan model noise menggambarkan hardware dengan akurat. Jadi PEC memperkenalkan tidak ada bias sistematis secara ekspektasi, tapi menukar bias dengan varians statistik yang besar. Setiap run menghasilkan estimasi yang noisy tapi berbobot; hanya setelah merata-ratakan banyak run seperti itu nilai ekspektasi ideal muncul.
Interpretasi konseptual
PEC kadang digambarkan sebagai virtual error correction. Meski pernyataan ini tidak sepenuhnya salah, jangan disamakan dengan quantum error correction yang sebenarnya. PEC tidak melibatkan logical encoding, tidak ada syndrome extraction, dan tidak ada umpan balik real-time. Error tidak dicegah atau dikoreksi selama eksekusi circuit.
Sebaliknya, PEC membatalkan noise secara statistik, dengan menggabungkan banyak realisasi circuit bernoise dengan bobot klasik bertanda sehingga error saling membatalkan hanya setelah post-processing klasik. Informasi tidak dilindungi selama eksekusi; hasil ideal direkonstruksi setelah kejadian.
Penskalaan resource dan biaya
Biaya dominan PEC berasal dari penguatan varians. Varians estimator PEC berskala sebagai:
yang menyiratkan:
Penskalaan ini bersifat fundamental dan tidak bisa diperbaiki lewat post-processing klasik.
Untuk circuit yang berisi banyak gate bernoise, setiap gate menyumbang faktor , sehingga norma quasi-probability total tumbuh kira-kira secara perkalian:
dengan adalah depth circuit. Pada hardware IBM Quantum, ini biasanya menyebabkan pertumbuhan eksponensial biaya sampling terhadap depth circuit, dengan sensitivitas yang sangat kuat terhadap error gate dua-qubit. Penskalaan ini membatasi penerapan PEC secara praktis.
PEC saat ini praktis hanya ketika satu atau semua kondisi berikut terpenuhi:
-
Circuit sangat kecil atau dangkal (sering gate),
-
Model noise sederhana dan tervalidasi dengan baik (misalnya noise Pauli),
-
Biaya statistik yang tinggi bisa diterima,
-
Tujuannya adalah akurasi, bukan throughput.
Karena itu, PEC sering diterapkan pada:
-
Subcircuit terisolasi di dalam workflow yang lebih besar,
-
Langkah evolusi waktu singkat,
-
Rutinitas persiapan state atau pengukuran,
-
Eksperimen benchmarking dan validasi.
Software stack IBM (IBM Quantum Compute dan tooling error-mitigation) mencerminkan hal ini dengan memperlakukan PEC sebagai opsi khusus, bukan lapisan mitigasi default.
Contoh kasus penggunaan PEC yang umum meliputi:
-
Benchmarking presisi untuk hardware kuantum,
-
Verifikasi algoritma kuantum kecil,
-
Kimia kuantum dengan akurasi tinggi pada sistem yang direduksi,
-
Pengecekan silang ZNE atau metode mitigasi lainnya.
Hubungan PEC dengan metode mitigasi lainnya
Banyak teknik mitigasi lain mengorbankan akurasi demi skalabilitas; PEC justru kebalikannya, yaitu mengutamakan akurasi di atas segalanya.
Karena PEC mungkin hanya dipakai pada sebuah subcircuit, di sini penting sekali untuk bertanya metode mitigasi lain apa yang bisa dikombinasikan dengannya. Untuk menalar kompatibilitas dengan PEC secara jelas, ada baiknya mengelompokkan teknik berdasarkan apa yang mereka lakukan terhadap noise. Perhatikan kategori umum berikut:
-
Pembatalan noise - berusaha membalik error channel
-
Penskalaan noise - sengaja menaikkan noise untuk ekstrapolasi
-
Pembentukan ulang noise - mengubah struktur atau spektrum noise
-
Penghapusan bias - mengoreksi error yang tidak berskala dengan noise Gate
PEC jelas berada di kategori (1). Metode apa pun yang mengubah atau menskalakan ulang noise channel harus diperiksa dengan hati-hati.
Tabel ringkasan (tingkat tinggi)
| Teknik | Kompatibel dengan PEC | Catatan |
|---|---|---|
| ZNE | Tidak | Membatalkan versus menskalakan, dan kadang menyesuaikan error |
| Pauli twirling | Ya (dengan hati-hati) | Memengaruhi perilaku error, tetapi mungkin membuatnya lebih mudah dipelajari |
| TREX | Ya | Tidak ada tumpang tindih dalam alur kerja. Sepenuhnya kompatibel. |
| Dynamical decoupling | Biasanya tidak | Mengubah error channel |
PEC dan ZNE menangani sumber error yang sama (error Gate) lewat asumsi atau alur kerja yang saling tidak kompatibel, atau keduanya. Misalnya, pada ZNE kita berasumsi error bisa diekspansi dalam parameter :
dan error tersebut bisa diskalakan secara efektif untuk memodelkan ekspansi ini. PEC akan membatalkan error yang justru kita andalkan untuk penskalaan. Parameter jadi tidak bermakna. Cara lain memikirkannya:
-
Menerapkan ZNE sebelum PEC mengubah noise channel yang mau Anda balik.
-
Menerapkan PEC sebelum ZNE menghilangkan noise yang diandalkan ZNE untuk ekstrapolasi.
PEC dan ZNE sebaiknya dianggap sebagai paradigma mitigasi error alternatif, bukan lapisan yang bisa digabungkan. Membandingkan keduanya secara berdampingan itu bermanfaat, sedangkan menggabungkannya tidak.
PEC dan Pauli twirling umumnya kompatibel dan sering menguntungkan. Twirling bisa membantu PEC karena twirling mengubah error koheren menjadi error Pauli stokastik. Ini menyederhanakan noise channel sehingga lebih mudah direpresentasikan dan dibalik. Bagi PEC, ini sangat berharga karena alasan berikut:
-
Dekomposisi quasi-probability jauh lebih sederhana untuk Pauli channel
-
Norma quasi-probability sering kali jauh lebih kecil
-
Varians sampling berkurang
Banyak demonstrasi PEC mengasumsikan atau membangun noise yang sudah di-Pauli-twirl. Penting untuk ditegaskan bahwa Pauli twirling tidak memitigasi error dengan sendirinya; ia membentuk ulang noise ke bentuk yang bisa ditangani probabilistic error cancellation dengan lebih efisien.
PEC bisa dan sebaiknya dikombinasikan dengan TREX. Kedua pendekatan ini sepenuhnya kompatibel dan berperan secara ortogonal. TREX hanya bekerja pada pengukuran, menghilangkan bias readout lewat twirl acak pada measurement channel, dan tidak memengaruhi noise Gate maupun dinamika Circuit. PEC bekerja pada noise Gate. Karena error pengukuran bersifat aditif, bukan komposisional, ia tidak bergantung pada urutan Gate. Aman dan sering diinginkan untuk menerapkan TREX bersama PEC.
Urutan metode-metode ini sesuai dugaan Anda:
- Jalankan Circuit PEC yang diacak
- Terapkan TREX untuk memitigasi error readout
- Terapkan pembobotan dan perataan PEC
PEC dan DD umumnya tidak kompatibel kecuali karakterisasi noise yang dipakai untuk PEC dilakukan dengan DD aktif. PEC mengasumsikan bahwa bersifat stasioner, dapat diulang, dan dapat dikarakterisasi dengan akurat. DD secara eksplisit membentuk ulang noise channel dalam waktu dengan memodulasi interaksi sistem-lingkungan dan memunculkan efek pewaktuan pulsa yang tidak sepele. Akibatnya, noise efektif dengan DD bukan channel yang sama dengan tanpa DD. Ini makin rumit karena noise channel bisa sangat bergantung pada penjadwalan Circuit. Hasil akhirnya, pembalikan noise menjadi tidak terdefinisi dengan baik atau tidak valid.
Secara teori, memang mungkin mengkarakterisasi noise dengan DD aktif lalu membangun model PEC yang sesuai, tetapi ini sangat tingkat lanjut dan saat ini bukan alur kerja yang direkomendasikan.
Menerapkan PEC secara manual
PEC itu kompleks dan tidak disarankan untuk diimplementasikan secara manual. Meski begitu, kita ingin menelusuri matematika dari penerapan dasar pada satu qubit untuk memahami langkah apa saja yang terlibat. Kita memilih state campuran yang tidak sepele supaya efek numeriknya terlihat jelas.
Ambil sebuah qubit yang seharusnya berada di pure state
Matriks densitas idealnya adalah:
Kita memilih matriks densitas ini karena tidak diagonal dan hanya untuk satu qubit, sehingga mudah diperiksa "secara manual".
Sekarang kita terapkan model noise yang sangat sederhana tetapi realistis: depolarizing channel satu qubit dengan kekuatan kecil .
Supaya hitungannya mudah, ambil . Channel ini completely positive, trace-preserving (CPTP), sebagaimana mestinya. Channel ini realistis untuk hardware nyata, atau setidaknya realistis untuk menggambarkan sebagian noise. Lebih jauh, noise channel ini dapat dibalik secara analitis sebagai pemetaan linear. Dengan kata lain, ada matriks inversnya, tetapi itu tidak berarti matriks tersebut sesuai dengan channel fisik CPTP, dan jelas tidak sesuai dengan unitary yang bisa diimplementasikan di hardware.
Sekarang kita terapkan depolarizing noise channel ke matriks densitas satu qubit kita dan diperoleh:
Dengan : dan .
So:
Menerapkannya pada state kita:
Hitung secara eksplisit:
Ini masih matriks densitas fisik, dan trace-nya masih satu — tetapi sekarang lebih tercampur.
Sekarang kita hitung inverse channel yang ideal, tetapi dengan kesiapan penuh bahwa ia mungkin tidak fisik. Kita akan memeriksa apakah ia fisik. Secara matematis, pemetaan linear inversnya adalah:
Jika aksi invers ini sendiri merupakan channel fisik yang valid, kita akan tergoda untuk mengimplementasikannya secara persis. Tentu kita masih harus mencari cara mengimplementasikannya dengan operasi unitary dan langkah klasik, tetapi itulah tujuannya. Namun, ternyata ini bukan CPTP, dan secara umum tidak ada jaminan bahwa pemetaan invers seperti itu CPTP. Hal itu penting untuk pembahasan kita sekarang, karena itulah alasan PEC ada.
Anda mungkin bisa melihat bahwa ini bukan CPTP hanya dengan memandanginya. Cara pengecekan yang pasti adalah menerapkannya pada sebuah matriks densitas dan melihat apakah hasilnya fisik. Ini dijadikan latihan untuk menguji pemahaman Anda.
Uji pemahaman Anda
Periksa apakah pemetaan invers di atas CPTP dengan menerapkannya pada matriks densitas baru:
Tafsirkan hasilnya sebagai fisik atau non-fisik.
Jawaban
Sebagai matriks densitas fisik, ini berarti probabilitas klasik lebih dari 1 bahwa sistem berada di state dan probabilitas negatif berada di state . Jelas pemetaan ini bisa menghasilkan matriks densitas yang tidak masuk akal. Selain itu, dengan inspeksi kita bisa melihat bahwa nilai eigen dari matriks densitas hasilnya adalah 1.0625 dan -0.0625, artinya tidak semua nilai eigen positif. Jadi pemetaan ini tidak "completely positive", yaitu "CP" dalam CPTP.
Uji pemahaman Anda
Periksa lewat perhitungan eksplisit bahwa operasi invers di atas membatalkan noise channel dan mengembalikan state bebas noise.
Jawaban
Terapkan pada state yang berisik:
Ini persis state aslinya (sampai pembulatan).
Kita ulangi agar benar-benar jelas: kita tidak bisa membalik noise channel secara persis; inversnya bukan CPTP, dan juga bukan channel fisik yang valid. Namun, kita bisa membalik channel tersebut secara efektif sebagai kombinasi linear dari channel-channel fisik.
Untuk depolarizing channel:
dengan: dan seterusnya.
Inversnya dapat ditulis sebagai:
with:
-
= Clifford channel yang bisa diimplementasikan secara fisik
-
= quasi-probability
-
Some
Inilah ide inti di balik PEC:
-
Sampling channel sesuai ∣
-
Lampirkan tanda pada hasil pengukuran
-
Nilai ekspektasi konvergen ke nilai bebas noise
Kita terapkan PEC "secara manual" untuk mengestimasi dengan memakai matriks densitas dan melihat apakah kita bisa memulihkan hasil untuk . Untuk kita mengharapkan:
Perhatikan juga bahwa untuk matriks densitas yang berisik, kita peroleh:
Orde besarnya sudah benar tetapi masih cukup jauh dari kasus ideal.
Sekarang kita telusuri bagaimana, dengan proses PEC, kita bisa merekonstruksi nilai ekspektasi tak bias dari matriks densitas yang berisik. Dalam alur kerja nyata, ini bersifat probabilistik dan akan diotomatisasi. Dalam alur kerja "manual" ini, kita akan memilih nilai probabilistik yang realistis, tetapi mungkin nyaman untuk presentasi kita. Ini tidak boleh dianggap sebagai klaim bahwa PEC sempurna. Ini hanya untuk menunjukkan skenario masuk akal yang bisa terjadi di dalam paket PEC.
Ingat bahwa noise channel kita berbentuk:
Inversnya dapat ditulis (persis):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Untuk pengantar ini lebih sederhana jika kita fokus pada efek channel terhadap matriks densitas kita. Ini memungkinkan kita bekerja dengan objek yang familier seperti matriks densitas dan nilai ekspektasi. Untuk itu, pertimbangkan apa yang harus benar tentang efek operasi invers ini pada proses estimasi kita: estimator yang dihasilkan PEC harus ternormalisasi dan tak bias. Ini berkaitan dengan dua kondisi:
-
Normalisasi: Agar operasi ini tidak mengubah skala observable, kita membutuhkan . Untuk melihat kenapa begitu, kita bisa meninjau aksi invers pada matriks densitas, atau meninjau aksinya pada nilai ekspektasi sesuatu yang sepele seperti itu sendiri.
-
Kalibrasi: Dalam alur kerja nyata, kita memakai Circuit kalibrasi untuk mempelajari perilaku noise pada level Gate. Kita lalu memakai pengetahuan perilaku noise level Gate itu, dan linearitas nilai ekspektasi, untuk menerapkan model noise yang dipelajari ke Circuit yang lebih besar. Dalam kasus kita, kita mulai dengan pengetahuan buatan bahwa nilai ekspektasi idealnya . Tetapi sangat mudah membuat state yang secara teori kita tahu bahwa itu nilai idealnya, lalu memakai pengukuran nyata untuk kalibrasi. Poin kuncinya, untuk PEC biasanya kita tidak mempelajari model noise lengkap dari seluruh Circuit. Sebaliknya, kita mempelajari model noise lokal untuk Gate individual atau lapisan Circuit dan memakainya untuk membangun dekomposisi quasi-probability.
Kita memakai kondisi-kondisi ini untuk menentukan dan . Kita pertimbangkan ansatz
and apply it to an arbitrary single-qubit density matrix .
Ingat bahwa Pauli channel bekerja lewat konjugasi:
Menerapkan pada menghasilkan:
Dengan mengambil trace, kita peroleh:
Setiap operator Pauli bersifat unitary, sehingga konjugasi mempertahankan trace:
Therefore,
Agar estimator PEC ternormalisasi, pemetaan invers efektif harus mempertahankan trace dari semua matriks densitas. Artinya, kita membutuhkan:
Ini menyiratkan batasan normalisasi:
Tetapi dalam kasus kita, ini menghasilkan kondisi:
Sekarang kita memakai informasi kalibrasi untuk menghubungkan nilai ekspektasi yang teramati dengan nilai ideal yang diketahui.
Or equivalently,
Dengan menyelesaikan kedua kondisi kita untuk dan , kita peroleh:
Koefisien-koefisien ini berjumlah 1, tetapi salah satunya negatif.
Kita bisa memulihkan nilai ekspektasi ideal dengan memodifikasi Circuit secara acak, mengukur, mengalikan hasilnya dengan bobot bertanda, lalu merata-ratakan. Perlu dicatat, tidak ada matriks densitas yang direkonstruksi dan tidak ada inverse channel yang diimplementasikan secara fisik.
Langkah kuncinya: inilah PEC
Untuk kekuatan noise kita , inverse channel dapat ditulis sebagai:
Fakta penting:
-
Koefisien-koefisiennya berjumlah 1
-
Satu koefisien bernilai negatif
-
Setiap suku dapat diimplementasikan secara fisik
-
Negativitasnya dipindahkan ke pasca-pemrosesan klasik
Kita membentuk distribusi sampling dari nilai absolut bobot:
(untuk masing-masing X, Y, Z)
Bobot total:
Untuk probabilitas sampling, bagi dengan W.
| Operasi | Probabilitas | Tanda |
|---|---|---|
| Tidak melakukan apa-apa () | 1.1875 / 1.375 ≈ 0.864 | + |
| Terapkan X | 0.0625 / 1.375 ≈ 0.045 | - |
| Terapkan Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Terapkan Z | 0.0625 / 1.375 ≈ 0.045 | - |
Tanda berasal dari koefisien aslinya, bukan dari probabilitas.
Setiap shot terdiri dari langkah-langkah berikut:
-
Siapkan state
-
Biarkan hardware menerapkan Circuit yang berisik
-
Pilih operasi secara acak dari tabel di atas menggunakan probabilitas yang terkait
-
Apply it
-
Ukur , dapatkan
-
Kalikan hasilnya dengan
-
Catat angka tersebut
Sekarang kita lihat contoh beberapa shot.
Shot 1 (kasus identitas)
Misalkan operasi yang terpilih secara acak adalah identitas (atau setara: tidak melakukan apa-apa). Berdasarkan argumen dan tabel di atas, ini akan terjadi 86.4% dari waktu. Karena koefisien dalam invers noise channel bernilai positif, kita pilih tanda . Pengukuran Z kita bisa saja menghasilkan . Anggap saja hasilnya .
Kontribusi terkoreksi-PEC dari shot ini adalah:
Shot 2 (identitas lagi)
Misalkan kita kembali memperoleh sebagai operasi acak (jadi tanda sukunya awalnya masih ), tetapi kali ini pengukuran Z kita menghasilkan . Kali ini kontribusinya adalah:
Shot 3 (X terpilih)
Kali ini operasi acak kita adalah X. Suku ini dalam invers bernilai negatif, jadi kita pertahankan tanda . Kita terapkan X lalu ukur Z. Lagi-lagi kita bisa memperoleh salah satu nilai eigen; katakanlah kita memperoleh . Kontribusi dari suku ini adalah:
Shot 4 (Z terpilih)
Operasi acaknya adalah Z. Ini memberi kita tanda dari tabel. Misalkan kita mengukur Z dan memperoleh . Kontribusinya adalah:
Shot 5 (Y terpilih)
Operasi acaknya adalah Y. Ini memberi kita tanda dari tabel. Misalkan kita mengukur Z dan memperoleh . Kontribusinya adalah:
Merata-ratakan hasilnya
Bayangkan kita mengumpulkan banyak hasil berbobot-PEC seperti ini:
Secara konstruksi, kita menerapkan identitas 86.4% dari waktu. Kita menerapkan masing-masing Gate lainnya 4.5% dari waktu. Dalam alur kerja nyata, kita tidak tahu state yang mendasarinya secara tepat, begitu juga seluruh noise channel. Tetapi kita tahu faktor pembobot dari atas, dan probabilitas relatif penerapan setiap operasi. Dalam alur kerja nyata, kita mengandalkan matriks densitas yang tidak diketahui untuk memberi kita hasil pengukuran. Di sini kita akan memverifikasi bahwa prosedur ini menghasilkan hasil yang benar.
Kita ingin menghitung rata-rata dari semua pengukuran berbobot dan bertanda, termasuk penerapan operator Pauli sebelum pengukuran. Sebut jumlah total semua shot . Sebut himpunan semua shot yang dikenai Pauli sebagai dan gunakan untuk mengindeks shot-shot ini. Sebut hasil pengukuran shot ke- di bawah penerapan Pauli ke- sebagai . Kita bisa menulis rata-rata ini sebagai:
Operator Pauli diterapkan secara probabilistik dengan probabilitas . Dalam limit jumlah shot yang besar,
Kita bisa memakai ini untuk menulis:
dengan adalah nilai ekspektasi Z hanya pada ensemble shot yang dikenai . Ini berguna karena kita tahu berapa setiap nilai ekspektasi itu dari matriks densitas. Sekali lagi, dalam alur kerja nyata, ini akan muncul dari pengukuran, bukan dari matriks densitas yang diketahui.
Uji pemahaman Anda
Verifikasi nilai ekspektasi di atas lewat perhitungan atau penalaran logis.
Jawaban
Y dan Z dikerjakan persis seperti di atas.
Sekarang kita bisa menulis ulang nilai ekspektasi keseluruhan kita sebagai:
Kalau kita tahu parameter dan untuk noise gate kita (atau lebih banyak parameter untuk kanal noise yang lebih kompleks), itu sudah cukup untuk menentukan (1) faktor bobot keseluruhan, dan (2) probabilitas penerapan operator Pauli. Hasil di atas menunjukkan bahwa kalau kita melakukannya, kita memitigasi noise dan memulihkan nilai ekspektasi yang tidak bias. Rata-rata dari semua shot ini konvergen ke , padahal:
-
Masing-masing shot memberikan kontribusi yang lebih besar dari ±1
-
Beberapa shot punya bobot statistik negatif
-
Setiap operasi kuantum bersifat fisik
Gambaran umum alur kerja PEC
Dalam PEC, semua langkah di komputer kuantum adalah:
-
Pembelajaran noise
-
Persiapan state untuk circuit target kamu
-
Terapkan gate Pauli secara probabilistik seperti dijelaskan di atas
-
Measurement
Peta noise invers yang efektif direalisasikan secara statistik dalam pasca-pemrosesan klasik. Ini memungkinkan inversi yang lebih umum untuk kanal noise yang tanpa cara ini akan membutuhkan langkah non-fisik seperti probabilitas negatif.
Harga yang harus kita bayar untuk ini adalah varians. Setiap shot sebelumnya punya "magnitudo" yang sama dengan magnitudo hasil pengukuran yang mungkin, yaitu . Setelah diskalakan dengan faktor bobot , magnitudonya menjadi (1.375 pada contoh di atas).
Itulah asal-usul sampling overhead pada PEC.
PEC bawaan
Sekarang kita akan memakai PEC seperti yang sudah tertanam di primitif IBM Quantum. Di sini penting untuk membedakan antara PEC penuh di level gate dan model pembelajaran noise lokal untuk PEC yang lebih scalable, yang dipakai oleh primitif IBM Quantum. Overhead dari PEC penuh akan membatasi penerapannya hanya pada circuit kecil. Itu tidak masalah, tetapi lebih berguna punya alat yang bisa diskalakan ke ukuran di mana komputasi kuantum menjadi bernilai untuk masalah dunia nyata. Karena itu, primitif IBM Quantum memakai PEC per layer dengan model noise Pauli-Lindblad yang dipelajari, lengkap dengan pengaman skalabilitas yang agresif. Dalam implementasi PEC ini, noise dipelajari per layer circuit yang berulang, bukan per instans gate, dan model noise-nya di-Pauli-twirl, lokal, dan Markovian. Gate Clifford diserap ke dalam model noise, sementara gate non-Clifford mendominasi biaya mitigasi. Sampling overhead dibatasi agar tidak terjadi ledakan eksponensial.
Kita akan menerapkan PEC bawaan primitif IBM Quantum pada dua skala: kecil (enam qubit) dan menengah (30 qubit) untuk melihat bagaimana biaya tetap terkendali dalam versi PEC ini. Pada setiap ukuran eksperimen, kita juga akan membandingkan secara eksplisit hasil PEC dengan hasil tanpa mitigasi, dengan ZNE, dan dengan nilai ideal.
Kita mulai dengan mengimpor beberapa paket yang diperlukan.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Kita memilih observable untuk diestimasi. Observable di bawah adalah Hamiltonian dari rantai spin mirip Ising dengan kopling tetangga terdekat hanya pada komponen dari interaksinya, dan suku satu qubit pada , seolah-olah akibat medan eksternal pada .
Tidak ada alasan khusus untuk memilih Hamiltonian ini. Kita hanya butuh kombinasi observable dan circuit yang tidak trivial supaya mitigasi error bisa bekerja. Kita menskalakan Hamiltonian secara eksplisit (memakai koefisien), dengan membagi jumlah qubit, sehingga energinya tetap berada di orde besaran yang sama saat jumlah qubit bertambah. Kita mulai dengan hanya enam.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Seperti pada pilihan Hamiltonian, circuit untuk persiapan state di bawah tidak dipilih karena alasan fisika tertentu. Circuit ini dipilih supaya punya kedalaman dua qubit yang cukup dan gate non-Clifford yang cukup banyak sehingga PEC bisa berguna. Tidak ada alasan untuk mengira circuit ini adalah aproksimasi yang baik dari ground state rantai spin ini, misalnya.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
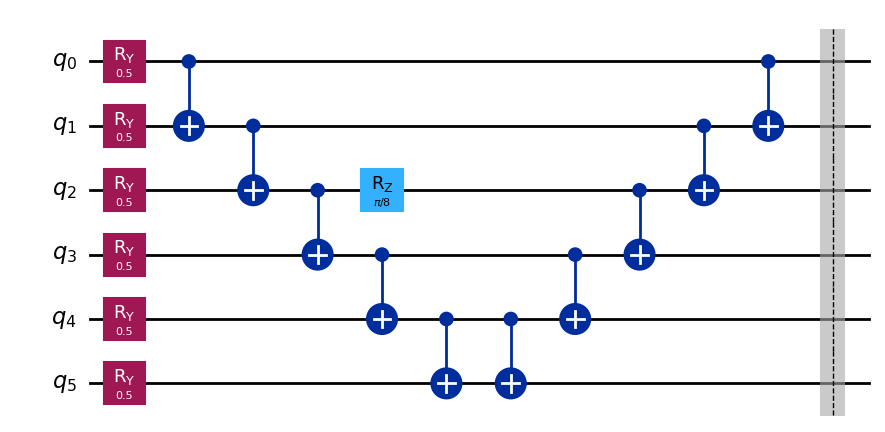
Kita men-transpile circuit kita dan menerapkan layout hasilnya ke observable kita.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Kita memperoleh nilai ekspektasi ideal memakai simulator Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Kita perkirakan nilai ideal lainnya akan berukuran mirip. Sekarang kita jalankan ini di komputer kuantum IBM sungguhan tanpa mitigasi error.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Sekarang kita terapkan ZNE pada masalah yang sama.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Terakhir, kita terapkan PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Di bawah ini kita plot hasilnya dan membandingkannya.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
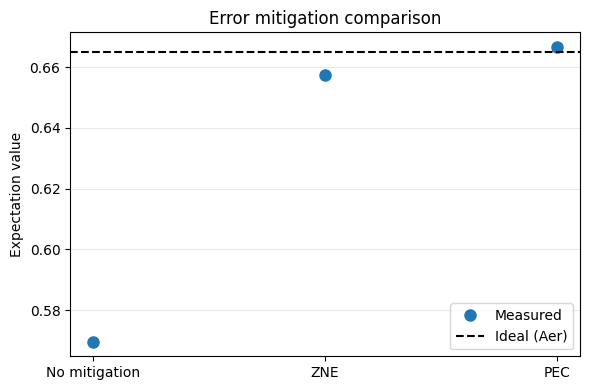
Ini bekerja dengan sangat baik. Estimasi kita memakai PEC hanya berbeda 0.2% dari nilai ideal.
Tapi ingat bahwa overhead kuantum tumbuh secara eksponensial. Kita menetapkan overhead maksimum max_overhead = 100. Dari waktu dan kualitas hasilnya, sepertinya kita mungkin belum mencapai maksimum itu. Namun, kalau kita memperbesar skala perhitungan dan tetap memakai batas maksimum itu, kita akan mencapainya, dan hasil kita akan menurun.
Kita bisa melihat apa yang terjadi saat circuit kita diperbesar sampai 30 qubit. Menariknya, di banyak laptop simulator Statevector akan mulai mengalami timeout sekitar 24-28 qubit. Kita bisa mencari cara komputasi untuk mengatasinya. Tapi sebaliknya, mari kita terima kenyataan bahwa komputer kuantum akan mampu menyelesaikan beberapa masalah pada skala yang tidak bisa diikuti komputer klasik. Itulah intinya. Lalu, apa yang bisa kita lakukan untuk memvalidasi hasil komputasi kuantum kita dalam kasus seperti itu? Ada beberapa jawaban yang mungkin:
- Beberapa masalah sulit diselesaikan tetapi mudah diperiksa (seperti faktorisasi prima pada algoritma Shor).
- Beberapa masalah punya rezim parameter atau varian masalah yang kompleksitasnya menurun dan bisa diselesaikan secara klasik, atau bahkan secara analitik, untuk membandingkan beberapa titik. Dalam kasus ini, kita memilih Hamiltonian yang intrinsik (kita membagi dengan jumlah qubit). Nilai ekspektasi idealnya seharusnya cukup stabil. Mari kita lihat bagaimana nilai ekspektasi ideal berubah terhadap jumlah qubit dan apakah kita bisa membuat prediksi klasik untuk nilai pada 30 qubit.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Memang, kita melihat bahwa kita telah memilih Hamiltonian dan state yang tidak berubah seiring jumlah qubit. Ini pilihan yang sangat buruk untuk aplikasi riset komputasi kuantum, tetapi sangat bagus untuk benchmarking teknik mitigasi error. Kita bisa dengan yakin memakai nilai ekspektasi tetap ini sebagai hasil ideal, bahkan saat kita menambah jumlah qubit untuk menguji mitigasi error.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Sekarang kita jalankan circuit yang lebih besar ini dengan ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Terakhir, kita jalankan contoh 30 qubit dengan PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
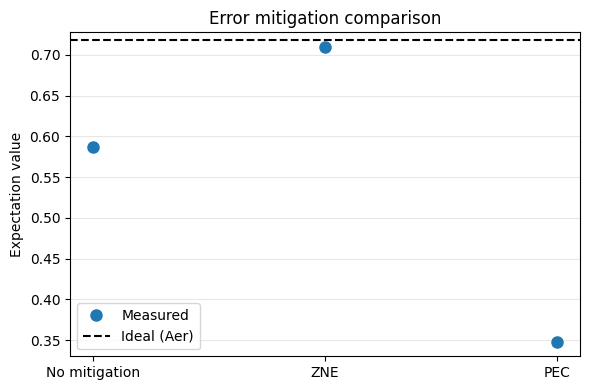
PEC tidak hanya memakan waktu jauh lebih lama daripada opsi lain, tetapi kita jelas mencapai ambang overhead maksimum kita. Hasil PEC sudah membayar harga overhead, tetapi batas overhead mencegah pembatalan model noise yang dipelajari secara cukup akurat. Ini penting. Pada enam qubit, kita bisa memanfaatkan PEC dan mendapat hasil lebih baik dengan peningkatan overhead kuantum yang hanya sedang (sekitar faktor 5). Pada 30 qubit, kita membayar harga yang jauh lebih tinggi (sekitar 60 kali lebih tinggi) dan hasilnya malah lebih buruk daripada estimasi tanpa mitigasi. Ini bukan berarti PEC tidak pernah bisa bekerja dengan 30 qubit; itu mungkin bergantung pada circuit-nya. Pesannya sederhana: pertumbuhan eksponensial overhead kuantum membuatnya sulit dijalankan untuk circuit besar.
Poin-poin penting:
-
Mitigasi pengukuran sering membantu dan biasanya beroverhead rendah: ia menghilangkan bias yang tidak membesar seiring kedalaman circuit dan bisa digabungkan dengan mulus dengan hampir semua teknik lain.
-
Beberapa teknik tidak bisa digabungkan. Bahkan ketika bisa, pastikan kamu menggabungkannya secara konsisten sehingga yang satu tidak membatalkan yang lain. Contoh yang baik adalah memastikan twirling aktif selama kalibrasi untuk M3 jika metode-metode itu akan digabungkan.
-
PEC dan ZNE sebaiknya dipandang sebagai alternatif satu sama lain. Keduanya menyelesaikan masalah yang sama dengan trade-off yang berlawanan:
-
PEC: menghasilkan nilai ekspektasi tanpa bias dengan biaya varians eksponensial.
-
ZNE umumnya menghasilkan bias residual yang bergantung pada model ekstrapolasi, tetapi dengan biaya yang moderat.
-
-
DD bisa membantu pada periode idle yang panjang, tetapi ia membentuk ulang model noise dan bisa membatalkan asumsi ekstrapolasi atau inversi.
-
Pauli twirling tidak mengurangi noise. Ia membentuk ulang noise dan sering membuat teknik lain bekerja lebih baik (ZNE dan PEC).