Sumber daya komputasi dan manajemen sumber daya
Model sumber daya dan sumber daya klasikal
Dalam bagian ini, kita akan menyediakan kerangka untuk memikirkan lingkungan komputasi yang dapat diterapkan baik untuk laptop maupun yang ditingkatkan ke superkomputer. Pada akhir bagian ini, kamu akan memahami komponen fundamental dari lingkungan komputasi dan bagaimana mereka saling berhubungan. Semua ini dijelaskan oleh Iskandar Sitdikov dalam video berikut.
Model sumber daya
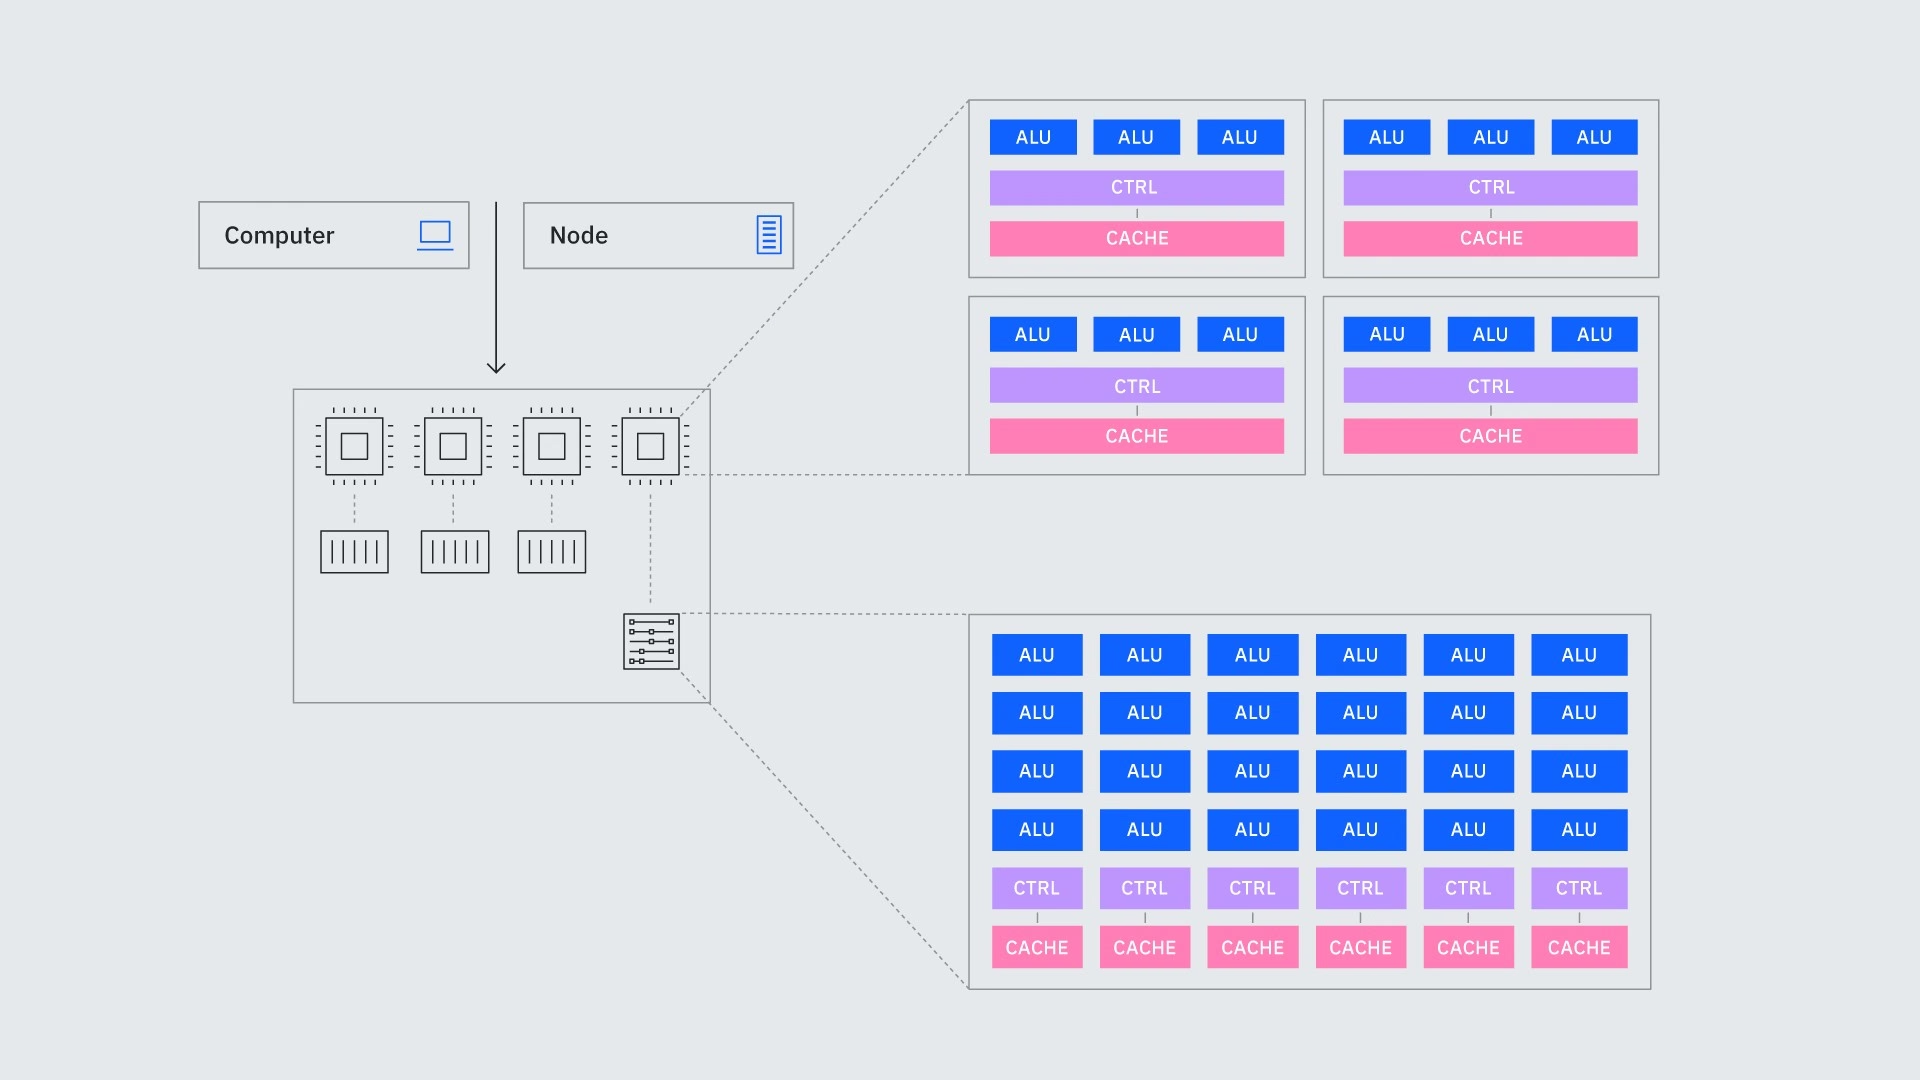
Setiap lingkungan komputasi klasikal dibangun dari beberapa sumber daya yang saling berhubungan yang bekerja sama untuk menjalankan aplikasi secara efisien. Sumber daya utama biasanya meliputi:
-
CPU (Central Processing Unit): CPU adalah unit pemrosesan inti yang menginterpretasikan dan mengeksekusi instruksi program. Ia menangani operasi logika, aritmatika, dan kontrol, secara esensial bertindak sebagai "otak" sistem.
-
Cache CPU (L1, L2, L3): Ini adalah yang tercepat dalam sistem, dibangun langsung ke dalam atau sangat dekat dengan inti CPU. Ia menyimpan porsi kecil data dan instruksi yang segera dibutuhkan CPU. Level yang berbeda (L1, L2, L3) merepresentasikan trade-off: L1 adalah yang terkecil dan tercepat sementara L3 adalah yang terbesar dan paling lambat, tetapi masih beberapa orde besaran lebih cepat dari RAM.
-
RAM (Random Access Memory): Memori volatile yang menyediakan penyimpanan sementara yang besar untuk instruksi program dan data yang sedang aktif digunakan. Ini memastikan CPU dapat dengan cepat mengakses informasi yang diperlukan selama eksekusi tanpa ketergantungan konstan pada perangkat penyimpanan yang lebih lambat.
-
Penyimpanan (lokal dan berbasis jaringan): Penyimpanan menyimpan data dan perangkat lunak bahkan saat sistem dimatikan, menyediakan persistensi jangka panjang untuk dataset dan aplikasi yang besar. Dalam komputasi berperforma tinggi, solusi penyimpanan harus menangani jumlah data ilmiah atau analitik yang sangat besar dengan kecepatan dan keandalan. Penyimpanan lokal termasuk solid-state drive (SSD) dan hard disk drive (HDD), dengan SSD yang lebih disukai karena latensi yang lebih rendah dan throughput yang lebih tinggi. Untuk penanganan data skala besar, sistem file paralel, penyimpanan jaringan bersama, dan sistem berbasis objek memungkinkan akses cepat di banyak node komputasi, sementara cloud dan tier penyimpanan arsip mendukung retensi jangka panjang dan skalabilitas.
-
GPU (Graphics Processing Unit): Meskipun awalnya dirancang untuk merender grafis, GPU modern adalah prosesor paralel yang kuat. Mereka banyak digunakan untuk menangani tugas yang memerlukan banyak kalkulasi simultan seperti deep learning, simulasi fisika, dan analitik big data. Penting untuk dicatat bahwa GPU tidak menggantikan CPU; CPU mengarahkan logika program yang lebih tinggi dan GPU mempercepat langkah-langkah yang sangat paralel.
-
Koneksi/Bus: Ini adalah jalur komunikasi yang menghubungkan CPU, memori, penyimpanan, dan periferal. Bus memungkinkan transfer data dan koordinasi antara bagian-bagian sistem, memastikan komunikasi yang lancar di seluruh lingkungan komputasi. Dalam sistem HPC, komponen seperti CPU, GPU, dan perangkat penyimpanan dihubungkan oleh interkoneksi berkecepatan tinggi yang memungkinkan pertukaran data yang cepat. GPU biasanya terhubung ke sistem melalui PCIe, antarmuka standar dengan beberapa jalur data untuk komunikasi yang efisien. Untuk performa yang lebih tinggi, NVLink menyediakan tautan langsung dan bandwidth tinggi antara GPU atau antara GPU dan CPU, mengurangi latensi dan mempercepat beban kerja paralel.
-
Filesystem: Filesystem mengorganisir data pada perangkat penyimpanan. Ia menyediakan struktur untuk menyimpan, mengambil, dan mengelola file, memungkinkan program dan pengguna mengakses informasi dengan cara yang konsisten dan logis.
Setiap jenis sumber daya memiliki satuan pengukuran kinerja sendiri. Misalnya, CPU biasanya diukur dengan "core" dan "kecepatan clock." Saat membeli laptop, spesifikasinya biasanya mencantumkan jumlah core. Konsep serupa berlaku untuk node komputasi di pusat data, di mana setiap node dikaitkan dengan jumlah core tertentu. Lingkungan komputasi yang menyertakan berbagai jenis sumber daya (CPU, GPU, bahkan QPU) disebut sebagai lingkungan komputasi heterogen. Setup semacam ini menangani beban kerja yang beragam dengan lebih efisien dengan memanfaatkan kekuatan masing-masing jenis prosesor. Misalnya, CPU digunakan untuk tugas umum dan GPU untuk pemrosesan paralel. Dalam konteks manajemen sumber daya dan penjadwalan - terutama untuk lingkungan komputasi heterogen - satuan pengukuran tambahan mungkin diperlukan selain yang dijelaskan di sini.
Untuk memori, satuan ukurnya adalah Mega/Giga/Terabyte.
Untuk kartu grafis dan akselerator lainnya, satuan ukurnya tergantung pada konteks. Sementara kemampuan komputasi sebenarnya diukur dengan metrik yang lebih halus - jumlah inti pemrosesan, ukuran memori, dan bandwidth memori, dalam diskusi tingkat tinggi tentang sumber daya cluster atau penjadwalan job, GPU dan akselerator serupa dapat dikuantifikasi di tingkat perangkat berdasarkan jumlah seluruh perangkat yang ditugaskan (misalnya, tiga GPU).
Jaringan/konektivitas/bus adalah aspek krusial dari infrastruktur komputasi mana pun karena mereka menentukan seberapa cepat data ditransfer antara komponen komputasi. Dari LPU ke cache CPU, ke RAM, ke kartu PCI, ke perangkat yang terhubung ke jaringan; semuanya adalah komunikasi dan sangat penting untuk memiliki model mental yang akurat tentang hal itu untuk merancang algoritma yang sangat dioptimalkan untuk HPC.
Skala sumber daya klasikal
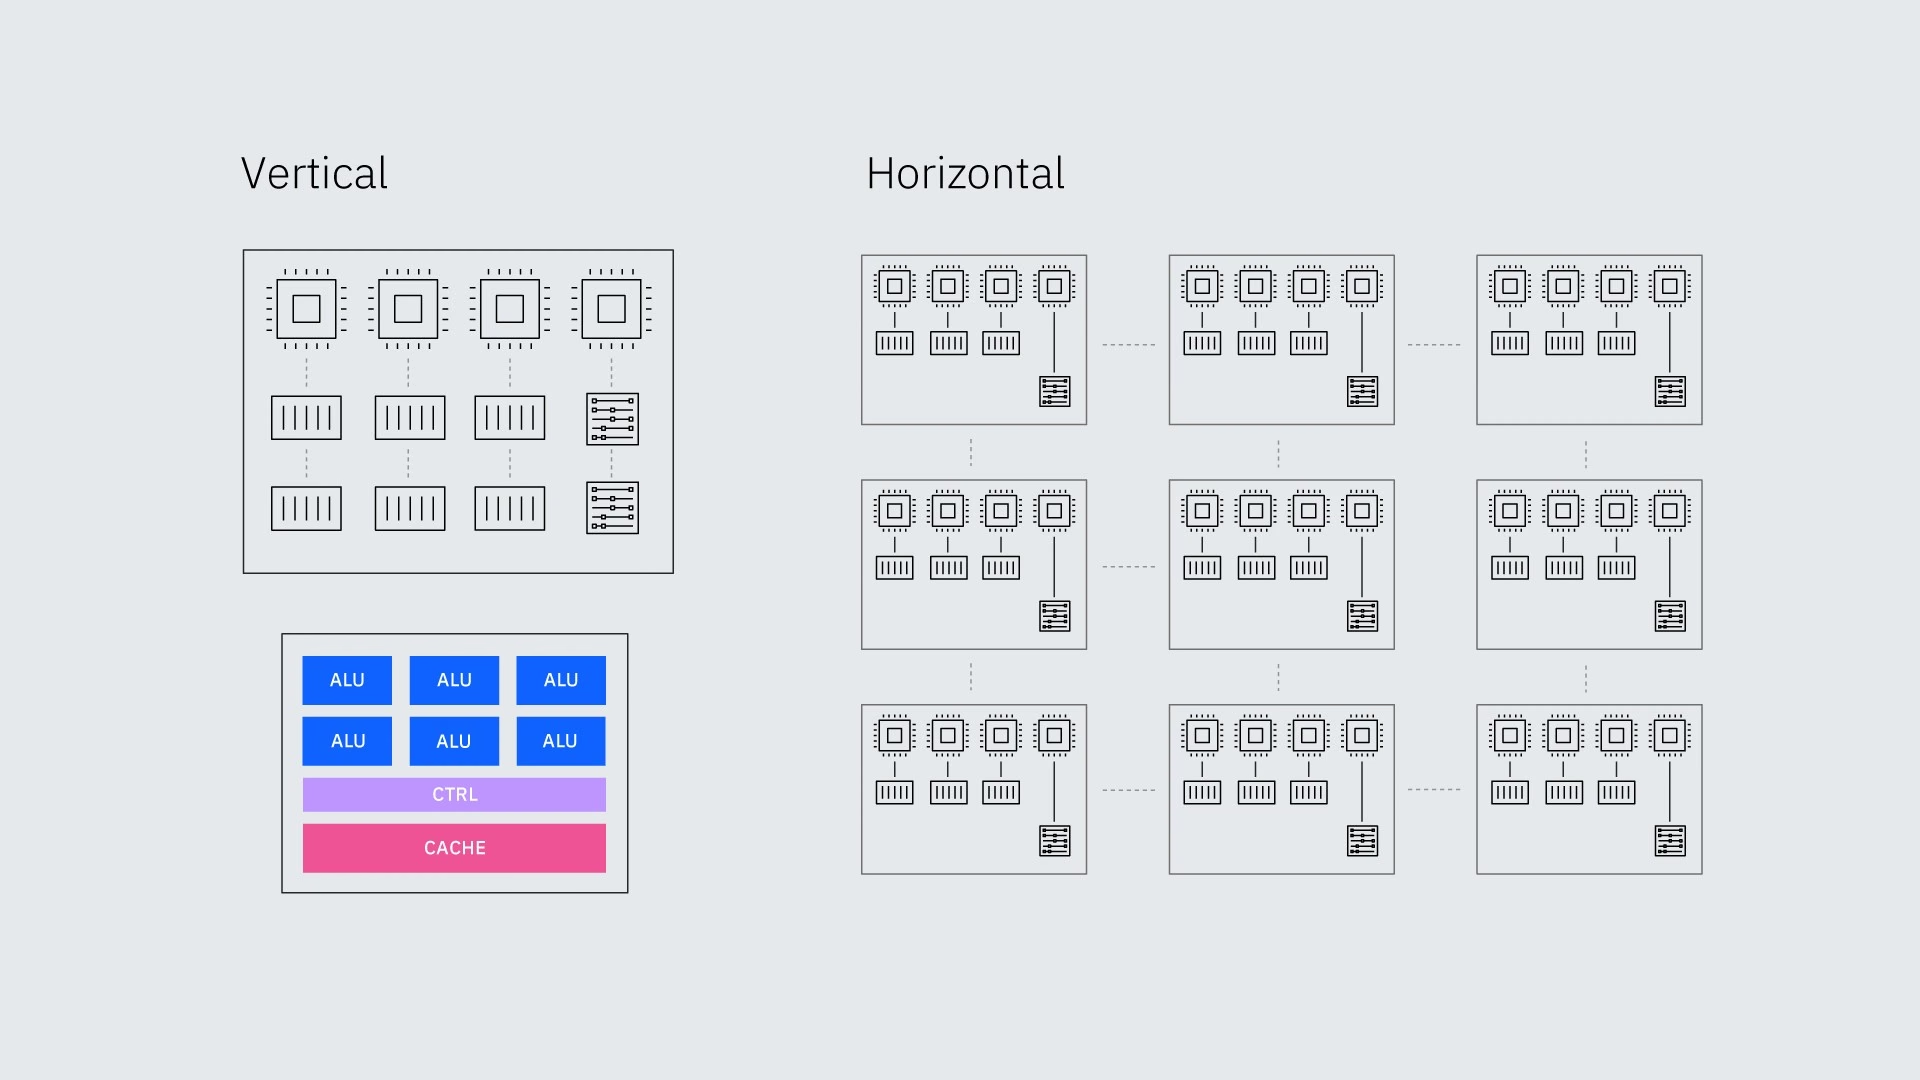
High-Performance Computing (HPC) melibatkan skala sumber daya klasikal ini untuk mencapai waktu pemrosesan yang lebih cepat atau meningkatkan data yang dapat ditangani secara bersamaan (misalnya, untuk meningkatkan ukuran ruang solusi yang dapat dicari). Ini dapat dicapai melalui:
-
Skala vertikal: Meningkatkan daya sumber daya individual, seperti menggunakan CPU yang lebih kuat atau menambahkan lebih banyak memori dalam satu node fisik, di mana node adalah unit cluster komputasi yang merangkum beberapa sumber daya komputasi di dalamnya.
-
Skala horizontal: Menambahkan lebih banyak sumber daya, seperti beberapa CPU atau GPU, untuk bekerja sama pada satu node atau, lebih umum, pada beberapa node, memungkinkan komputasi terdistribusi.
Beberapa konsep skala dari bagian ini akan berlaku untuk bagian berikutnya tentang sumber daya komputasi kuantum. Beberapa aspek lain dari sumber daya kuantum akan dikuantifikasi dengan cara baru.
Uji pemahamanmu
Gunakan deskripsi di atas untuk menyimpulkan beberapa keunggulan dan kelemahan dari pendekatan skala yang berbeda: vertikal dan horizontal?
Jawaban
Mungkin ada banyak jawaban yang benar. Skala vertikal sering lebih sederhana, terutama jika kamu memiliki beban kerja yang dapat diprediksi yang akan membutuhkan jumlah sumber daya yang tetap. Tetapi skala vertikal bisa lebih mahal untuk ditingkatkan, karena unit komputasi fundamental tidak dapat dipecah semudah dalam skala horizontal. Skala horizontal lebih kompleks untuk dikelola dan kadang-kadang ada kesulitan atau latensi yang terkait dengan koneksi antara node. Tetapi ini jauh lebih adaptif terhadap persyaratan sumber daya yang bervariasi dan bersifat modular ketika peningkatan diperlukan.
Jenis sumber daya baru: QPU (Quantum Processing Unit)
Dalam bagian ini, kita akan memperkenalkan jenis sumber daya baru - sumber daya kuantum - dan mengeksplorasi definisi, satuan ukur, dan konektivitasnya ke infrastruktur klasikal.
Definisi QPU
- Quantum processing unit (QPU): QPU mencakup semua hardware yang bertanggung jawab untuk menerima set instruksi kuantum yang dapat dieksekusi, atau rangkaian kuantum, dan mengembalikan jawaban yang akurat.
Itu berarti QPU mencakup satu atau lebih chip kuantum (misalnya Heron), berbagai komponen tambahan dalam dilution refrigerator seperti penguat kuantum, elektronik kontrol, dan komputasi klasikal yang diperlukan untuk tugas-tugas seperti menyimpan instruksi dan gelombang dalam memori, mengakumulasi hasil, dan dekoding koreksi kesalahan di masa depan. Meskipun dilution refrigerator diperlukan untuk melakukan tugas-tugas ini, kami mengecualikan dilution refrigerator dari definisi ini untuk memungkinkan kasus beberapa QPU dalam satu lemari pendingin.
-
Komputer kuantum: Komputer kuantum terdiri dari QPU ditambah komputasi klasikal yang menghosting lingkungan runtime.
-
Lingkungan runtime: Kombinasi hardware dan perangkat lunak yang memungkinkan jalannya program.
Lapisan dalam rangkaian kuantum
Dalam komputasi klasikal maupun kuantum, proses dapat dieksekusi secara berurutan atau paralel. Karena qubit memiliki ruang state yang kaya dibandingkan dengan bit klasikal, kadang-kadang masuk akal bagi beberapa gate qubit tunggal untuk dieksekusi pada qubit secara berurutan (seperti gate R_x diikuti oleh gate R_z). Karena keterikatan antara qubit sangat penting untuk komputasi kuantum, juga umum untuk rangkaian kuantum memiliki sekumpulan gate yang melilit yang bekerja di banyak qubit. Faktor-faktor ini dan lainnya membuat umum untuk mengidentifikasi proses yang dapat dieksekusi secara paralel pada skala operasi gate individual dalam rangkaian kuantum. Dalam komputasi klasikal, paralelisme tingkat bit juga mungkin tetapi kurang umum dipertimbangkan pada tingkat gate; lebih umum untuk merujuk pada proses paralel dan berurutan pada skala yang lebih besar.
Dalam komputasi kuantum, seseorang merujuk pada "lapisan" Gate yang semuanya dapat dieksekusi secara bersamaan. Dalam banyak aplikasi berguna untuk melakukan serangkaian rotasi pada semua Qubit dan kemudian Gate yang melilit antara pasangan Qubit. Dalam konteks ini, seseorang merujuk pada "lapisan rotasi" (lapisan Gate seperti R_x, R_y, dan/atau R_z) dan "lapisan entangling" (seperti satu dengan Gate CNOT). Jumlah lapisan dalam rangkaian adalah "kedalaman rangkaian", ukuran penting karena kedalaman yang lebih besar berarti lebih banyak lapisan noise dan kesalahan yang menumpuk.
Bisa sulit untuk mengidentifikasi lapisan gate secara visual ketika lapisan tidak disejajarkan menggunakan barrier. Di Qiskit, barrier berfungsi sebagai instruksi dalam rangkaian kuantum yang bertindak sebagai pemisah visual dan batasan selama kompilasi. Baik dalam menggambar rangkaian maupun mengeksekusinya, tidak ada gate yang akan dipindahkan melewati barrier. Ini bisa penting dalam konteks seperti dynamical decoupling, di mana seseorang dengan sengaja mengimplementasikan gate yang menyederhanakan ke identitas untuk menekan jenis kesalahan tertentu. Untuk lebih lanjut tentang dynamical decoupling lihat panduan ini. Untuk efek visual dari barrier, bandingkan dua gambar rangkaian yang sama ini, yang pertama tanpa barrier dan yang kedua dengan barrier untuk memaksa perataan lapisan.


Ini adalah rangkaian yang sama dan memiliki jumlah lapisan yang sama. Tetapi dalam yang kedua, perataan memudahkan untuk melihat bahwa rangkaian memiliki:
- Dua lapisan rotasi: satu di sekitar sumbu Y sebesar , satu di sekitar sumbu Z sebesar .
- Tiga lapisan entangling. Perhatikan bahwa seseorang dapat menyebut setiap CNOT sebagai "lapisan" tersendiri, karena CNOT tidak dapat diurutkan ulang untuk menjadi paralel tanpa mengubah operasi logisnya.
- Dua lapisan rotasi lagi: satu di sekitar sumbu Y sebesar , satu di sekitar sumbu Z sebesar .
- Dua lapisan entangling lagi. Perhatikan bahwa kali ini lapisan pertama telah sedikit lebih diparalelkan daripada dalam set pertama lapisan entangling.
Kedalaman setiap rangkaian adalah 9.
Satuan ukur
Dalam komputasi kuantum, kemampuan sistem kuantum sering digambarkan menggunakan tiga dimensi mendasar: skala, kualitas, dan kecepatan. IBM Quantum mengkarakterisasi dimensi-dimensi ini menggunakan tiga metrik perangkat keras yang dapat diterapkan di berbagai modalitas komputasi kuantum: qubit yang dapat diprogram (skala), operasi qubit (kualitas), dan jumlah maksimum Circuit per detik (kecepatan). Metrik-metrik ini memberikan gambaran tingkat tinggi tentang kemampuan komputasi dan efisiensi suatu sistem di berbagai implementasi perangkat keras.
-
Skala diukur dengan jumlah qubit yang dapat diprogram. Qubit yang dapat diprogram adalah qubit yang dapat dikontrol, dimanipulasi, diukur, dan dimasukkan langsung oleh pengguna ke dalam algoritma kuantum.
-
Kualitas diukur dengan operasi qubit (QuOps), sebuah metrik yang menggambarkan berapa banyak operasi yang paling menuntut secara komputasi yang dapat dijalankan secara andal oleh sistem sebelum error yang terakumulasi menguasai komputasi. Kemampuan QuOps yang lebih tinggi umumnya memungkinkan Circuit yang lebih dalam dan algoritma kuantum yang lebih canggih.
-
Kecepatan diukur dengan jumlah maksimum Circuit per detik, juga dikenal sebagai throughput Circuit. Metrik ini menangkap berapa banyak Circuit kuantum yang berguna yang dapat dijalankan sistem sepanjang waktu dan memberikan indikasi efisiensi komputasi secara keseluruhan.
Metrik perangkat keras tambahan sering digunakan untuk mengkarakterisasi aspek-aspek tertentu dari perilaku prosesor. Misalnya, EPLG (errors per layered gate) dan pengukuran layer-fidelity memberikan wawasan tentang kualitas Gate dan akumulasi error, sementara CLOPS (Circuit Layer Operations Per Second) mengukur kecepatan eksekusi beban kerja benchmarking kuantum yang terstandardisasi. Metrik-metrik ini tetap berguna untuk mengevaluasi beban kerja tertentu dan detail implementasi, tetapi qubit yang dapat diprogram, operasi qubit, dan jumlah maksimum Circuit per detik memberikan kerangka kerja yang lebih luas untuk membandingkan sistem kuantum.
Perbedaan antara metrik kuantum dan klasikal
Sistem komputasi klasik sering dikarakterisasi menggunakan metrik seperti FLOPS (floating-point operations per second), kapasitas memori, bandwidth memori, dan kecepatan clock prosesor. Beberapa analogi longgar dapat dibuat antara metrik-metrik ini dan metrik untuk komputer kuantum yang diperkenalkan di atas, tetapi perbedaan dalam metrik-metrik tersebut penting.
Jumlah maksimum Circuit per detik dapat dipandang sebagai analog longgar terhadap metrik kinerja yang berorientasi throughput dalam komputasi klasik karena mengukur seberapa banyak pekerjaan berguna yang dapat dilakukan sistem kuantum sepanjang waktu. Namun, tidak seperti FLOPS, metrik ini mengukur eksekusi Circuit kuantum, bukan operasi aritmatika.
CLOPS terkadang dibandingkan dengan benchmark throughput klasik seperti FLOPS, tetapi lebih baik dipahami sebagai benchmark khusus beban kerja daripada ukuran universal kinerja komputasi kuantum. EPLG dan pengukuran fidelity terkait memberikan wawasan tentang seberapa akurat sebuah prosesor menjalankan lapisan-lapisan Gate kuantum. Metrik-metrik ini berguna untuk memahami karakteristik perangkat keras tertentu, sementara kerangka kerja utama skala-kualitas-kecepatan memberikan basis yang lebih umum untuk membandingkan sistem kuantum. Banyak deskripsi tentang kinerja komputer kuantum dapat ditemukan di halaman Compute resources pada IBM Quantum Platform. Perlu dicatat bahwa meskipun jumlah qubit yang dapat diprogram adalah angka tetap untuk QPU tertentu, metrik kecepatan dan kualitas dapat sedikit bervariasi seiring waktu karena pembaruan kalibrasi, pemeliharaan, kondisi operasional, dan peningkatan infrastruktur perangkat keras dan perangkat lunak di sekitarnya.
Bersama-sama, metrik-metrik komplementer ini membantu memandu alokasi sumber daya, penjadwalan, dan desain aplikasi pada sistem komputasi kuantum.
Dalam banyak kasus, seluruh sistem kuantum diperlakukan sebagai satu unit. Namun, ketika tugas melebihi kapasitas satu unit—baik dalam hal jumlah Qubit yang dapat diprogram, kedalaman Circuit, atau throughput Circuit—teknik seperti pemotongan/penjahitan Circuit dapat digunakan. Pemotongan Circuit adalah proses memecah tugas kuantum yang besar menjadi sub-tugas yang lebih kecil dan dapat dikelola yang dapat didistribusikan di beberapa chip kuantum, memungkinkan komputasi kuantum yang skalabel meskipun ada keterbatasan hardware. Penjahitan Circuit mengacu pada proses yang datang setelah pemotongan Circuit — langkah pasca-pemrosesan klasikal yang "menjahit" atau menggabungkan hasil dari subCircuit yang lebih kecil kembali bersama.
Komputer kuantum tidak memiliki memori tradisional, dalam arti penyimpanan persisten dan dapat dialamatkan seperti RAM atau memori GPU. Sumber daya komputasi klasikal memiliki bit diskret yang tersimpan dalam memori, memungkinkan data untuk disimpan, diambil, dan digunakan kembali selama komputasi. Sumber daya kuantum menggunakan qubit yang tidak menyimpan memori dalam arti klasikal. Sebaliknya, qubit ada dalam state kuantum yang merepresentasikan superposisi 0 dan 1 secara bersamaan, memungkinkan paralelisme eksponensial dalam ruang state. Namun, state qubit bersifat rapuh dan tidak dapat di-clone atau dibaca secara deterministik pada langkah-langkah perantara tanpa meruntuhkan state kuantum, sehingga perilaku seperti memori persisten selama komputasi tidak ada. Qubit harus dijaga dalam state yang koheren sepanjang eksekusi, dan "memori" pada dasarnya adalah state kuantum itu sendiri. Memori klasikal hanya dapat digunakan bersama prosesor kuantum, bukan sebagai memori kuantum internal. Ini memiliki implikasi yang signifikan: sumber daya komputasi klasikal dapat menggunakan kembali dan menyimpan hasil perantara secara bebas; sumber daya kuantum tidak dapat melakukan ini tanpa pengukuran yang mengganggu komputasi.
Konektivitas ke infrastruktur klasikal
QPU dapat dihubungkan ke infrastruktur klasikal melalui jaringan dan berbagai antarmuka pemrograman aplikasi (API) yang memungkinkan pengembang perangkat lunak berinteraksi dengan QPU secara terprogram. API-API ini biasanya tersembunyi di balik software development kit (SDK) dan pustaka (seperti Qiskit) dan diekspos ke ilmuwan komputasional dalam bentuk abstraksi pemrograman (seperti primitif, yang akan kita bahas di Bab 3: model pemrograman).
Penting untuk membuat perbedaan antara integrasi ketat dan longgar dari sumber daya kuantum dan klasikal. Saat ini QPU tidak berada di node yang sama dengan sumber daya komputasi klasikal. Bahkan, QPU saat ini tidak terhubung melalui PCIe, tetapi melalui jaringan. Ini bisa berubah di masa depan, tetapi ada tantangan rekayasa yang terkait dengan kondisi lingkungan yang optimal untuk QPU dan sumber daya komputasi klasikal.
Skala sumber daya kuantum
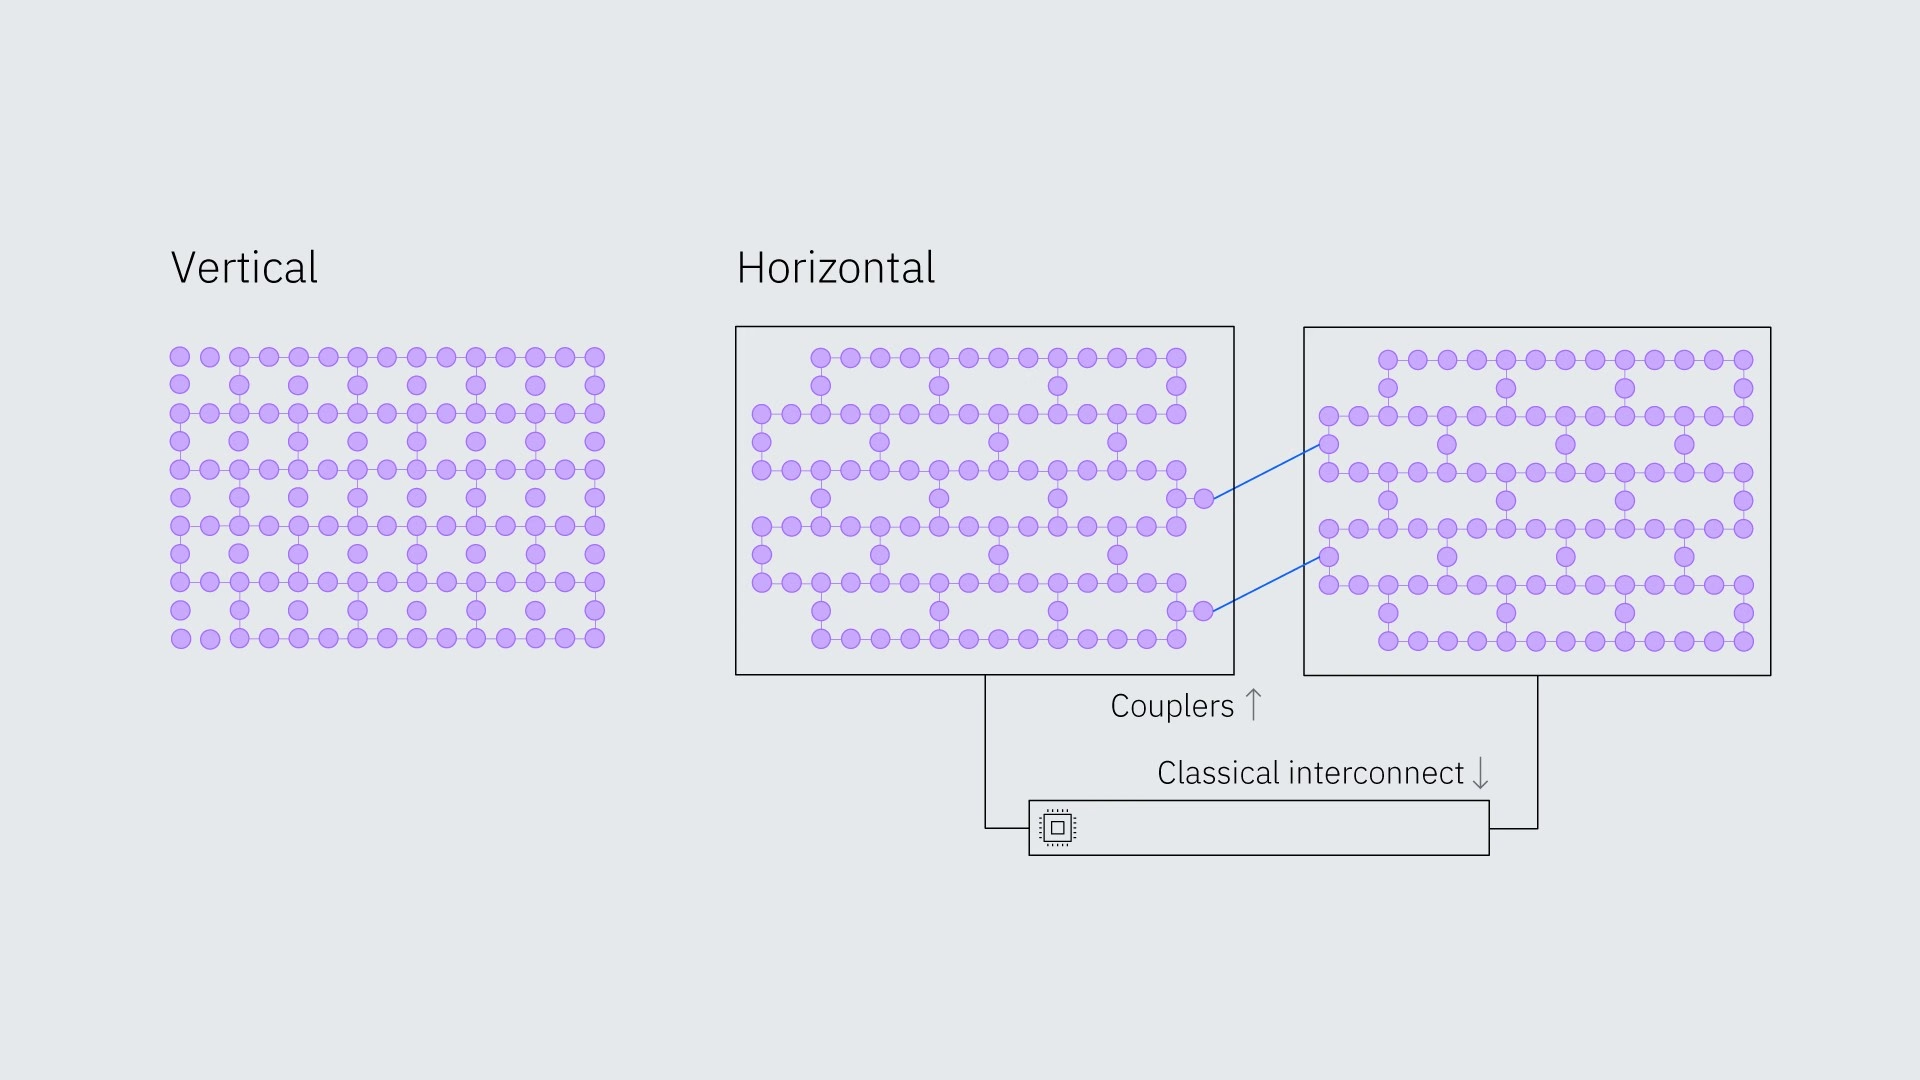
Skala sumber daya kuantum juga dapat dikategorikan menjadi vertikal dan horizontal.
-
Skala vertikal berarti meningkatkan jumlah qubit per chip atau meningkatkan fidelitas perangkat.
-
Skala horizontal berarti menghubungkan chip dengan coupler atau dengan interkoneksi klasikal.
Uji pemahaman Anda
Apa analog kuantum dari (a) bit informasi klasikal, dan (b) kecepatan prosesor klasikal?
Jawaban
(a) Bit kuantum atau qubit - unit informasi yang, tidak seperti padanan klasiknya (yang hanya bisa berada dalam keadaan 0 atau 1), dapat berada dalam superposisi 0 dan 1 secara bersamaan. (b) Circuit layer operations per second atau CLOPS - jumlah operasi berurutan yang dapat dilakukan QPU setiap detik, termasuk sebagian interaksi dengan sumber daya komputasi klasikal, misalnya saat memuat parameter dari rangkaian.
Manajemen sumber daya
Baik sumber daya HPC maupun kuantum sama-sama berharga dan kompleks; mereka harus dikelola dengan hati-hati. Dalam bagian ini, kita akan menjelaskan cara mengelola sumber daya untuk program pengguna. Manajemen sumber daya dalam infrastruktur komputasi mengacu pada proses (1) perencanaan, (2) alokasi, dan (3) kontrol/manajemen penggunaan sumber daya komputasi seperti CPU, memori, penyimpanan, dan bandwidth jaringan untuk memastikan utilisasi sumber daya yang efisien dan efektif.
Perencanaan - estimasi sumber daya
Setiap program mengonsumsi sumber daya, dan memperkirakan sumber daya yang diperlukan sangat penting untuk manajemen sumber daya yang efisien. Ini termasuk memperkirakan jumlah CPU, memori, dan sumber daya lain yang diperlukan untuk mengeksekusi program. Hal yang sama berlaku untuk sumber daya kuantum. Namun, sumber daya kuantum ada pada skala yang sama sekali berbeda. Prosesor kuantum IBM Quantum® Heron r3 memiliki 156 qubit, dibandingkan dengan miliaran bit klasikal pada laptop biasa. Waktu dan biaya juga menjadi pertimbangan. Saat ini, IBM Quantum memiliki paket gratis, Open Plan, yang memungkinkan pengguna untuk menjelajahi komputasi kuantum menggunakan 10 menit waktu QPU per bulan. Beberapa organisasi penelitian memerlukan waktu QPU yang begitu banyak sehingga mereka memiliki komputer kuantum IBM khusus di tempat.
Satu langkah dalam estimasi sumber daya yang unik untuk komputasi kuantum adalah kedalaman rangkaian. Seperti disebutkan sebelumnya, setiap gate kuantum dan setiap waktu tunda antara operasi memiliki noise dan probabilitas kesalahan tertentu. Semakin dalam rangkaian kuantum, semakin besar noisenya. Ada dua hal yang perlu diperhatikan: gate dua qubit memiliki tingkat kesalahan yang jauh lebih tinggi daripada gate satu qubit, sehingga seseorang sering dapat mengabaikan kedalaman satu qubit. Selanjutnya, tidak semua qubit pada chip kuantum langsung terhubung. Terkadang informasi harus ditukar dari qubit ke qubit untuk melakukan entanglement yang diperlukan dan proses pertukaran ini sendiri memerlukan gate dua qubit. Pertukaran tersebut ditangani dalam proses yang disebut "transpilasi", proses kompleks yang juga memiliki tujuan lain; ini dibahas lebih detail dalam pelajaran berikutnya. Kuantitas pembatas yang relevan adalah kedalaman dua qubit yang ditranspilasi. Kedalaman maksimum yang tepat di mana hasil fidelitas tinggi dapat diperoleh bergantung pada rangkaian. Tetapi memanfaatkan teknik mitigasi kesalahan modern, seseorang dapat memperoleh hasil fidelitas tinggi dengan kedalaman dua qubit yang ditranspilasi sebesar 80 atau lebih.
Alokasi - penjadwalan
Penjadwalan adalah proses mengalokasikan sumber daya ke program dan mengelola eksekusinya. Ini melibatkan:
- Pengiriman job: Proses di mana pengguna mengirimkan permintaan (job) ke sistem HPC, menentukan pekerjaan komputasional dan sumber daya apa yang diperlukan untuk eksekusi.
- Alokasi sumber daya: Penugasan sumber daya sistem HPC yang tersedia (seperti node, CPU, memori) ke job yang dikirimkan berdasarkan persyaratannya.
- Eksekusi job: Jalannya sebenarnya dari tugas komputasional yang didefinisikan oleh job pada sumber daya HPC yang dialokasikan.
Ada analog dari semua proses ini untuk komputer kuantum.
- Job dikirimkan oleh pengguna, memanfaatkan IBM Quantum Compute Service, dan biasanya menggunakan primitif IBM Quantum, seperti
Sampler,Estimator, atau lainnya. - Pengguna memilih dari daftar Backend yang dapat mereka akses. Daftar lengkap Backend yang tersedia dapat dilihat di halaman Compute resources di IBM Quantum Platform. Umum untuk cukup menggunakan komputer kuantum yang paling tidak sibuk. Tetapi ada kasus di mana mungkin penting untuk menggunakan yang spesifik karena pertimbangan tata letak perangkat, pengulangan perhitungan sebelumnya, dan sebagainya.
- Eksekusi job kuantum mirip dengan kasus HPC. Meskipun beberapa perbedaan telah diuraikan, beberapa layak diulang di sini. QPU saat ini umumnya tidak berlokasi di node yang sama dengan sumber daya komputasi klasikal tetapi terhubung melalui jaringan. Ini mungkin memiliki implikasi penjadwalan. Selanjutnya, komputer kuantum mungkin memiliki waktu antrian yang cukup lama, dan waktu antrian ini bervariasi, membuat kontrol waktu yang tepat menjadi sulit. Situasi ini mungkin berbeda untuk sistem yang didedikasikan; itu tergantung pada administrasi internal komputer kuantum.
Kontrol/Manajemen - manajemen beban kerja
Manajemen beban kerja, juga dikenal sebagai orkestrasi, adalah proses mengelola beberapa program dan persyaratan sumber daya mereka. Ini melibatkan:
- Provisi sumber daya: Proses mempersiapkan dan membuat sumber daya HPC tersedia dan siap digunakan oleh job, termasuk setup hardware dan perangkat lunak. Seperti yang akan kita lihat nanti, QPU adalah sumber daya komputasi yang dapat diprovisikan mirip dengan sumber daya HPC klasikal, dengan peringatan dari bagian sebelumnya.
- Penjadwalan job: Aktivitas perangkat lunak penjadwal dalam memutuskan job mana yang dijalankan, kapan, dan pada sumber daya mana, mengelola prioritas dan antrian untuk memanfaatkan sistem HPC secara efisien. Meskipun pernyataan luas ini berlaku untuk sumber daya kuantum, mungkin ada kontrol waktu yang lebih sedikit daripada sumber daya lainnya.
 Example:
Pertimbangkan tugas yang terkenal sebagai konteks untuk memahami manajemen sumber daya: menemukan faktor prima dari bilangan besar. Mari kita asumsikan lebih lanjut bahwa algoritma yang digunakan bergantung pada pengecekan brute force setiap pembagi potensial. Meskipun ini sering bukan metode yang paling efisien, mudah untuk memahami bagaimana beban kerja mungkin dikelola.
Perencanaan - estimasi sumber daya
-
Perkirakan berapa banyak waktu CPU dan memori yang mungkin diperlukan faktorisasi prima.
-
Rencanakan paralelisasi tugasmu - berapa banyak CPU/inti yang akan kamu gunakan?
Alokasi - penjadwalan
-
Setelah pengiriman job, penjadwal menugaskan inti CPU dan memori ke tugas faktorisasi prima. Misalnya, mungkin mengalokasikan semua pembagi potensial yang berakhir dengan digit
1, 3, 7, 9ke salah satu dari empat inti, masing-masing. -
Eksekusi job: Algoritma faktorisasi prima berjalan, melakukan pembagian atau langkah faktorisasi lainnya pada sumber daya yang dialokasikan hingga tugas selesai.
Kontrol/Manajemen - manajemen beban kerja
-
Sistem mengorkestra urutan dan waktu dari job faktorisasi prima untuk mengoptimalkan throughput.
-
Kasus termudah untuk dibayangkan adalah bahwa salah satu inti menemukan faktor prima target. Ini harus menghentikan perhitungan pada inti lain sehingga mereka dapat digunakan untuk tugas berikutnya.
Lingkungan high-performance computing menggunakan perangkat lunak khusus untuk menjalankan langkah-langkah ini dan mengelola sumber daya. Dalam bagian berikutnya, kita akan mempelajari tentang sistem perangkat lunak manajemen sumber daya yang banyak digunakan: Slurm.
Contoh dengan sumber daya kuantum:
Alur kerja yang akan menjadi subjek pelajaran lain dalam kursus ini adalah menentukan ground state dan energi kimia menggunakan sample-based quantum diagonalization (SQD). Ini dibahas lebih detail dalam Pelajaran 4, dan kamu juga bisa mengunjungi kursus tentang SQD ini dan metode terkait di IBM Quantum Learning. Yang perlu kita ketahui untuk diskusi ini adalah bahwa alur kerja melibatkan yang berikut:
- Siapkan rangkaian kuantum
- Ukur rangkaian kuantum
- Gunakan hasil pengukuran untuk memproyeksikan masalah ke subruang yang berguna
- Diagonalisasi matriks yang lebih kecil dan diproyeksikan menggunakan sumber daya komputasi klasikal
- Iterasi, baik untuk memastikan konsistensi diri melalui pertimbangan seperti konservasi muatan, dan kemungkinan iterasi dari rangkaian kuantum jika memiliki parameter variasional.
Perencanaan - estimasi sumber daya
-
Petakan orbital elektronik ke qubit untuk menetapkan jumlah qubit yang kamu butuhkan.
-
Kombinasikan Hamiltonian sistem yang dipetakan dan state (mungkin variasional) ke dalam rangkaian kuantum dan periksa kedalaman dua qubit yang ditranspilasi. Pastikan ini wajar.
-
Perkirakan ukuran subruang ke mana kamu akan memproyeksikan; dari ini, perkirakan berapa banyak waktu CPU dan memori yang mungkin diperlukan diagonalisasi.
-
Rencanakan paralelisasi tugasmu - berapa banyak CPU/inti yang akan kamu gunakan?
Alokasi - penjadwalan
-
Pengguna memilih QPU; proses transpilasi secara otomatis memetakan qubit dalam rangkaian kuantum abstrak kamu ke qubit fisik pada QPU. Ini penting karena rangkaian abstrak mungkin mengasumsikan konektivitas langsung yang tidak ada pada chip, di antara alasan lainnya.
-
Setelah pengiriman job melalui Quantum Compute, job memasuki antrian untuk QPU yang dipilih. Pengguna tidak memiliki kontrol atas waktu antrian, meskipun ini mungkin berbeda untuk sistem yang didedikasikan.
-
Sumber daya komputasi klasikal menunggu hasil kuantum.
-
Job diagonalisasi dikirimkan ke sumber daya HPC; setelah pengiriman job, penjadwal menugaskan inti CPU dan memori ke tugas diagonalisasi.
-
Eksekusi job: Algoritma diagonalisasi berjalan, mendiagonalisasi matriks yang diproyeksikan lebih kecil hingga tugas selesai.
Kontrol/Manajemen - manajemen beban kerja
-
Sistem mengorkestra urutan dan waktu langkah-langkah kuantum dan klasikal sepanjang waktu. Misalnya, setelah matriks yang diproyeksikan telah didiagonalisasi dan energi ground state diperoleh, tergantung pada kriteria konvergensi, alur kerja mungkin kembali ke rangkaian kuantum baru (dengan parameter variasional baru).
-
Ketika kriteria konvergensi dipenuhi oleh energi ground state, perhitungan pada semua inti berhenti.
Lingkungan high-performance computing menggunakan perangkat lunak khusus untuk menjalankan langkah-langkah ini dan mengelola sumber daya. Dalam bagian berikutnya, kita akan mempelajari tentang sistem perangkat lunak manajemen sumber daya yang banyak digunakan: Slurm. Penting untuk dicatat bahwa Slurm tidak memiliki alat untuk semua langkah yang dijelaskan di atas. Slurm tidak menyediakan dukungan untuk perencanaan job, maupun manajemen beban kerja terperinci seperti komunikasi antara komponen beban kerja. Ini sangat cocok dengan keadaan komputasi kuantum saat ini di HPC, karena QPU biasanya diakses melalui jaringan.
Uji pemahaman Anda
Anggaplah Anda mencoba mencari database yang tidak terurut untuk menemukan sebuah elemen yang akan kita sebut 'target'. Untuk setiap tindakan berikut, nyatakan tahap manajemen sumber daya mana yang sesuai:
(a) Memperkirakan ukuran database dan waktu yang dibutuhkan untuk memeriksa setiap elemen
(b) Memastikan bahwa menemukan target di satu GPU menghentikan proses di GPU lain untuk membebaskannya untuk masalah berikutnya
(c) Membagi ruang pencarian menjadi beberapa wilayah untuk setiap (katakanlah 10) GPU Anda untuk mencari
Jawaban
(a) Planning
(b) Kontrol/manajemen
(c) Alokasi/penjadwalan
Perangkat lunak: Slurm
Dalam bagian ini, kita akan menerapkan konsep yang dipelajari dalam bab ini untuk mempraktikkan penggunaan sistem manajemen sumber daya populer, Slurm.
Pengantar Slurm
Slurm adalah sistem manajemen sumber daya open-source yang banyak digunakan dalam lingkungan high-performance computing. Ia menyediakan seperangkat alat komprehensif untuk mengelola sumber daya, menjadwalkan job, dan memantau kinerja sistem.
Kita akan membahas dasar-dasar penggunaan Slurm, termasuk:
- Pengiriman job
- Alokasi sumber daya
- Pemantauan job
Karena sangat sulit untuk menyediakan sumber daya HPC kepada setiap mahasiswa kursus ini, kita akan sedikit menipu dan menyediakan repositori dengan image Docker yang meniru cluster HPC aktual dengan Slurm, tetapi dalam skala kecil. Ini akan membantu kita untuk mempraktikkan konsep yang dipelajari dalam lingkungan yang aman dan dapat direproduksi.
Perhatikan bahwa saat ini semua sumber daya kuantum dan klasikal dialokasikan untuk durasi seluruh eksperimen. Saat ini tidak ada alokasi sumber daya campuran yang diselingi. Peringatan terakhir adalah bahwa bahkan setelah job diluncurkan, sistem kuantum tidak akan dikontrol secara langsung seperti yang mungkin diharapkan pengguna HPC yang sering. Job diluncurkan pada node x86 sewenang-wenang, yang mengeksekusi IBM Quantum Compute Service dan layanan runtime tersebut terhubung ke penjadwal lain yang tidak memiliki kontrol langsung dari pengguna. Alur kerja dan masalah terkait ini mungkin dikenal oleh pengguna HPC yang memiliki pengalaman awal dalam mengejar akses eksklusif ke node GPU (penggunaan asli gres).
Instruksi instalasi dan gambaran umum setup
Untuk mempraktikkan kombinasi sumber daya kuantum dan HPC, kamu memerlukan akses ke lingkungan HPC nyata atau perlu mensimulasikan lingkungan HPC pada mesin lokalmu. Panduan instalasi untuk setup lokal menggunakan Docker dapat ditemukan di repositori ini. Panduan tersebut menghubungkan ke dukungan untuk menyiapkan akun IBM Cloud® dan menginstal plugin SPANK untuk QRMI. Juga dalam repositori tersebut adalah beberapa file Python untuk menguji lingkunganmu.
Setelah kamu menyelesaikan instalasi, mari gunakan perintah di bawah ini untuk memeriksa sumber daya komputasi Slurm di terminalmu. Jika instalasi berhasil, kamu harus dapat mengonfirmasi total tiga node virtual.
$ sinfo

PARTITION AVAIL TIMELIMIT NODES STATE NODELIST
normal      up 5-00:00:00     2  idle c[1-2]
quantum*    up   infinite     1  idle q1
$ scontrol show node

NodeNAME=q1 Arch=x86_64 CoresPerSocket=1
CPUAlloc=0 CPUTot=1 CPULoad=0.34
AvailableFeatures=(null)
ActiveFeatures=(null)
Gres=qpu:1
NodeAddr=q1 NodeHostName=q1 Version=21.08.6
...
Kita memiliki dua partisi atau kelompok node: normal dan quantum. Partisi normal terdiri dari node yang hanya memiliki akses ke sumber daya klasikal. Partisi quantum memiliki akses ke sumber daya kuantum. Kamu bisa melihat detail setiap node dengan mengeksekusi scontrol show nodes.
Jalankan contoh hello world sederhana di Slurm
Mari kita jalankan terlebih dahulu contoh hello world klasikal sederhana dengan Slurm. Kita akan menggunakan Python untuk contoh-contoh. Mari buat hello_world.py, yang sudah cukup jelas.
$ vim hello_world.py

import time
time.sleep(10)
print("Hello, World!")
~
Sekarang kita perlu memberi tahu manajer sumber daya sumber daya apa yang kita butuhkan untuk mengeksekusi program ini. Slurm menyediakan cara untuk menentukan semua metadata untuk job melalui skrip pengiriman, yang hanyalah skrip shell dengan anotasi khusus Slurm. Anotasi-anotasi ini memungkinkan kamu untuk menentukan persyaratan sumber daya, parameter jadwal, dan banyak lagi. Mari buat skrip shell hello_world.sh untuk ini.
$ vim hello_world.sh

#SBATCH --job-name=hello-world
#SBATCH --output=hello-world.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=normal

srun hello_world.py
~
Mari tinjau file pengiriman dan lihat apa yang terjadi di sini.
Direktif #SBATCH adalah anotasi khusus untuk memberi tahu persyaratan apa yang kita miliki untuk eksekusi program. Di sini kamu bisa menentukan jumlah sumber daya - jumlah node, jumlah tugas per node, jumlah tugas dan CPU per node dan tugas - dan opsi lain seperti nama file output. Daftar lengkap opsi tersedia dalam dokumentasi untuk Slurm.
Sekarang saatnya menjalankan job Slurm kita. sbatch adalah perintah yang menerima file pengiriman dan memasukkan job ke antrian untuk eksekusi di Slurm.
$ sbatch hello_world.sh

Submitted batch job 63
Mari periksa status program kita menggunakan perintah squeue.
$ squeue

#             JOBID PARTITION     NAME         USER ST       TIME  NODES NODELIST(REASON)
#                 1 main          hello_world  root R        0:01      1 c1
Setelah job selesai, kita bisa memeriksa hasilnya dengan melihat file output.
$ cat hello_world_logs.txt
Hello, World!
Uji pemahaman Anda
Diberikan skrip shell Slurm di bawah ini, apa (a) nama pekerjaan (job), (b) nama file Python, dan (c) nama file output? (d) Terakhir, bisakah ini menggunakan sumber daya kuantum atau tidak?
vim hello_learner.sh

#SBATCH --job-name=hello-learner
#SBATCH --output=hello-learner.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=quantum

srun hello_learner_qm.py
Jawaban
(a) hello-learner
(b) hello-learner_qm.py
(c) hello-learner.out
(d) Ya, bisa. Ini menggunakan partisi quantum.
Jalankan contoh Qiskit hello world sederhana di Slurm
Selanjutnya, mari coba menggunakan sumber daya kuantum juga. Mari buat dan jalankan program "Hello, Qiskit" sederhana yang menggunakan sumber daya kuantum.
$ vim hello_qiskit.py
# hello_qiskit.py
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import EstimatorV2 as Estimator

# Create a new circuit with two qubits
qc = QuantumCircuit(2)

# Add a Hadamard gate to qubit 0
qc.h(0)

# Perform a controlled-X gate on qubit 1, controlled by qubit 0
qc.cx(0, 1)

observables_labels = ["IZ", "IX", "ZI", "XI", "ZZ", "XX"]
observables = [SparsePauliOp(label) for label in observables_labels]

# switch to QRMI service
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()

backend = service.backend("...")

# Convert to an ISA circuit and layout-mapped observables.
pm = generate_preset_pass_manager(backend=backend, optimization_level=1)
isa_circuit = pm.run(qc)

# Construct the Estimator instance.

estimator = Estimator(mode=backend)
estimator.options.resilience_level = 1
estimator.options.default_shots = 5000

mapped_observables = [
    observable.apply_layout(isa_circuit.layout) for observable in observables
]

# One pub, with one circuit to run against five different observables.
job = estimator.run([(isa_circuit, mapped_observables)])

job_result = job.result()

pub_result = job.result()[0]

print("Result", pub_result)
Di sini kita akan menggunakan antarmuka manajemen sumber daya kuantum (QRMI), plugin Slurm SPANK untuk dukungan sumber daya dan job kuantum yang dikembangkan bersama oleh IBM, Pasqal, The Hartree Center, dan RPI. Kita membuat rangkaian pauli-2-design sederhana dengan nilai awal acak dan observabel sederhana, dan kita akan menjalankannya menggunakan Estimator untuk mendapatkan nilai ekspektasi. Untuk menjalankannya kita akan membutuhkan lagi skrip pengiriman hello_qiskit.sh, yang akan memiliki sumber daya kuantum sebagai persyaratan.
$ vim hello_qiskit.sh

#SBATCH --job-name=hello-qiskit
#SBATCH --output=hello_qiskit.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-nodes=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=quantum
#SBATCH --gres=qpu:1

srun python /data/ch2/hello_qiskit/hello_qiskit.py
~
Mari tinjau file pengiriman dan lihat apa yang terjadi di sana. Kita memiliki satu opsi baru, yaitu gres. gres adalah opsi Slurm untuk mendefinisikan sumber daya komputasi tambahan. Dalam kasus kita, sumber daya baru ini adalah sumber daya kuantum kita. Karena kita menentukan sumber daya dan partisi dari cluster kita di mana sumber daya kuantum tersedia, primitif IBM Quantum kita akan menggunakan sumber daya yang dialokasikan ini untuk mengeksekusi payload kuantum.
Sekarang saatnya menjalankan job Slurm kita.
$ sbatch hello_qiskit.sh
Kemudian, mari periksa status program kita menggunakan perintah squeue.
$ squeue
#             JOBID PARTITION     NAME         USER ST       TIME  NODES NODELIST(REASON)
#                 1 main          hello_qiskit  root R        0:01      1 q1
Kita bisa menjelajahi log dan hasil setelah job selesai.
$ cat hello_qiskit.out | grep Exp
Expectation Value: 0.8372900070983516
Ringkasan
Sejauh ini, kita telah belajar apa itu sumber daya komputasi dan bagaimana menggunakannya untuk menjalankan program dalam lingkungan heterogen. Kita juga telah membuat dan mengeksekusi dua program 'Hello World' sederhana: satu untuk sumber daya klasikal dan yang lain untuk sumber daya kuantum, dan kita telah belajar cara membuat skrip shell untuk mengirimkan tugas dan melihat hasil.
Dalam pelajaran berikutnya, kita akan membangun pengetahuan tentang kontrol sumber daya ini untuk menerapkan model pemrograman ke sumber daya yang kita peroleh selama eksekusi job.
Semua kode dan skrip yang digunakan dalam bab ini tersedia untukmu dalam repositori GitHub kami.